
Integrated Research Capability in the AI Era: Developing a Research Capability Architecture and an Empirical Validation Framework for University Students
NGUYỄN VĂN HÙNG
HIGHLIGHTS
- Phát triển Research Capability Architecture (RCA) gồm bảy miền năng lực cho nghiên cứu trong kỷ nguyên AI.
- Khái niệm hóa Integrated Research Capability (IRC) như một cấu trúc năng lực bậc cao có thể kiểm định.
- Phân biệt AI–Research Literacy với phán đoán khoa học, liêm chính và trách nhiệm giải trình.
- Kết hợp thang tự báo cáo với performance-based assessment trong chương trình kiểm định năng lực.
- Đề xuất mô hình scientifically governed human–AI research lấy quyền chủ thể và trách nhiệm khoa học của con người làm nền tảng.
TÓM TẮT
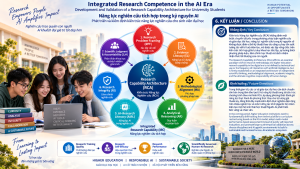
Sự phổ biến nhanh chóng của trí tuệ nhân tạo tạo sinh (Generative Artificial Intelligence – GenAI) đang tái cấu trúc nhiều hoạt động của chu trình nghiên cứu trong giáo dục đại học, từ xác lập vấn đề, tìm kiếm và tổng hợp tài liệu, xây dựng thiết kế, lập trình phân tích dữ liệu đến diễn giải và truyền thông kết quả. Tuy nhiên, khả năng sử dụng AI không đồng nghĩa với năng lực nghiên cứu. Phần lớn các công cụ đo hiện hành tập trung riêng lẻ vào research competence, research self-efficacy, information literacy, digital competence hoặc AI literacy, trong khi chưa phản ánh đầy đủ khả năng phối hợp vấn đề, bằng chứng, phương pháp, suy luận, công nghệ, liêm chính và trách nhiệm khoa học trong một kiến trúc thống nhất. Bài viết phát triển Research Capability Architecture (RCA), gồm bảy miền năng lực bậc một: Research Problem Framing (RPF), Evidence Literacy (EL), Methodological Alignment (MA), Analytical Reasoning (AR), AI–Research Literacy (AIRL), Research Integrity (RI), và Scientific Judgment & Accountability (SJA). Bảy miền được giả thuyết phản ánh một cấu trúc bậc cao hơn, Integrated Research Capability (IRC), nhưng giả thuyết này được xem là có thể phản bác và phải được kiểm định với các mô hình cạnh tranh.
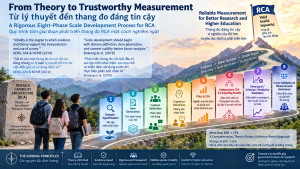
Bài viết đề xuất chương trình phát triển và kiểm định RCA gồm tám giai đoạn: xác lập miền khái niệm; tạo ngân hàng mục hỏi; thẩm định nội dung; phỏng vấn nhận thức; nghiên cứu thí điểm và phân tích nhân tố khám phá; phân tích nhân tố khẳng định trên mẫu độc lập và so sánh mô hình; kiểm định nomological, criterion và predictive validity; và kiểm định chéo cùng measurement invariance. RCA được thiết kế như một hệ thống đánh giá hai chế độ, kết hợp self-reported capability với Research Design Performance Task nhằm giảm nguy cơ đồng nhất năng lực cảm nhận với năng lực biểu hiện thực tế. Mạng lưới nomological dự kiến kiểm định mối liên hệ giữa Research Training Quality, IRC, Research Self-Efficacy, Research Performance và Research Impact Readiness. Một nhánh kiểm định bổ sung đánh giá liệu SJA có giải thích thêm Responsible AI Research Use sau khi AIRL đã được kiểm soát hay không.
Đóng góp lý thuyết cốt lõi của RCA là chuyển cách tiếp cận từ danh mục kỹ năng nghiên cứu sang kiến trúc năng lực tích hợp, trong đó AI được định vị như một thành phần của năng lực nghiên cứu thay vì trung tâm thay thế các năng lực khoa học khác. RCA cho rằng AI có thể mở rộng khả năng thực hiện nhưng không tự động bảo đảm chất lượng bằng chứng, sự phù hợp phương pháp, tính hợp lệ của suy luận, liêm chính hoặc trách nhiệm nhận thức. Bài viết vì vậy đề xuất một mô hình nghiên cứu Người–AI trong đó sự gia tăng tự động hóa phải đi cùng với năng lực kiểm chứng, phán đoán, giám sát và trách nhiệm khoa học mạnh hơn của con người.
Từ khóa: research capability; research competence; AI literacy; generative AI; scientific reasoning; research integrity; higher education; scale development; scientific judgment; human–AI research.
ABSTRACT
The rapid diffusion of generative artificial intelligence (GenAI) is reshaping multiple stages of the research process in higher education, including problem formulation, literature retrieval and synthesis, research design, analytical programming, data interpretation, and the communication of findings. However, the ability to use AI does not necessarily constitute research capability. Existing measurement instruments typically assess research competence, research self-efficacy, information literacy, digital competence, or AI literacy as relatively distinct constructs and therefore do not fully capture the capacity to coordinate research problems, evidence, methodology, reasoning, technology, integrity, and scientific accountability within a unified architecture. This article develops the Research Capability Architecture (RCA), comprising seven first-order domains: Research Problem Framing (RPF), Evidence Literacy (EL), Methodological Alignment (MA), Analytical Reasoning (AR), AI–Research Literacy (AIRL), Research Integrity (RI), and Scientific Judgment & Accountability (SJA). These seven domains are hypothesized to reflect a higher-order construct, Integrated Research Capability (IRC); however, this proposition is explicitly treated as falsifiable and must be evaluated against competing measurement models.
The article proposes an eight-stage program for developing and validating the RCA: construct-domain specification; item-pool generation; content validation; cognitive interviewing; pilot testing and exploratory factor analysis; confirmatory factor analysis using an independent sample and competing-model comparison; nomological, criterion, and predictive validation; and cross-validation together with measurement invariance testing. The RCA is designed as a dual-mode assessment system that combines self-reported capability with a Research Design Performance Task, thereby reducing the risk of conflating perceived competence with demonstrated capability. The proposed nomological network examines the relationships among Research Training Quality, IRC, Research Self-Efficacy, Research Performance, and Research Impact Readiness. An additional validation branch tests whether SJA explains incremental variance in Responsible AI Research Use after AIRL has been statistically controlled.
The central theoretical contribution of the RCA is to shift the conceptualization of research competence from a collection of discrete research skills toward an integrated capability architecture in which AI is embedded as one component of research capability rather than positioned as a substitute for other scientific competencies. The framework argues that AI may extend researchers’ capacity to perform research tasks, but it does not automatically ensure evidential quality, methodological alignment, valid inference, research integrity, or epistemic accountability. The article therefore advances a model of human–AI research in which increasing automation must be accompanied by stronger human capabilities for verification, scientific judgment, meaningful oversight, and accountability.
Keywords: research capability; research competence; AI literacy; generative AI; scientific reasoning; research integrity; higher education; scale development; scientific judgment; human–AI research.
- GIỚI THIỆU
1.1. Từ kỹ năng nghiên cứu truyền thống đến năng lực nghiên cứu Người–AI
Trí tuệ nhân tạo đang làm thay đổi điều kiện nhận thức, kỹ thuật và tổ chức của nghiên cứu khoa học. Trong giáo dục đại học, nhiều hoạt động trước đây đòi hỏi sinh viên hoặc nhà nghiên cứu trực tiếp thực hiện — xây dựng từ khóa, tìm tài liệu, tóm tắt bằng chứng, gợi ý câu hỏi nghiên cứu, viết mã thống kê, hỗ trợ coding dữ liệu định tính, trực quan hóa dữ liệu và biên tập văn bản — hiện có thể được các hệ thống AI hỗ trợ với chi phí thời gian rất thấp. Vì vậy, GenAI không đơn thuần bổ sung một công cụ vào bộ công cụ nghiên cứu; nó làm thay đổi cách lao động nhận thức được phân bổ giữa con người và hệ thống tính toán.
Sự thay đổi này tạo ra một nghịch lý. Một mặt, AI làm giảm rào cản kỹ thuật, mở rộng khả năng tiếp cận phương pháp, hỗ trợ người học khám phá phương án và có thể nâng cao năng suất nghiên cứu. Mặt khác, sự trôi chảy và tốc độ của output AI có thể che giấu việc người sử dụng chưa thực sự hiểu logic của quyết định nghiên cứu. Một sinh viên có thể tạo mã hồi quy chính xác nhưng không giải thích được vì sao hồi quy là lựa chọn phù hợp; có thể tạo tổng quan tài liệu mạch lạc nhưng chưa xác minh nguồn; hoặc có thể viết một phần thảo luận thuyết phục trong khi claim vượt quá giới hạn thiết kế nghiên cứu.
Klein và Klein (2025) mô tả nguy cơ này bằng khái niệm hollowed mind, trong đó việc tiếp cận các câu trả lời có chất lượng cao với ít nỗ lực có thể khiến người sử dụng bỏ qua những quá trình nhận thức cần thiết cho việc phát triển cấu trúc tri thức nội tại và phán đoán độc lập. Điều này đặc biệt quan trọng trong nghiên cứu khoa học bởi khoa học không chỉ yêu cầu tạo ra output mà còn yêu cầu giải trình tại sao một claim được phép hình thành từ một tập hợp bằng chứng cụ thể.
Do đó, sự phát triển năng lực nghiên cứu trong kỷ nguyên AI có thể được khái niệm hóa theo quá trình chuyển dịch:
Traditional Research Skills → AI-Augmented Research → Scientifically Governed Human–AI Research Capability.
Ở trạng thái thứ ba, người nghiên cứu không chỉ biết thực hiện thao tác hoặc sử dụng AI để gia tăng hiệu suất. Họ phải biết nhiệm vụ nào có thể giao cho AI, khi nào cần kiểm chứng độc lập, nguồn bằng chứng nào cần truy nguyên, output nào phải bác bỏ, giới hạn nào phải được công bố và ai chịu trách nhiệm cuối cùng đối với kết luận khoa học.
Từ đó, bài viết đặt ra luận điểm trung tâm:
Năng lực nghiên cứu trong kỷ nguyên AI không được xác định bởi khả năng tạo ra câu trả lời với AI, mà bởi khả năng đặt vấn đề khoa học, đánh giá bằng chứng, duy trì sự phù hợp phương pháp, suy luận trong giới hạn dữ liệu, quản trị việc sử dụng AI và chịu trách nhiệm đối với những tuyên bố tri thức được tạo ra.
Luận điểm này yêu cầu mở rộng từ khái niệm research skill và research competence sang research capability. Capability nhấn mạnh không chỉ sự sở hữu kỹ năng mà cả khả năng huy động, phối hợp, hiệu chỉnh và tái cấu hình những năng lực thành phần trước những tình huống mới, phức tạp hoặc bất định.
1.2. Khoảng trống thứ nhất: năng lực nghiên cứu đang được đo lường theo các cấu phần phân mảnh
Nghiên cứu về năng lực nghiên cứu trong giáo dục đại học đã phát triển nhiều cấu trúc có giá trị, bao gồm methodological knowledge, information literacy, scientific reasoning, quantitative competence, academic writing và research self-efficacy. Mỗi cấu trúc phản ánh một phần quan trọng của hoạt động khoa học. Tuy nhiên, sự phân tách đó cũng làm xuất hiện một khoảng trống lý thuyết và đo lường: một người có thể đạt điểm cao ở từng kỹ năng riêng nhưng vẫn không tạo ra một nghiên cứu nhất quán ở cấp hệ thống.
Luperdi-Román et al. (2025) phát triển và kiểm định một Research Competency Scale cho sinh viên đại học Peru gồm 37 mục thuộc năm miền: epistemic knowledge, interpretation skills, methodological knowledge, scientific communication và information management. Nghiên cứu này cho thấy research competence có thể được đo như một cấu trúc đa chiều và cung cấp nền tảng quan trọng cho việc đo lường năng lực nghiên cứu trong giáo dục đại học.
Tuy nhiên, sự xuất hiện của GenAI tạo ra ít nhất hai yêu cầu mới. Thứ nhất, khả năng lựa chọn, kiểm chứng và quản trị AI ngày càng trở thành một thành phần của thực hành nghiên cứu. Thứ hai, việc AI có thể tạo ra những sản phẩm biểu hiện giống năng lực khiến việc phân biệt performance của hệ thống với capability của người nghiên cứu trở nên cấp thiết.
Một nhà nghiên cứu có thể giỏi thống kê nhưng xác lập một vấn đề không thể trả lời bằng thiết kế đã chọn. Một người có thể tìm được nhiều tài liệu nhưng không nhận ra nguồn trích dẫn không hỗ trợ claim. Một sinh viên có thể sử dụng GenAI thành thạo nhưng vẫn chấp nhận một kết luận không phù hợp với bằng chứng.
Do đó:
Good statistics + weak research problem ≠ strong research.
Extensive information retrieval + weak evidence evaluation ≠ evidence-based research.
High AI literacy + poor scientific judgment ≠ responsible research capability.
RCA được phát triển nhằm giải quyết chính khoảng trống tích hợp này.
1.3. Khoảng trống thứ hai: AI literacy là cần thiết nhưng chưa đủ
AI literacy đang trở thành một cấu trúc quan trọng trong nghiên cứu giáo dục. UNESCO (2024) phát triển AI Competency Framework for Students với các chiều liên quan đến human-centred mindset, ethics, techniques/applications và thiết kế hệ thống AI. Khung OECD–European Union (2026) tiếp tục xác định AI literacy như tổ hợp kiến thức, kỹ năng và thái độ cho phép người học hiểu AI, đánh giá phê phán output và sử dụng AI một cách có đạo đức, sáng tạo và có hiểu biết về rủi ro.
Các nghiên cứu đo lường gần đây cũng củng cố quan điểm AI competence là một cấu trúc đa chiều. Do et al. (2026) phát triển thang AI literacy cho sinh viên đại học Việt Nam dựa trên 843 người tham gia, xác định các chiều understanding, application và ethics/responsibility. Lee et al. (2026) phát triển Generative AI Competence Scale (GenAIComp) trên 1.000 người tham gia và cho thấy GenAI competence không thể giản lược thành một kỹ năng vận hành đơn lẻ.
Những tiến bộ này rất quan trọng nhưng không đồng nghĩa AI literacy có thể đại diện cho research capability. Một người hiểu cách AI hoạt động, có thể nhận diện bias và biết sử dụng prompt vẫn có thể chưa có khả năng xác định researchable problem, đánh giá chất lượng bằng chứng, lựa chọn thiết kế phù hợp, phân biệt association với causation hoặc giới hạn một claim theo sức mạnh của thiết kế.
Do đó, RCA dựa trên nguyên lý:
AI competence is necessary but not sufficient for research capability.
AIRL phải nằm bên trong một kiến trúc lớn hơn gồm evidence reasoning, methodological alignment, research integrity và accountability. Đây cũng là cách tiếp cận tương thích với định hướng human-centred của UNESCO (Miao & Holmes, 2023): AI nên mở rộng khả năng của con người nhưng không làm mất quyền chủ thể và trách nhiệm của con người trong quá trình tạo lập tri thức.
1.4. Khoảng trống thứ ba: self-assessment chưa đủ để chứng minh năng lực
Một giới hạn phổ biến của các competence scales là sự phụ thuộc vào self-report. Người tham gia thường được yêu cầu đánh giá họ “biết”, “có thể”, “tự tin” hoặc “thành thạo” đến mức nào. Self-report có ưu điểm về chi phí và khả năng triển khai quy mô lớn, nhưng không bảo đảm sự tương ứng giữa perceived competence và demonstrated competence.
Bewersdorff et al. (2025), trong systematic review 31 nghiên cứu sử dụng sáu công cụ AI literacy, phát hiện các thang tự đánh giá thường tạo ra tương quan với những biến liên quan cao hơn performance-based assessment. Kết quả gợi ý nguy cơ metacognitive bias khi người học tự đánh giá năng lực.
Rủi ro này đặc biệt lớn trong môi trường GenAI bởi output có chất lượng hình thức cao có thể làm người sử dụng đánh giá quá mức capability của chính mình. Walters và Wilder (2023), khi phân tích 636 tài liệu tham khảo do GPT-3.5 và GPT-4 tạo ra, cho thấy citation fabrication và các sai sót thư mục có thể xuất hiện với tần suất đáng kể. Mặc dù hiệu năng của các hệ thống AI tiếp tục thay đổi và các tỷ lệ cụ thể không nên được suy rộng máy móc sang những mô hình mới hơn, nguyên lý phương pháp vẫn còn nguyên giá trị: linguistic fluency không phải bằng chứng của source validity.
Do đó, một RCA có giá trị không nên chỉ là bảng hỏi tự báo cáo. Nó cần được liên kết với performance tasks trong đó người học thực sự phải xác định vấn đề, kiểm chứng bằng chứng, đánh giá phương pháp và biện minh cho quyết định.
1.5. Khoảng trống thứ tư: research integrity không đồng nhất với AI disclosure
GenAI tạo ra hàng loạt câu hỏi mới đối với liêm chính nghiên cứu: dữ liệu nào có thể được nhập vào hệ thống bên ngoài; AI có thể hỗ trợ coding ở mức nào; việc sử dụng công cụ nào cần disclosure; output do AI tạo có được dùng như evidence hay không; quyền tác giả được xác định như thế nào; và ai chịu trách nhiệm nếu một claim sai được tạo hoặc gợi ý bởi AI.
Porsdam Mann et al. (2024) nhấn mạnh ba yêu cầu đối với việc sử dụng LLM trong viết học thuật: đóng góp thực chất của con người, kiểm tra của con người và minh bạch/ghi nhận việc sử dụng. Ba yêu cầu này cho thấy disclosure chỉ là một phần của responsible use.
Vì vậy:
AI Disclosure ≠ Research Integrity.
Một tuyên bố “AI đã được sử dụng” không chứng minh rằng nguồn đã được kiểm tra, dữ liệu được bảo vệ, output được xác minh hoặc authorship được quản trị phù hợp. RCA do đó tách Research Integrity (RI) khỏi AI–Research Literacy (AIRL) và Scientific Judgment & Accountability (SJA).
1.6. Khoảng trống thứ năm: scientific judgment và epistemic accountability
Khoảng trống quan trọng nhất mà RCA hướng đến là câu hỏi không chỉ người học có thể làm gì, mà còn họ có thể biện minh quyết định đó như thế nào và ai chịu trách nhiệm cho hậu quả nhận thức của quyết định.
Trong môi trường có AI, khái niệm human-in-the-loop có thể trở nên hình thức nếu con người chỉ phê duyệt output mà không có khả năng kiểm tra hoặc bác bỏ. Meaningful human oversight yêu cầu năng lực thực tế để chất vấn, so sánh bằng chứng, sửa đổi, override và giải trình quyết định.
NIST Generative AI Profile nhấn mạnh quản trị trustworthiness xuyên suốt vòng đời của hệ thống AI (Autio et al., 2024). Áp dụng vào nghiên cứu khoa học, oversight phải xuất hiện ở những điểm nơi AI có thể ảnh hưởng đến câu hỏi, evidence synthesis, coding, statistical analysis, interpretation hoặc writing.
Singh (2026) đưa ra một cảnh báo liên quan thông qua khái niệm proxy regimes: sản phẩm học thuật có thể đạt yêu cầu trong khi quá trình nhận thức mà sản phẩm được kỳ vọng đại diện không thực sự diễn ra. Điều này trực tiếp thách thức giả định truyền thống rằng chất lượng sản phẩm cuối cùng là proxy đáng tin cậy cho năng lực.
RCA vì vậy bổ sung Scientific Judgment & Accountability (SJA) như một miền riêng biệt.
1.7. Mục tiêu và đóng góp nghiên cứu
Bài viết có năm mục tiêu: xây dựng cơ sở lý thuyết cho Integrated Research Capability trong môi trường AI; phát triển RCA với bảy miền khái niệm có ranh giới rõ; đề xuất kiểm định cấu trúc bậc cao IRC; xây dựng chương trình kiểm định nomological, criterion và predictive validity; và thiết kế chiến lược kiểm định measurement invariance giữa các nhóm sinh viên.
Ba đóng góp được kỳ vọng.
Conceptual contribution: chuyển research competence từ danh mục kỹ năng sang một architecture của các năng lực phối hợp.
Measurement contribution: tích hợp self-report, performance assessment, competing-model testing và higher-order modelling.
Educational contribution: cung cấp khung chẩn đoán để các trường đại học đánh giá không chỉ mức năng lực chung mà cả cấu hình điểm mạnh–điểm yếu theo từng miền.
- KHÁI NIỆM HÓA INTEGRATED RESEARCH CAPABILITY
2.1. Skill, competence và capability
Ba khái niệm có liên hệ nhưng không đồng nhất.
Skill mô tả khả năng thực hiện một thao tác tương đối xác định, chẳng hạn tìm tài liệu, chạy hồi quy hoặc định dạng trích dẫn.
Competence yêu cầu phối hợp kiến thức, kỹ năng và phán đoán để hoàn thành nhiệm vụ phức hợp.
Capability nhấn mạnh khả năng huy động và tái cấu hình các competence trong những tình huống mới, bất định hoặc không có quy trình hoàn toàn cố định.
Nghiên cứu khoa học phù hợp với cấp capability bởi hai bài toán sử dụng cùng một phương pháp vẫn có thể đòi hỏi các quyết định rất khác về operationalization, sampling, missing data, alternative explanations và interpretation. GenAI càng làm tăng tính biến động do công cụ, affordance, giới hạn và quy định sử dụng thay đổi nhanh.
2.2. Định nghĩa Integrated Research Capability
Bài viết định nghĩa:
Integrated Research Capability (IRC) là năng lực bậc cao cho phép người nghiên cứu xác lập vấn đề; tìm kiếm, đánh giá và tổng hợp bằng chứng; duy trì sự phù hợp giữa câu hỏi, lý thuyết, thiết kế, dữ liệu, phân tích và claim; suy luận trong giới hạn bằng chứng; sử dụng và kiểm soát AI có trách nhiệm; duy trì liêm chính; đồng thời biện minh và chịu trách nhiệm cho những quyết định khoa học.
Khái niệm này có thể được phân thành ba lớp.
Lớp epistemic: RPF, EL và AR.
Lớp methodological–technological: MA và AIRL.
Lớp normative–accountability: RI và SJA.
Ba lớp không phải ba nhân tố thay thế cho bảy miền, mà là cách tổ chức lý thuyết nhằm giải thích vai trò khác nhau của từng miền.
2.3. Logic nghiên cứu nền tảng
RCA đặt trên chuỗi:
Phenomenon → Research Problem → Evidence → Research Question → Theory → Design → Data → Analysis → Inference → Claim.
Chuỗi này không hàm ý quá trình nghiên cứu luôn tuyến tính. Literature review có thể làm thay đổi problem; pilot có thể buộc researcher điều chỉnh measurement; kết quả có thể yêu cầu quay lại theory. Tuy nhiên, chuỗi giúp xác định các điểm cần methodological coherence.
AI có thể hỗ trợ gần như mọi mắt xích. Chính vì vậy AIRL, RI và SJA không thể chỉ xuất hiện ở giai đoạn viết báo cáo; chúng phải vận hành xuyên suốt vòng đời nghiên cứu.
2.4. IRC như một giả thuyết cấu trúc, không phải tiền đề
RCA giả thuyết rằng bảy miền có mức liên hệ đủ để phản ánh một capability rộng hơn. Tuy nhiên, sự tồn tại của IRC phải được chứng minh bằng dữ liệu.
Ít nhất bốn mô hình cần được so sánh:
M1: one-factor model;
M2: seven correlated first-order factors;
M3: second-order seven-factor RCA;
M4: bifactor model nếu có cơ sở lý thuyết và dữ liệu phù hợp.
Nếu M2 phù hợp hơn M3, nghiên cứu phải chấp nhận rằng bảy miền liên quan nhưng không hình thành một higher-order IRC đủ mạnh. Nếu bifactor tạo fit tốt nhưng specific factors mất ý nghĩa, cách diễn giải cũng cần thay đổi. RCA chỉ có giá trị khi architecture là kết quả của sự hội tụ giữa theory và evidence.
- BẢY MIỀN CỦA RESEARCH CAPABILITY ARCHITECTURE
3.1. Research Problem Framing – RPF
RPF là khả năng chuyển một hiện tượng hoặc mối quan tâm thành vấn đề có thể nghiên cứu bằng bằng chứng. Nó bao gồm phân biệt topic với problem, xác định bối cảnh, nhận diện tension/gap, giới hạn boundary, đánh giá significance và tránh giả định cơ chế nhân quả trước khi có bằng chứng.
Logic:
Phenomenon → Existing Evidence → Tension/Gap → Boundary → Researchable Problem.
“AI trong giáo dục đại học” chỉ là một chủ đề. Ngược lại, câu hỏi về mối liên hệ giữa mức sử dụng GenAI và khả năng xác minh nguồn của một nhóm sinh viên xác định có thể hình thành từ một problem cụ thể.
RPF là năng lực đầu nguồn. Một nghiên cứu có thể sử dụng kỹ thuật phân tích phức tạp nhưng vẫn yếu nếu vấn đề ban đầu không rõ.
3.2. Evidence Literacy – EL
EL là khả năng tìm kiếm, truy nguyên, đánh giá, kiểm chứng, so sánh và tổng hợp bằng chứng nhằm hỗ trợ hoặc phản biện claim.
Logic:
Source → Evidence → Claim.
EL rộng hơn thao tác tìm thông tin. Một nguồn có thật chưa chắc là bằng chứng phù hợp; một bằng chứng phù hợp chưa chắc đủ mạnh để hỗ trợ toàn bộ claim.
Trong môi trường GenAI, EL trở thành tuyến phòng thủ quan trọng trước fabricated references, misquotation, context loss hoặc source–claim mismatch. Walters và Wilder (2023) cho thấy sự trôi chảy ngôn ngữ không bảo đảm độ chính xác thư mục. Vì vậy source verification phải được xem là competence, không chỉ best practice.
3.3. Methodological Alignment – MA
MA là khả năng duy trì sự tương thích giữa:
Problem → RQ → Theory → Design → Sampling → Measurement → Data → Analysis → Claim.
MA không đo số lượng phương pháp mà người học biết. Nó đo khả năng chọn và biện minh phương pháp phù hợp.
Một mô hình hồi quy có thể chạy hoàn toàn đúng về kỹ thuật nhưng không phù hợp nếu measurement không đại diện cho construct hoặc claim được diễn giải nhân quả từ dữ liệu không cho phép suy luận nhân quả.
Do đó:
Technical correctness ≠ Methodological appropriateness.
3.4. Analytical Reasoning – AR
AR là khả năng chuyển dữ liệu thành bằng chứng và bằng chứng thành suy luận có giới hạn.
Các phân biệt nền tảng gồm:
Data ≠ Evidence.
Association ≠ Causation.
Prediction ≠ Explanation.
Statistical significance ≠ Practical significance.
Model fit ≠ Truth.
AI có thể tự động hóa calculation và thậm chí gợi ý interpretation, nhưng researcher vẫn phải xác định whether an analysis answers the research question, whether assumptions are plausible và whether the claim exceeds what the design supports.
Trong kỷ nguyên automation, Analytical Reasoning vì vậy dịch chuyển từ “performing calculations” sang “evaluating analytic warrants”.
3.5. AI–Research Literacy – AIRL
AIRL được định nghĩa là năng lực hiểu, lựa chọn, cấu hình, kiểm chứng, tích hợp, giám sát và công khai việc sử dụng AI trong vòng đời nghiên cứu.
Chu trình:
Understand → Select → Configure/Prompt → Inspect → Verify → Integrate → Monitor → Disclose.
AIRL có chủ ý rộng hơn prompt literacy. Nó bao gồm task–AI fit, evaluation of output, awareness of limitations, verification, provenance và disclosure.
Điểm lý thuyết quan trọng là AIRL chỉ là một trong bảy miền. RCA tránh AI exceptionalism — khuynh hướng biến AI thành trung tâm và tổ chức mọi năng lực khác xung quanh nó.
3.6. Research Integrity – RI
RI là năng lực duy trì các chuẩn mực liêm chính trong quá trình tạo tri thức, bao gồm ethics approval khi cần, informed consent, confidentiality, privacy, data governance, authorship, citation integrity, provenance, conflict of interest, reproducibility, transparency và AI disclosure.
Ba phân biệt quan trọng:
Disclosure ≠ Verification.
Transparency ≠ Provenance.
Compliance ≠ Scientific Judgment.
Việc công bố sử dụng AI không chứng minh rằng output đã được kiểm tra hoặc dữ liệu được xử lý phù hợp.
RI do đó được hiểu như applied governance competence, chứ không chỉ nhận biết các nguyên tắc đạo đức.
3.7. Scientific Judgment & Accountability – SJA
SJA là khả năng đánh giá, quyết định, biện minh, giám sát, hiệu chỉnh và chịu trách nhiệm cho quyết định khoa học.
Chu trình:
Evaluate → Decide → Justify → Monitor → Revise → Account.
SJA trở nên rõ nhất ở những tình huống không có một quy tắc kỹ thuật tự động: hai mô hình đều có fit chấp nhận được; AI và researcher đưa ra diễn giải khác nhau; bằng chứng mới làm suy yếu giả thuyết; provenance của output không rõ; hoặc dữ liệu định lượng và định tính tạo ra kết luận căng thẳng với nhau.
SJA phân biệt human presence với meaningful human oversight. Một researcher có thể nằm “in the loop” nhưng vẫn mặc định chấp nhận output. SJA yêu cầu khả năng inspect, question, reject, modify, override, document và account.
Đây là đóng góp khái niệm quan trọng nhất của RCA.
- MÔ HÌNH LÝ THUYẾT VÀ GIẢ THUYẾT
4.1. Measurement architecture
RCA đề xuất:
RPF, EL, MA, AR, AIRL, RI, SJA → Integrated Research Capability (IRC).
H1–H7 được xác định là measurement hypotheses, không phải giả thuyết nhân quả.
H1: RPF phản ánh tích cực IRC.
H2: EL phản ánh tích cực IRC.
H3: MA phản ánh tích cực IRC.
H4: AR phản ánh tích cực IRC.
H5: AIRL phản ánh tích cực IRC.
H6: RI phản ánh tích cực IRC.
H7: SJA phản ánh tích cực IRC.
4.2. Nomological network
Sau khi measurement model đạt bằng chứng chấp nhận được, IRC có thể được đặt trong mạng lưới nomological:
Research Training Quality (RTQ) → IRC → Research Self-Efficacy (RSE) → Research Performance (RP) → Research Impact Readiness (RIR).
Một đường trực tiếp IRC → RP cũng được đề xuất.
Logic của mô hình là chất lượng đào tạo tốt hơn có liên hệ với năng lực nghiên cứu tích hợp cao hơn; năng lực này có thể góp phần xây dựng self-efficacy nhưng đồng thời phải dự báo performance ngoài self-efficacy.
4.3. Tránh conceptual circularity của AIRL
Nếu AIRL đã là first-order factor của IRC, không nên đồng thời sử dụng AIRL như biến ngoại sinh “gây ra” IRC trong cùng mô hình. Cách cấu trúc như vậy sẽ tạo conceptual circularity.
Thay vào đó, AIRL có thể cùng SJA dự báo Responsible AI Research Use (RAIRU) trong auxiliary model.
Mục tiêu là kiểm tra luận điểm:
Knowing AI is not equivalent to governing AI scientifically.
4.4. Structural hypotheses
H8: RTQ có quan hệ tích cực với IRC.
H9: IRC có quan hệ tích cực với RSE.
H10: IRC có quan hệ tích cực với RP.
H11: RSE có quan hệ tích cực với RP.
H12: RSE đóng vai trò trung gian một phần trong quan hệ IRC–RP.
H13: RP có quan hệ tích cực với RIR.
H14: SJA có quan hệ tích cực với RAIRU.
H15: SJA giải thích thêm phương sai của RAIRU sau khi AIRL đã được đưa vào mô hình.
Với dữ liệu cắt ngang, H8–H15 nên được diễn giải dưới dạng structural associations, không được xem là bằng chứng quan hệ nhân quả.
4.5. Câu hỏi nghiên cứu
RQ1: Bảy miền RPF, EL, MA, AR, AIRL, RI và SJA có hình thành một cấu trúc IRC bậc cao ổn định hay không?
RQ2: Second-order RCA có mức phù hợp và khả năng diễn giải tốt hơn các mô hình cạnh tranh hay không?
RQ3: IRC có liên hệ với research self-efficacy và research performance ở mức nào?
RQ4: RCA có đạt measurement invariance giữa các nhóm bậc học hoặc ngành học hay không?
RQ5: SJA có tạo incremental validity đối với RAIRU ngoài AIRL hay không?
- PHƯƠNG PHÁP PHÁT TRIỂN VÀ KIỂM ĐỊNH RCA
5.1. Triết lý phát triển thang đo
Phát triển RCA không được giản lược thành quy trình “viết item → EFA → CFA”. Theo Standards for Educational and Psychological Testing (AERA, APA, & NCME, 2014), validity liên quan đến mức độ bằng chứng và lý luận hỗ trợ cách diễn giải và sử dụng score. Boateng et al. (2018) cũng nhấn mạnh scale development phải bắt đầu từ domain definition, item generation và content validity trước factor analysis.
RCA do đó được phát triển theo tám phase:
Phase 1 – Domain Specification
→ Phase 2 – Item Generation
→ Phase 3 – Content Validation
→ Phase 4 – Cognitive Interviews
→ Phase 5 – Pilot & EFA
→ Phase 6 – Independent CFA & Competing Models
→ Phase 7 – Structural/Criterion/Predictive Validation
→ Phase 8 – Cross-Validation & Measurement Invariance.
5.2. Phase 1 – Domain specification (Xác lập miền khái niệm)
Giai đoạn đầu yêu cầu systematic hoặc scoping review các dòng nghiên cứu về research competence, scientific reasoning, evidence literacy, information literacy, methodological competence, research self-efficacy, AI literacy, GenAI competence, research integrity, epistemic agency và human accountability.
Mục tiêu là xây construct map, không phải chỉ thu thập item.
Bốn cặp ranh giới cần được phân biệt đặc biệt.
EL–AR: EL đánh giá liệu evidence có đáng tin và hỗ trợ claim hay không; AR đánh giá từ evidence có thể suy luận điều gì.
MA–AR: MA đánh giá fit giữa RQ, design và analysis; AR đánh giá validity của interpretation.
AIRL–RI: AIRL đánh giá AI có được lựa chọn, cấu hình và kiểm chứng phù hợp hay không; RI đánh giá việc sử dụng có tuân thủ integrity, privacy, authorship và provenance hay không.
RI–SJA: RI liên quan chuẩn mực; SJA liên quan quyết định và accountability trong tình huống cụ thể.
Nếu construct boundaries không được giải quyết ở giai đoạn lý thuyết, discriminant validity thống kê khó có thể cứu một architecture được xác định không rõ.
5.3. Phase 2 – Item generation (Tạo ngân hàng mục hỏi)
Ngân hàng khởi đầu khoảng 70–100 mục là hợp lý; một cấu hình khả thi là 12 items × 7 domains = 84 items.
Items nên được tạo từ ba nguồn: literature-derived items; expert-generated items; và critical incidents thu từ sinh viên, giảng viên hoặc researchers.
Item wording nên ưu tiên behavioural capability.
Không nên:
“Tôi giỏi nghiên cứu.”
Nên:
“Tôi có thể giải thích vì sao dữ liệu được lựa chọn phù hợp với câu hỏi nghiên cứu.”
Không nên:
“Tôi sử dụng AI có trách nhiệm.”
Nên:
“Trước khi sử dụng một kết quả do AI đề xuất, tôi kiểm tra nguồn dữ liệu hoặc bằng chứng mà kết quả đó dựa vào.”
Double-barrelled items cần được tránh.
5.4. Response scale
Thang 5 mức theo mức capability có thể phù hợp hơn agreement scale:
1 = Chưa có khả năng thực hiện;
2 = Chỉ thực hiện khi được hướng dẫn nhiều;
3 = Có thể thực hiện trong tình huống quen thuộc;
4 = Có thể thực hiện tương đối độc lập;
5 = Có thể thực hiện độc lập và giải thích quyết định.
Anchors này cần được kiểm tra qua cognitive interviewing trước khi cố định.
5.5. Phase 3 – Expert content validation (Thẩm định nội dung)
Khoảng 10–15 chuyên gia có thể được lựa chọn từ research methodology, educational measurement, AI in education, research integrity/ethics và higher education.
Mỗi item được đánh giá về relevance, clarity, representativeness, domain specificity và AI-era relevance nếu thích hợp.
Có thể báo cáo I-CVI, S-CVI/Ave và modified kappa. Tuy nhiên, các thresholds không nên được áp dụng cơ học. Một item có I-CVI cao nhưng chuyên gia không thống nhất về domain có thể vẫn là bằng chứng của construct contamination.
5.6. Phase 4 – Cognitive interviews ( Phỏng vấn nhận thức )
Khoảng 15–30 sinh viên đa dạng về ngành học, bậc học và kinh nghiệm nghiên cứu có thể tham gia.
Các kỹ thuật gồm think-aloud, paraphrasing, comprehension probing, retrieval probing, judgment probing và response-mapping probing.
Cognitive interviews đặc biệt quan trọng với các khái niệm như provenance, accountability, evidence quality và methodological alignment.
5.7. Phase 5 – Pilot và EFA (Nghiên cứu thí điểm và phân tích thí điểm khám pha)
Sau expert review và cognitive interviews, ngân hàng có thể còn khoảng 50–60 items. Mẫu 250–400 người thường phù hợp hơn một pilot nhỏ khi mục tiêu là xác định cấu trúc đa nhân tố tương đối phức tạp.
Phân tích cần bao gồm missingness, floor/ceiling effects, distribution, inter-item correlations, corrected item-total correlations, KMO, Bartlett’s test, parallel analysis, factor extraction, loadings, cross-loadings, communalities và conceptual interpretability.
Parallel analysis nên được ưu tiên hơn quy tắc eigenvalue > 1 đơn thuần.
Việc giữ hoặc loại item không nên được quyết định duy nhất bởi loading. Content coverage phải được cân nhắc đồng thời.
5.8. Phase 6 – Independent CFA và competing models (Phân tích nhân tố khẳng định trên mẫu độc lập và so sánh mô hình)
CFA phải sử dụng mẫu độc lập với EFA. Nếu nghiên cứu đồng thời kiểm định seven-factor structure, second-order model và invariance, quy mô khoảng 600–800 người là mục tiêu hợp lý khi nguồn lực cho phép, mặc dù yêu cầu mẫu cuối cùng nên được quyết định bằng model complexity và power/simulation thay vì một quy tắc cố định.
Bốn mô hình chính:
M1 – One-factor model.
M2 – Seven correlated first-order factors.
M3 – Second-order RCA.
M4 – Bifactor model, chỉ khi được lý thuyết hỗ trợ.
Không nên lựa chọn bifactor chỉ vì model fit tốt hơn. Bifactor dễ đạt fit cao nhưng có thể khó diễn giải hoặc tạo specific factors yếu.
5.9. Model fit
Nên báo cáo χ², χ²/df, CFI, TLI, RMSEA kèm confidence interval và SRMR.
Không một cutoff đơn lẻ nào nên được sử dụng như tiêu chuẩn tuyệt đối để tuyên bố model “đạt” hoặc “không đạt”. Model fit phải được kết hợp với factor loadings, residuals, theoretical interpretability, parsimony và competing-model evidence.
5.10. Reliability
Báo cáo tối thiểu Cronbach’s α, McDonald’s ω và composite reliability.
Alpha được giữ để so sánh với literature nhưng không nên là reliability evidence duy nhất. Nếu bifactor được giữ, omega hierarchical có thể giúp đánh giá liệu total IRC score có được general factor hỗ trợ đủ mạnh hay không.
5.11. Convergent và discriminant validity
Convergent validity có thể đánh giá qua standardized loadings, AVE và CR.
Discriminant validity nên ưu tiên HTMT (Henseler et al., 2015), đặc biệt đối với các cặp gần nhau:
EL–AR;
MA–AR;
AIRL–RI;
RI–SJA;
AIRL–SJA.
Nếu RI và SJA không phân biệt tốt, nghiên cứu phải xem xét cả wording lẫn khả năng theory đang chia một construct thành hai thành phần nhân tạo.
5.12. Phase 7 – Nomological validation (Kiểm định nomological tiêu chuẩn và giá trị dự báo)
Sau khi measurement architecture ổn định, structural model có thể kiểm định:
RTQ → IRC → RSE → RP → RIR
cùng với:
IRC → RP.
Research self-efficacy không được đồng nhất với capability. Một cá nhân có thể tự tin nhưng performance thấp hoặc ngược lại.
5.13. Mediation
H12 có thể được kiểm định bằng bootstrap khoảng 5.000 resamples, báo cáo direct, indirect và total effects cùng bootstrap confidence intervals.
Nếu dữ liệu cross-sectional, nên sử dụng cách diễn đạt “indirect statistical association” và tránh diễn giải một causal mechanism đã được xác nhận.
5.14. Incremental validity của SJA
Đây là một kiểm định quan trọng đối với novelty của RCA.
Model A: RAIRU ← AIRL.
Model B: RAIRU ← AIRL + SJA.
So sánh ΔR², standardized coefficients và predictive performance.
Nếu SJA giải thích thêm phương sai có ý nghĩa, kết quả hỗ trợ luận điểm:
Knowing AI is not equivalent to governing AI scientifically.
Nếu không, ranh giới giữa SJA, AIRL và RI cần được xem xét lại.
5.15. Criterion validity bằng performance task
RCA không nên trở thành self-perception questionnaire thuần túy. Nghiên cứu đề xuất một Research Design Performance Task.
Người học nhận một tình huống gồm bối cảnh, nguồn có chất lượng khác nhau, dữ liệu hoặc dataset, output AI, phương án thiết kế và một số claims.
Nhiệm vụ yêu cầu họ:
xác định research problem;
xây dựng/chỉnh RQ;
kiểm chứng evidence;
đánh giá methodological fit;
diễn giải kết quả;
đánh giá output AI;
nhận diện integrity risks;
và đưa ra quyết định cuối cùng kèm justification.
Rubric được tổ chức theo bảy miền RCA.
Sự kết hợp questionnaire–performance task giảm common-method dependency và tạo criterion evidence mạnh hơn.
5.16. Predictive validity
Trong thiết kế longitudinal, RCA Time 1 có thể được dùng để dự báo proposal quality, research project performance, thesis quality, presentation, publication readiness hoặc một performance task ở Time 2.
Predictive validity đặc biệt quan trọng nếu RCA được sử dụng cho chẩn đoán giáo dục.
5.17. Phase 8 – Measurement invariance (Kiểm định chéo và bất biến đo lường)
Các so sánh ưu tiên:
undergraduate vs postgraduate;
STEM vs social sciences/humanities;
formal research training vs limited training;
high-frequency vs low-frequency GenAI use.
Trình tự có thể gồm configural, metric, scalar và strict invariance khi thích hợp. Chỉ diễn giải latent mean differences sau khi mức invariance cần thiết được hỗ trợ.
5.18. Common-method bias
Các biện pháp procedural gồm anonymity, tách predictor–criterion, sử dụng performance task độc lập, giảm wording redundancy và nếu có thể thu criterion ở thời điểm khác.
Harman’s single-factor test không nên được dùng như bằng chứng duy nhất rằng common-method bias không tồn tại.
5.19. Ethical governance và AI provenance
Một nghiên cứu về Responsible AI Research Use phải tự áp dụng nguyên tắc governance mà nó đề xuất.
Nếu AI được dùng cho literature mapping, item brainstorming, dịch thuật, coding, proofreading hoặc code generation, nhóm nghiên cứu nên duy trì AI Provenance Log bao gồm system/model, thời điểm sử dụng, mục đích, loại input, output được giữ lại, human modification, verification procedure và final human decision.
Nguyên tắc có thể được cô đọng:
AI may assist research processes; it does not thereby inherit scientific authorship or accountability.
- KẾ HOẠCH PHÂN TÍCH VÀ KIẾN TRÚC BÁO CÁO KẾT QUẢ
Bản thảo hiện tại phát triển mô hình và protocol trước khi hoàn tất thu thập dữ liệu. Vì vậy, không tạo trước factor loadings, CFI, p-values hoặc effect sizes. Việc điền kết quả giả định vào một protocol phát triển thang đo sẽ xung đột trực tiếp với nguyên tắc research integrity mà RCA bảo vệ.
Results sau này nên được tổ chức theo trình tự tích lũy validity evidence.
6.1. Content validity
Báo cáo số item ban đầu, số item được sửa, loại hoặc chuyển domain; I-CVI, modified kappa và lý do quyết định.
6.2. Cognitive interview evidence
Báo cáo participant characteristics, misunderstanding patterns, response-process problems và item revisions.
6.3. EFA
Báo cáo KMO, Bartlett, parallel analysis, extraction method, rotation, variance, loadings, cross-loadings và lý do giữ/loại item.
6.4. CFA và competing-model comparison
Bảng kết quả nên gồm χ²/df, CFI, TLI, RMSEA, SRMR, information criteria khi phù hợp và substantive interpretation cho M1–M4.
Không điền bất kỳ số giả định nào trước khi dữ liệu thực được phân tích.
6.5. Reliability và construct validity
Báo cáo α, ω, CR và AVE cho từng domain; HTMT cho mọi cặp construct.
6.6. Structural model
Với H8–H15, báo cáo standardized coefficients, SE, CI, p-values khi phù hợp, R² và indirect effects.
6.7. Criterion và predictive validity
Báo cáo association giữa questionnaire scores và Research Design Performance Task. Nếu tương quan thấp, kết quả phải được xem như validity evidence cần giải thích, không phải một kết quả cần che giấu.
6.8. Measurement invariance
Báo cáo configural, metric, scalar và strict models cùng ΔCFI, ΔRMSEA và các bằng chứng bổ sung.
- THẢO LUẬN HỌC THUẬT
7.1. Từ danh mục kỹ năng đến kiến trúc năng lực
Đóng góp lý thuyết đầu tiên của RCA là dịch chuyển đơn vị phân tích. “Integrated” không có nghĩa chỉ đặt bảy thang con vào cùng một questionnaire. Ý nghĩa của integration nằm ở khả năng phối hợp các domain để tạo ra một chuỗi quyết định khoa học nhất quán.
RCA kết nối hai dòng literature hiện còn khá tách biệt. Một dòng phát triển research competency nhưng chưa tích hợp đầy đủ AI. Dòng kia phát triển AI literacy và GenAI competence nhưng không đo toàn research lifecycle. RCA nối hai dòng này mà không đồng nhất chúng.
7.2. Research Problem Framing như năng lực đầu nguồn
RPF có vai trò đặc biệt bởi nhiều lỗi nghiên cứu bắt đầu trước khi dữ liệu được thu thập.
Nếu problem chưa rõ, phương pháp dễ trở thành technique-driven research: chọn SEM vì muốn sử dụng SEM; chọn interview vì thuận tiện; tạo hypotheses bằng GenAI trước khi xác định theory.
RPF buộc researcher hỏi: vấn đề nào thực sự tồn tại; bằng chứng nào chứng minh vấn đề; điều gì chưa được giải thích; boundary nào cần áp dụng.
Do đó, methodological rigor bắt đầu trước methodology.
7.3. Evidence Literacy như tuyến phòng thủ nhận thức
GenAI làm tăng tốc literature interaction nhưng cũng làm nguồn thông tin trung gian giữa researcher và original source dày hơn. EL vì vậy phải đặt trọng tâm vào source–evidence–claim verification.
Ngay cả khi hallucination giảm đáng kể ở các hệ thống tương lai, verification vẫn là competence cốt lõi. Một nguồn có thật vẫn có thể bị tóm tắt sai; một nghiên cứu tốt vẫn có thể được sử dụng để hỗ trợ một claim mà nó chưa bao giờ kiểm định.
EL do đó không phải competence tạm thời phát sinh vì một thế hệ AI còn nhiều lỗi. Nó là năng lực bền vững của khoa học.
7.4. Methodological Alignment như cơ chế liên kết
MA đóng vai trò bridge giữa problem framing, theory, measurement, analysis và inference.
AI có thể tạo illusion of methodological sophistication: code đúng, bảng đẹp, terminology chuyên nghiệp nhưng design logic không nhất quán.
RCA vì vậy ưu tiên “fit” hơn “technical complexity”. Một thiết kế đơn giản nhưng phù hợp có giá trị khoa học cao hơn một kỹ thuật tiên tiến được áp dụng sai vấn đề.
7.5. Analytical Reasoning trong thời đại automation
Automation không làm reasoning kém quan trọng; nó thay đổi loại reasoning cần thiết.
Khi computation được tự động hóa, năng lực dịch chuyển từ “có thể tính” sang “có thể đánh giá điều phép tính cho phép kết luận”.
Một p-value, confidence interval hoặc model fit không tự diễn giải chính nó. Researcher phải xem xét effect size, uncertainty, alternative explanations, assumptions và inferential scope.
Vì vậy:
More automation requires stronger inferential governance, not weaker reasoning.
7.6. AIRL phải được tích hợp nhưng không thống trị
Một rủi ro của các framework “AI era” là AI exceptionalism. Nếu mọi cấu trúc được tái định nghĩa quanh AI, những nền tảng khoa học có nguy cơ bị hạ xuống thành năng lực phụ.
RCA chọn hướng ngược lại. AIRL rất quan trọng nhưng nằm ngang hàng với RPF, EL, MA, AR, RI và SJA.
AI là phương tiện có ảnh hưởng mạnh đến nghiên cứu; nó không phải mục đích cuối cùng của nghiên cứu.
7.7. Research Integrity từ compliance đến governance
RI trong RCA không được đo bằng các statement dễ tạo social desirability như “tôi tin đạo đức nghiên cứu là quan trọng”.
Nó cần được operationalize bằng decision capability: dữ liệu nào được phép nhập vào AI; nguồn nào phải truy nguyên; việc sử dụng nào cần disclosure; authorship được xử lý ra sao; khi nào workflow vi phạm confidentiality.
Như vậy, RI chuyển từ awareness sang governance.
7.8. Scientific Judgment & Accountability như đóng góp trọng tâm
SJA tạo ranh giới giữa việc con người “có mặt” và con người thực sự có năng lực giám sát.
Một quy trình human-in-the-loop không có nhiều ý nghĩa nếu human không đủ capability để kiểm tra recommendation.
Trong khoa học, meaningful oversight yêu cầu quyền và năng lực để reject, override và justify.
SJA cũng trả lời vấn đề proxy được Singh (2026) nêu ra: sản phẩm tốt không bảo đảm cognition đã xảy ra. Khi AI có thể tạo sản phẩm chất lượng cao, năng lực cần được đánh giá thông qua reasoning trail và defense, không chỉ output.
7.9. Research self-efficacy và demonstrated competence
RSE vẫn có giá trị đối với motivation, persistence và engagement, nhưng không nên được xem như proxy trực tiếp của research capability.
Bewersdorff et al. (2025) cho thấy self-assessment trong AI literacy có thể khác đáng kể performance-based measurement. RCA mở rộng logic đó sang năng lực nghiên cứu:
Perceived capability + Demonstrated capability.
Hai loại score không nhất thiết phải tương quan rất cao. Mức tương quan vừa phải có thể cho thấy chúng cung cấp thông tin bổ sung.
7.10. Từ AI assistance đến Human–AI research orchestration
RCA không phải mô hình chống AI. Mục tiêu là dịch chuyển từ assistance thiếu kiểm soát sang:
AI Assistance → Verified AI Assistance → Human–AI Orchestration → Scientifically Governed Human–AI Research.
Ở cấp cao hơn, researcher không chỉ gửi prompt. Họ thiết kế workflow, phân bổ tác vụ, đặt verification checkpoints, quản lý provenance và duy trì accountability.
Năng lực này trở nên đặc biệt quan trọng khi Agentic AI có thể tự lập kế hoạch, gọi công cụ, thực thi chuỗi nhiệm vụ và điều chỉnh hành động.
- ĐÓNG GÓP LÝ THUYẾT VÀ ĐO LƯỜNG
8.1. Construct integration
RCA tích hợp framing, evidence, methodology, reasoning, AI literacy, integrity và accountability vào một kiến trúc nghiên cứu thống nhất.
Novelty không nằm ở việc “thêm AI” vào một scale cũ mà ở việc định vị AI bên trong toàn bộ logic tạo lập bằng chứng.
8.2. AI embeddedness
AIRL được xem là một domain nội tại thay vì technology predictor bên ngoài.
Cách tiếp cận này phản ánh thực tế AI đang trở thành một phần của môi trường nghiên cứu nhưng đồng thời tránh giả định rằng AI competence đại diện cho toàn bộ research competence.
8.3. Scientific accountability
SJA làm rõ một câu hỏi nhiều AI literacy scales chưa trực tiếp trả lời:
Ai có khả năng biện minh và chịu trách nhiệm đối với scientific claim?
SJA nối epistemic agency với meaningful human oversight và responsible AI.
8.4. Higher-order architecture có thể phản bác
IRC không được tuyên bố như fact. Nó là một higher-order hypothesis phải cạnh tranh với các cấu trúc khác.
Đây là điểm quan trọng về philosophy of measurement: architecture phải được dữ liệu hỗ trợ chứ không được áp đặt lên dữ liệu.
8.5. Dual-mode assessment
RCA kết hợp:
“Tôi nghĩ tôi có thể thực hiện.”
với:
“Tôi có thực sự thực hiện được trong một nhiệm vụ nghiên cứu hay không?”
Dual-mode assessment là một đóng góp phương pháp quan trọng, đặc biệt trong thời đại AI có thể giúp người học tạo ra output vượt quá năng lực nội tại.
- HÀM Ý ĐỐI VỚI GIÁO DỤC ĐẠI HỌC
9.1. Curriculum mapping
RCA có thể hỗ trợ mapping chương trình:
Research Problem/Proposal → RPF + MA;
Literature Review → EL;
Statistics/Qualitative Analysis → AR;
AI in Research → AIRL;
Research Ethics → RI;
Capstone/Thesis Defense → SJA.
Tuy nhiên, chương trình không nên dạy bảy miền như silo. Capstone và thesis phải yêu cầu integration.
9.2. Diagnostic assessment
Thay vì chỉ tạo một total score, RCA có thể tạo competency profile theo từng domain.
Một sinh viên AIRL cao nhưng SJA thấp là một trường hợp giáo dục đáng chú ý: người học thành thạo AI nhưng có nguy cơ over-reliance và thiếu năng lực override.
Ngược lại, một người có SJA tốt nhưng AIRL thấp có thể có judgment mạnh nhưng chưa khai thác hiệu quả các affordance mới.
9.3. AI research training không nên thu hẹp thành prompting
Chuỗi đào tạo nên chuyển từ “prompt engineering” sang:
Questioning → Evidence Verification → Methodological Alignment → Analytical Reasoning → AI Orchestration → Integrity → Scientific Judgment → Accountability.
Prompting chỉ là một thao tác trong architecture rộng hơn.
9.4. Assessment redesign
Nếu AI có thể tạo essay, literature review hoặc research proposal có hình thức tốt, assessment cần dịch chuyển từ output-only sang process-and-justification.
Người học có thể được yêu cầu nộp:
evidence map;
source–claim matrix;
analysis decision record;
AI provenance log;
AI use statement;
và oral defense.
Điều này giúp assessment đo capability chứ không chỉ chất lượng của artifact.
9.5. Faculty development
RCA cũng có hàm ý đối với giảng viên. Faculty development cần giúp người dạy phân biệt AI literacy, research competence, integrity và scientific judgment; thiết kế assessment có khả năng kiểm tra reasoning; và đánh giá AI-supported work mà không rơi vào hai cực cấm tuyệt đối hoặc chấp nhận không điều kiện.
- HẠN CHẾ VÀ HƯỚNG NGHIÊN CỨU TƯƠNG LAI
Thứ nhất, RCA ban đầu được hình thành trong bối cảnh giáo dục đại học và có khả năng chịu ảnh hưởng của những giả định văn hóa, chương trình và phương pháp phổ biến trong môi trường phát triển mô hình. Cross-country validation là cần thiết trước khi tuyên bố tính phổ quát.
Thứ hai, epistemology khác nhau giữa các ngành. Evidence và valid inference trong engineering, experimental psychology hoặc qualitative sociology không hoàn toàn giống nhau. Core architecture có thể ổn định nhưng item wording và performance tasks có thể cần disciplinary adaptation.
Thứ ba, self-report bias không thể bị loại bỏ hoàn toàn. Performance task làm giảm nhưng không xóa vấn đề này.
Thứ tư, AI phát triển nhanh. AIRL items nên tập trung vào capability tương đối bền như verification, task–AI fit, provenance và monitoring thay vì tên công cụ hoặc chức năng cụ thể.
Thứ năm, cross-sectional SEM không chứng minh causal relationships. Longitudinal, experimental hoặc quasi-experimental studies sẽ cần thiết nếu nghiên cứu muốn đưa ra kết luận mạnh hơn về tác động của research training lên IRC.
Thứ sáu, second-order RCA chỉ là một giả thuyết cấu trúc. Nếu seven correlated factors hoặc bifactor model phù hợp và có ý nghĩa hơn, theory phải được điều chỉnh.
Thứ bảy, RAIRU là một outcome mới và cần chương trình operationalization cũng nghiêm ngặt như RCA.
Thứ tám, cần kiểm tra test–retest reliability, predictive validity, cross-cultural invariance và longitudinal stability trước khi RCA được dùng cho high-stakes assessment.
Cuối cùng, Agentic AI đặt ra một frontier mới. Khi AI không chỉ trả lời prompt mà có thể lập kế hoạch, gọi công cụ và thực hiện chuỗi hành động, khái niệm AIRL có thể cần mở rộng sang agent oversight, delegation boundaries, intervention thresholds và multi-agent provenance. Trong môi trường đó, SJA có khả năng trở thành domain ngày càng quan trọng.
- KẾT LUẬN
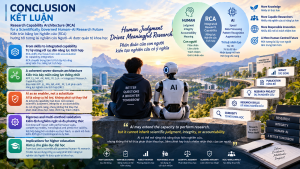
Bài viết đề xuất Research Capability Architecture (RCA) như một kiến trúc lý thuyết và đo lường nhằm tái khái niệm hóa năng lực nghiên cứu của sinh viên trong bối cảnh AI ngày càng tham gia sâu vào quá trình tạo lập tri thức. Thay vì đồng nhất năng lực nghiên cứu với tập hợp các kỹ năng kỹ thuật riêng lẻ hoặc khả năng vận hành công cụ AI, RCA đặt trọng tâm vào sự phối hợp giữa Research Problem Framing, Evidence Literacy, Methodological Alignment, Analytical Reasoning, AI–Research Literacy, Research Integrity, và Scientific Judgment & Accountability. Bảy miền được giả thuyết phản ánh một năng lực nghiên cứu tích hợp bậc cao — IRC — nhưng cấu trúc này phải được xác lập bằng bằng chứng thực nghiệm và cạnh tranh với các mô hình đo lường thay thế.
Đóng góp trung tâm của RCA là chuyển trọng tâm từ skill accumulation sang capability integration. Một researcher có năng lực không chỉ cần biết tìm tài liệu, chạy phân tích hoặc sử dụng AI, mà phải có khả năng kết nối problem, evidence, theory, design, data, analysis và inference thành một chuỗi quyết định có thể biện minh. Trong architecture này, AI được xem là thành phần hỗ trợ và mở rộng capability, không phải proxy cho capability.
RCA đặc biệt phân biệt AI–Research Literacy với Scientific Judgment & Accountability. Thành thạo AI không bảo đảm một cá nhân có thể nhận biết khi output sai, bác bỏ recommendation thiếu bằng chứng hoặc chịu trách nhiệm cho scientific claim. Khi hệ thống AI ngày càng có khả năng tạo code, phân tích dữ liệu, tổng hợp tài liệu và soạn thảo diễn giải, giá trị phân biệt của human researcher có xu hướng dịch chuyển từ execution sang problem framing, verification, integration, judgment và accountability.
Về mặt đo lường, RCA đề xuất một chiến lược nghiêm ngặt hơn self-report-only assessment. Việc kết hợp questionnaire với Research Design Performance Task, competing-model comparison, nomological validation, predictive validity và measurement invariance giúp biến RCA từ một framework khái niệm thành một chương trình nghiên cứu có thể kiểm định và phản bác. Đây là điều kiện quan trọng để tránh biến “integrated capability” thành một nhãn lý thuyết không có bằng chứng đo lường tương ứng.
Đối với giáo dục đại học, kiến trúc này gợi ý một chuyển dịch quan trọng: từ đào tạo sử dụng công cụ sang phát triển năng lực scientifically governed human–AI research. Chương trình đào tạo cần phát triển đồng thời khả năng đặt vấn đề, đánh giá bằng chứng, bảo đảm methodological fit, suy luận, sử dụng AI, duy trì integrity và chịu accountability. Assessment tương ứng phải xem xét cả output lẫn reasoning process, provenance và khả năng oral justification.
Hướng nghiên cứu tiếp theo cần kiểm định RCA với các mẫu độc lập, đa ngành và đa văn hóa; đánh giá stability, predictive validity và invariance; đồng thời xem xét architecture trong môi trường Agentic AI. Đặc biệt, cấu trúc IRC chỉ nên được duy trì nếu empirical evidence thực sự hỗ trợ nó.
Luận điểm cuối cùng của RCA có thể được cô đọng như sau:
AI may extend the capacity to perform research, but it cannot inherit scientific judgment, integrity, or accountability.
AI có thể mở rộng khả năng thực hiện nghiên cứu, nhưng không thể kế thừa phán đoán khoa học, liêm chính hay trách nhiệm nhận thức của con người.
Trong kỷ nguyên AI, chất lượng của nhà nghiên cứu vì thế không được quyết định bởi mức độ AI có thể làm thay họ, mà bởi mức độ họ có thể đặt câu hỏi đúng, kiểm chứng bằng chứng, lựa chọn và điều phối phương pháp, quản trị AI, phán đoán trong bất định và chịu trách nhiệm khoa học đối với tri thức được tạo ra.
TÀI LIỆU THAM KHẢO
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association.
- Autio, C., Schwartz, R., Dunietz, J., Jain, S., Stanley, M., Tabassi, E., Hall, P., & Roberts, K. (2024). Artificial intelligence risk management framework: Generative artificial intelligence profile (NIST AI 600-1). National Institute of Standards and Technology. https://doi.org/10.6028/NIST.AI.600-1
- Bewersdorff, A., Nerdel, C., & Zhai, X. (2025). How AI literacy correlates with affective, behavioral, cognitive and contextual variables: A systematic review. Computers and Education: Artificial Intelligence, 9, 100493. https://doi.org/10.1016/j.caeai.2025.100493
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, 149. https://doi.org/10.3389/fpubh.2018.00149
- Carolus, A., Koch, M. J., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS—Meta AI literacy scale: Development and testing of an AI literacy questionnaire based on well-founded competency models and psychological change- and meta-competencies. Computers in Human Behavior: Artificial Humans, 1(2), 100014.
- Do, H. V., Bui, T. T., Tran, D. H., Nguyen, H. T., & Dinh, L. D. (2026). Developing and validating an AI literacy scale for university students in Vietnam. IFLA Journal, 52(2), 222–233. https://doi.org/10.1177/03400352251385058
- González Canché, M. S. (2026). Data science, interactive visualizations, and generative AI tools for the analysis of qualitative, mixed-methods, and multimodal evidence. Elsevier.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2018). Multivariate data analysis (8th ed.). Cengage.
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43, 115–135. https://doi.org/10.1007/s11747-014-0403-8
- Klein, C. R., & Klein, R. (2025). The extended hollowed mind: Why foundational knowledge is indispensable in the age of AI. Frontiers in Artificial Intelligence, 8, 1719019. https://doi.org/10.3389/frai.2025.1719019
- Lazar, J., Feng, J. H., & Hochheiser, H. (2017). Research methods in human-computer interaction (2nd ed.). Morgan Kaufmann.
- Lee, S. C., Baby, T., Vongvit, R., Lee, J., Kim, Y. W., Cha, M. C., & Yoon, S. H. (2026). Development and validation of Generative AI Competence Scale (GenAIComp) among university students. Technology in Society, 84, 103059. https://doi.org/10.1016/j.techsoc.2025.103059
- Luperdi-Román, C. J. de los M., Goñi-Cruz, F. F., & Deroncele-Acosta, A. (2025). Design and psychometric validation of the research competency scale for university students in Peru. International Journal of Evaluation and Research in Education, 14(6), 4887–4902. https://doi.org/10.11591/ijere.v14i6.35752
- Miao, F., & Holmes, W. (2023). Guidance for generative AI in education and research. UNESCO.
- Miao, F., Shiohira, K., & Lao, N. (2024). AI competency framework for students. UNESCO.
- OECD, & European Union. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://doi.org/10.1787/65cd27d4-en
- Porsdam Mann, S., Vazirani, A. A., Aboy, M., Earp, B. D., Minssen, T., Cohen, I. G., et al. (2024). Guidelines for ethical use and acknowledgement of large language models in academic writing. Nature Machine Intelligence, 6, 1272–1274. https://doi.org/10.1038/s42256-024-00922-7
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004
- Singh, M. (2026). When the thesis passes but the mind doesn’t: Generative artificial intelligence, proxy regimes and epistemic agency in universities. Transformation in Higher Education, 11, Article 775. https://doi.org/10.4102/the.v11i0.775
- Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
- Williamson, K., & Johanson, G. (Eds.). (2018). Research methods: Information, systems, and contexts (2nd ed.). Chandos Publishing.
