
Responsible AI Governance in Educational Research: A Testable Framework Linking AI Transparency, AI Provenance, Meaningful Human Oversight, Research Integrity, and Scientific Trust
NGUYỄN VĂN HÙNG
HIGHLIGHTS
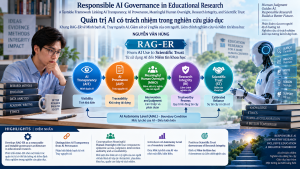
- Phát triển Responsible AI Governance in Educational Research (RAG-ER) như một kiến trúc quản trị AI có thể đo lường và kiểm định thực nghiệm trong nghiên cứu giáo dục.
- Phân biệt AI Transparency với AI Provenance, qua đó tách tính khả kiến của việc sử dụng AI khỏi khả năng tái dựng và kiểm toán lịch sử sản xuất tri thức có AI hỗ trợ.
- Khái niệm hóa Meaningful Human Oversight vượt khỏi mô hình human-in-the-loop hình thức thông qua bốn thành tố: epistemic access, critical scientific judgment, intervention authority và accountability.
- Đưa AI Autonomy Level vào như một điều kiện biên, theo đó mức tự chủ của AI càng cao thì giá trị bảo vệ liêm chính của meaningful human oversight càng trở nên quan trọng.
- Định vị Scientific Trust ở downstream của Research Integrity, thay vì suy ra trực tiếp từ năng lực kỹ thuật, độ trôi chảy hoặc mức độ tinh vi của AI.
TÓM TẮT
Sự phát triển nhanh chóng của trí tuệ nhân tạo tạo sinh (Generative Artificial Intelligence – GenAI), AI agent và các hệ thống tác tử có mức tự chủ ngày càng cao đang tái cấu trúc toàn bộ vòng đời nghiên cứu giáo dục. AI hiện có thể tham gia vào tìm kiếm và sàng lọc tài liệu, tổng hợp bằng chứng, phát triển câu hỏi nghiên cứu, tạo mã phân tích, hỗ trợ mã hóa dữ liệu định tính, lựa chọn hoặc đề xuất phương pháp phân tích, diễn giải kết quả và chuẩn bị bản thảo khoa học. Sự mở rộng này làm tăng đáng kể khả năng thực hiện tác vụ, nhưng đồng thời phân tán quyền hành động và quyền quyết định trong quá trình sản xuất tri thức. Trong khi nhiều chính sách học thuật hiện hành tập trung vào công bố việc sử dụng AI, disclosure đơn thuần chưa giải quyết đầy đủ ba vấn đề quản trị sâu hơn: khả năng truy nguyên quá trình hình thành output, năng lực can thiệp thực chất của con người và trách nhiệm đối với scientific claim cuối cùng.
Bài viết phát triển Responsible AI Governance in Educational Research (RAG-ER) nhằm chuyển quản trị AI từ một tập hợp nguyên tắc chuẩn tắc sang một kiến trúc cơ chế có thể operationalize, đo lường và kiểm định. Mô hình phân biệt AI Transparency (AIT) với AI Provenance (AIP); khái niệm hóa Meaningful Human Oversight (MHO) như sự kết hợp giữa epistemic access, critical scientific judgment, intervention authority và accountability; đặt Research Integrity (RI) làm cơ chế trực tiếp hình thành Scientific Trust (ST) có căn cứ; đồng thời đưa AI Autonomy Level (AIAL) vào như một boundary condition. Chuỗi lý thuyết trung tâm được đề xuất là AIT → AIP → MHO → RI → ST, cùng đường trực tiếp AIP → RI và hiệu ứng điều tiết AIAL × MHO → RI.
Để chuyển mô hình khái niệm thành một chương trình nghiên cứu có thể phản bác, bài viết đề xuất thiết kế phát triển và kiểm định nhiều giai đoạn gồm construct specification, item generation, expert content validation, cognitive interviewing, exploratory factor analysis, confirmatory factor analysis trên mẫu độc lập, structural equation modelling, competing-model analysis, measurement invariance và performance-based validation. Hai artefact quản trị được phát triển về mặt khái niệm gồm AI Provenance Log for Educational Research (AIPL-ER) và Meaningful Human Oversight Checklist for Educational Research (MHO-ER). Meaningful oversight được operationalize theo chuỗi hành động Inspect → Question → Reject → Modify → Override → Stop → Document → Account.
Đóng góp lý thuyết trung tâm của RAG-ER nằm ở bốn phân biệt: disclosure is not governance; transparency is not provenance; human presence is not meaningful human oversight; và AI assistance does not transfer scientific accountability. Bài viết lập luận rằng khi epistemic impact và autonomy của AI tăng, yêu cầu đối với provenance, meaningful oversight và human accountability phải tăng tương ứng. Theo cách tiếp cận này, scientific trust không được suy ra từ khả năng của AI mà phải được tạo ra từ một quá trình nghiên cứu có thể truy nguyên, kiểm chứng, can thiệp và quy trách nhiệm.
Từ khóa: responsible AI governance; AI transparency; AI provenance; meaningful human oversight; research integrity; scientific trust; AI autonomy; generative AI; AI agents; educational research.
ABSTRACT
The rapid advancement of generative artificial intelligence (GenAI), AI agents, and increasingly autonomous agentic systems is reshaping the entire lifecycle of educational research. AI can now participate in literature retrieval and screening, evidence synthesis, research-question development, analytical code generation, qualitative coding, the selection or recommendation of analytical procedures, interpretation of findings, and scientific manuscript preparation. This expansion substantially increases task-execution capacity while simultaneously redistributing agency and decision authority within knowledge-production processes. Although many current academic policies emphasize disclosure of AI use, disclosure alone does not adequately address three deeper governance challenges: the traceability of how AI-mediated outputs are produced, the substantive capacity of humans to intervene, and accountability for final scientific claims.
This article develops Responsible AI Governance in Educational Research (RAG-ER) to move AI governance from a set of normative principles toward a mechanism-based architecture that can be operationalized, measured, and empirically tested. The framework distinguishes AI Transparency (AIT) from AI Provenance (AIP); conceptualizes Meaningful Human Oversight (MHO) as the combined capacity for epistemic access, critical scientific judgment, intervention authority, and accountability; positions Research Integrity (RI) as the proximal mechanism through which warranted Scientific Trust (ST) is established; and introduces AI Autonomy Level (AIAL) as a boundary condition. The proposed core sequence is AIT → AIP → MHO → RI → ST, supplemented by a direct AIP → RI pathway and a moderating effect of AIAL on the MHO → RI relationship.
To transform the conceptual framework into a falsifiable research program, the article proposes a multi-phase development and validation strategy comprising construct specification, item generation, expert content validation, cognitive interviewing, exploratory factor analysis, confirmatory factor analysis using an independent sample, structural equation modelling, competing-model analysis, measurement invariance testing, and performance-based validation. Two governance artefacts are conceptually developed: the AI Provenance Log for Educational Research (AIPL-ER) and the Meaningful Human Oversight Checklist for Educational Research (MHO-ER). Meaningful oversight is operationalized through the action sequence Inspect → Question → Reject → Modify → Override → Stop → Document → Account.
The central theoretical contribution of RAG-ER lies in four distinctions: disclosure is not governance; transparency is not provenance; human presence is not meaningful human oversight; and AI assistance does not transfer scientific accountability. The framework argues that as the epistemic impact and autonomy of AI increase, requirements for provenance, meaningful human oversight, and human accountability should increase correspondingly. From this perspective, scientific trust should not be inferred from AI capability or sophistication; rather, it must be earned through a research process that remains traceable, verifiable, governable, and accountable.
Keywords: responsible AI governance; AI transparency; AI provenance; meaningful human oversight; research integrity; scientific trust; AI autonomy; generative AI; AI agents; educational research.
- GIỚI THIỆU
1.1. AI từ công cụ hỗ trợ đến hạ tầng nhận thức của nghiên cứu
Trí tuệ nhân tạo đang thay đổi nhanh chóng cấu trúc của lao động nghiên cứu. Trong giai đoạn đầu, các công cụ AI chủ yếu được sử dụng để kiểm tra chính tả, chỉnh sửa ngôn ngữ, dịch thuật hoặc hỗ trợ tìm kiếm. Sự phát triển của GenAI đã mở rộng phạm vi đó sang những nhiệm vụ có hàm lượng nhận thức cao hơn: xây dựng từ khóa, truy xuất tài liệu, tóm tắt bằng chứng, phát hiện khoảng trống, đề xuất câu hỏi nghiên cứu, phát triển khung lý thuyết, tạo mã thống kê, hỗ trợ phân tích dữ liệu, tạo visualization, mã hóa dữ liệu định tính, diễn giải kết quả và soạn thảo bản thảo.
Sự xuất hiện của AI agent và agentic systems tiếp tục thay đổi cấu trúc này. Một hệ thống không còn nhất thiết chờ một prompt riêng biệt cho từng thao tác mà có thể lập kế hoạch, lựa chọn công cụ, thực hiện chuỗi hành động, quan sát intermediate results và điều chỉnh chiến lược. Điều đó làm xuất hiện một quá trình chuyển dịch từ AI as tool sang AI as delegated research actor.
Sự chuyển dịch này không có nghĩa AI trở thành tác giả khoa học hoặc chủ thể đạo đức. Nó có nghĩa một phần quyền thực hiện hành động trước đây thuộc về researcher được ủy quyền cho hệ thống. Khi quyền hành động được phân phối lại, cấu trúc governance cũng phải thay đổi.
Nếu AI chỉ chỉnh lỗi ngữ pháp, câu hỏi governance có thể tương đối đơn giản. Khi AI lựa chọn nguồn cho systematic review, sửa preprocessing pipeline, tạo statistical model hoặc đề xuất scientific conclusion, tác động của AI không còn thuần túy ngôn ngữ. Nó trở thành epistemically material.
Vì vậy, câu hỏi nghiên cứu quan trọng không còn là:
“AI có được sử dụng hay không?”
mà là:
“AI đã tham gia vào quyết định nào, dựa trên input nào, tạo ra output nào, output được kiểm chứng ra sao, con người có đủ khả năng và quyền lực để can thiệp hay không, và ai chịu trách nhiệm đối với scientific claim cuối cùng?”
Đây là điểm xuất phát của RAG-ER.
1.2. Năng lực tính toán tăng không làm giảm trách nhiệm khoa học
Nghiên cứu khoa học không được xác định chỉ bằng khả năng tạo ra output. Một kết luận khoa học phải được bảo vệ bằng chuỗi quan hệ giữa vấn đề, bằng chứng, thiết kế, dữ liệu, phân tích và suy luận.
Williamson và Johanson (2018) nhấn mạnh mối liên hệ giữa câu hỏi, bối cảnh và lựa chọn phương pháp. Lazar et al. (2017) đặt research design, measurement, data và analysis trong một hệ thống liên kết. Trong môi trường AI và machine learning, Nisbet et al. (2024) tiếp tục cho thấy data preparation, modelling và evaluation phải được xem như các giai đoạn phụ thuộc lẫn nhau.
AI có thể tăng tốc từng thành phần của chuỗi nhưng không tự động tạo ra methodological coherence. Một system có thể:
- tạo code chạy chính xác nhưng cho một model không phù hợp;
- viết một literature synthesis mạch lạc dựa trên source selection thiếu cân bằng;
- tạo reference có hình thức hợp lý nhưng không tồn tại;
- đưa ra causal explanation từ correlational evidence;
- hoặc tạo một statistical interpretation không tương xứng với effect size và uncertainty.
Điểm cốt lõi là:
Technical execution ≠ Scientific validity.
Sự gia tăng computational capability vì thế không làm giảm vai trò của governance. Trái lại, khi con người ít trực tiếp thực hiện các bước kỹ thuật hơn, yêu cầu kiểm chứng logic, provenance, methodological fit và accountability trở nên mạnh hơn.
1.3. Disclosure là cần thiết nhưng chưa đủ
Nhiều response ban đầu của các trường đại học và tạp chí đối với GenAI tập trung vào disclosure: tác giả hoặc người học phải khai báo có sử dụng AI hay không.
Disclosure đóng vai trò quan trọng vì nó làm sự tham gia của AI trở nên nhìn thấy. Tuy nhiên, disclosure không tự nó trả lời:
AI đã xử lý loại dữ liệu nào?
Output nào được tạo?
Output nào được đưa vào manuscript?
Ai kiểm tra?
Dựa trên nguồn nào?
Những thay đổi nào được thực hiện?
Ai phê duyệt?
Một statement như:
“Generative AI was used to assist the literature review”
có thể đáp ứng yêu cầu công bố ở mức cơ bản nhưng gần như không tạo khả năng audit.
Do đó:
Disclosure is necessary for transparency, but disclosure alone is not governance.
1.4. Transparency không đồng nhất với provenance
Transparency và provenance thường được thảo luận gần nhau nhưng chúng giải quyết hai vấn đề khác nhau.
Transparency trả lời:
“AI involvement có được nhìn thấy và giải thích hay không?”
Provenance trả lời:
“Có thể tái dựng những gì đã xảy ra hay không?”
Ví dụ, một research team có thể công bố rằng GenAI được sử dụng để đề xuất preliminary thematic categories. Đây là transparency.
Nhưng nếu team không còn record về:
- input được cung cấp;
- categories AI đề xuất;
- categories bị loại;
- lý do loại;
- phần nào được sửa;
- và ai đưa ra final coding decision,
thì process vẫn thiếu provenance.
Bởi vậy:
Transparency = Visibility.
Trong khi:
Provenance = Reconstructability.
RAG-ER xem sự phân biệt này như một khoảng trống trọng tâm của responsible AI governance trong nghiên cứu.
1.5. Human-in-the-loop không đồng nghĩa với meaningful oversight
Một giả định khác thường xuất hiện trong discourse về AI governance là sự hiện diện của con người đủ bảo đảm kiểm soát.
Tuy nhiên, một người có thể “in the loop” nhưng:
không được xem full output;
không có source access;
không hiểu phương pháp;
không có quyền thay đổi system;
không có thời gian đánh giá;
hoặc chịu automation bias mạnh.
Trong trường hợp đó, human presence có tính nghi thức hơn là governance.
Sterz et al. (2024) cho rằng effective oversight đòi hỏi causal power và epistemic access, cùng các điều kiện liên quan đến self-control và intention. Trong nghiên cứu khoa học, insight này có thể được mở rộng thành bốn yêu cầu:
Epistemic Access.
Critical Scientific Judgment.
Intervention Authority.
Accountability.
Một researcher phải vừa có đủ thông tin để hiểu vấn đề, vừa có đủ kiến thức để đánh giá, vừa có đủ quyền để can thiệp, vừa tiếp tục chịu trách nhiệm cho quyết định cuối cùng.
Do đó:
Human presence ≠ Human control.
Và:
Human control ≠ Meaningful Human Oversight nếu thiếu epistemic access, judgment hoặc accountability.
1.6. Research Integrity phải được xem như chất lượng của process
ALLEA (2023) đặt reliability, honesty, respect và accountability như các nguyên tắc cốt lõi của research integrity.
Trong môi trường AI, integrity cần được chuyển từ principle sang process requirements.
Một số câu hỏi mới bao gồm:
Participant data có được phép đưa vào external AI system không?
AI-generated citation đã được kiểm chứng chưa?
AI-assisted coding có audit trail không?
Một model selection do AI đề xuất có được methodological review không?
Có ai biết hệ thống đã sửa preprocessing procedure ở đâu không?
Ai chịu trách nhiệm khi output sai được chuyển thành publication claim?
Research Integrity trong RAG-ER vì thế không được hiểu chỉ như đạo đức cá nhân. Nó được xem là:
mức độ research process duy trì accuracy, evidential validity, methodological coherence, responsible data governance, authorship integrity, verifiability, traceability và accountability.
1.7. Từ trust in AI sang calibrated scientific trust
Một hệ thống AI có thể tạo cảm giác tin cậy bằng tốc độ, confidence và fluency. Tuy nhiên, confidence không phải trustworthiness.
Walters và Wilder (2023) cho thấy trong các model được nghiên cứu ở thời điểm 2023, references do AI tạo có thể mang hình thức học thuật nhưng không tồn tại hoặc chứa lỗi. Các tỷ lệ lịch sử của nghiên cứu này không được phép suy rộng sang các model hiện tại, nhưng epistemic lesson vẫn còn giá trị:
Fluency ≠ Accuracy.
Tương tự:
Capability ≠ Validity.
Performance ≠ Integrity.
Confidence ≠ Trustworthiness.
Scientific Trust do đó phải được xem như calibrated reliance dựa trên integrity của research process.
RAG-ER đặt:
Research Integrity → Scientific Trust
thay vì:
AI Capability → Scientific Trust.
1.8. Khoảng trống nghiên cứu
Từ literature và governance practice có thể xác định năm khoảng trống.
Khoảng trống thứ nhất – Disclosure gap. Chính sách ngày càng yêu cầu khai báo AI use nhưng disclosure không tạo đầy đủ traceability.
Khoảng trống thứ hai – Provenance gap. AI provenance thường được xem như technical metadata trong khi vai trò của nó đối với research governance chưa được operationalize đầy đủ.
Khoảng trống thứ ba – Oversight gap. Human oversight thường được mô tả ở mức principle nhưng chưa được chuyển thành một cấu trúc có thể đo thông qua epistemic access, judgment, intervention và accountability.
Khoảng trống thứ tư – Autonomy gap. Nhiều framework áp dụng governance tương đối đồng nhất cho các loại AI trong khi assistant và autonomous agent tạo mức delegated agency rất khác nhau.
Khoảng trống thứ năm – Scientific trust gap. Trust thường được nghiên cứu như trust in AI, nhưng ít framework đặt trust đối với scientific process downstream của demonstrated integrity.
1.9. Mục tiêu nghiên cứu
Bài viết có năm mục tiêu.
Thứ nhất, phát triển một architecture lý thuyết của Responsible AI Governance cho nghiên cứu giáo dục.
Thứ hai, phân biệt AIT, AIP, MHO, RI và ST thành các construct có ranh giới rõ.
Thứ ba, đưa AIAL vào như boundary condition.
Thứ tư, operationalize RAG-ER thành một chương trình scale-development và empirical validation có khả năng phản bác.
Thứ năm, phát triển governance artefacts có khả năng chuyển giao vào thesis, project, journal manuscript và institutional policy.
- QUẢN TRỊ AI CÓ TRÁCH NHIỆM TRONG NGHIÊN CỨU GIÁO DỤC
Responsible AI Governance có thể được định nghĩa như hệ thống phối hợp principles, records, decision rights, control mechanisms, accountability structures và evaluation practices nhằm duy trì trustworthy AI-mediated activity xuyên vòng đời.
NIST AI RMF và GenAI Profile nhấn mạnh governance theo lifecycle và context thay vì chỉ kiểm tra final output (Autio et al., 2024; National Institute of Standards and Technology, 2023). UNESCO (Miao & Holmes, 2023) nhấn mạnh human agency, ethics, privacy và responsibility. OECD (2024) liên kết transparency, traceability, human agency và accountability. EU AI Act tạo thêm nền tảng cho risk-proportionate human oversight.
Các định hướng này có thể được tích hợp cho nghiên cứu giáo dục theo logic:
AI Use → Disclosure → Governance → Scientific Accountability.
AI Use là sự kiện công nghệ.
Disclosure làm AI involvement trở nên nhìn thấy.
Governance tạo traceability và control.
Scientific Accountability xác lập ai có nghĩa vụ biện minh scientific claim.
RAG-ER định nghĩa:
Quản trị AI có trách nhiệm trong nghiên cứu giáo dục là hệ thống phối hợp AI transparency, provenance, verification, decision rights, human intervention và accountability nhằm bảo đảm quá trình sản xuất tri thức có AI hỗ trợ vẫn có thể được truy nguyên, phản biện, kiểm chứng và quy trách nhiệm khoa học.
Định nghĩa này chuyển object of governance từ AI tool sang AI-mediated knowledge production.
Cấu trúc cơ chế mở rộng là:
Visibility → Traceability → Epistemic Access → Intervention → Integrity → Calibrated Scientific Trust.
- AI TRANSPARENCY
3.1. Định nghĩa
AI Transparency là mức độ AI involvement được trình bày bằng thông tin có ý nghĩa, đủ cụ thể và phù hợp với context để stakeholders hiểu AI đã tham gia ở đâu, nhằm mục đích gì, với vai trò và mức ảnh hưởng nào.
Một transparency statement có chất lượng cần trả lời:
AI nào?
Dùng ở giai đoạn nào?
Dùng để làm gì?
Vai trò là hỗ trợ hay autonomous?
Output nào ảnh hưởng tới scientific product?
3.2. Transparency như visibility
Transparency tạo visibility nhưng không nhất thiết tạo auditability.
Ví dụ:
“AI was used for statistical analysis.”
có visibility thấp vì không cho biết AI làm gì.
Một statement tốt hơn:
“An AI coding assistant was used to generate preliminary R code for model estimation. The code was reviewed line by line, tested against independently specified analyses, and modified by the researcher before execution.”
Statement thứ hai cung cấp scope, purpose và oversight nhưng vẫn không nhất thiết cung cấp full production history.
Do đó:
AIT = informational visibility.
AIT không đồng nghĩa với provenance.
- AI PROVENANCE
4.1. Định nghĩa
AI Provenance là mức độ nguồn gốc, trình tự, transformations, verification actions và human decisions liên quan đến một AI-mediated output có thể được tái dựng và audit.
AIP đặt câu hỏi:
“Chuyện gì đã xảy ra từ input đến claim?”
Không chỉ:
“AI nào đã được dùng?”
4.2. Provenance khác metadata
Metadata có thể gồm model name, version và timestamp.
Provenance rộng hơn:
Input → AI Action → Output → Verification → Human Modification → Decision → Claim.
Một system log đầy technical metadata nhưng không cho biết researcher đã sử dụng output nào vẫn có governance value hạn chế.
4.3. Provenance khác citation
Citation cho biết intellectual origin của idea/evidence.
Provenance cho biết production history của AI-mediated artifact.
Một manuscript có citations hoàn hảo nhưng vẫn có thể thiếu provenance nếu AI thay đổi analytic procedure mà không có record.
4.4. AIPL-ER
RAG-ER đề xuất AI Provenance Log for Educational Research – AIPL-ER.
Các trường thông tin có thể gồm:
AI system;
model/version;
date;
purpose;
research stage;
input category;
sensitive-data status;
material prompt/instruction;
output retained;
human modifications;
verification method;
independent source;
human decision;
responsible researcher;
final accountability.
4.5. Proportional provenance
Không phải mọi interaction cần cùng mức documentation.
Một grammar correction và một agent-driven systematic review tạo epistemic risk khác nhau.
RAG-ER đề xuất:
Provenance Requirement = f(Epistemic Materiality, AI Autonomy, Decision Consequence).
Hay:
Epistemic impact ↑ + Autonomy ↑ → Provenance requirement ↑.
Điều này tránh cả hai cực: không ghi gì và lưu mọi interaction một cách không khả thi.
- MEANINGFUL HUMAN OVERSIGHT
5.1. Định nghĩa
RAG-ER định nghĩa Meaningful Human Oversight là:
năng lực có thể chứng minh về epistemic access, critical scientific judgment, intervention authority và accountability, cho phép researcher hiểu AI activity có liên quan, đánh giá validity, can thiệp vào action hoặc consequence của system và tiếp tục chịu trách nhiệm đối với scientific decision cuối cùng.
5.2. Bốn thành tố
Epistemic Access
Người giám sát có đủ access tới input, output, source, assumptions và material record.
Không có access, oversight trở thành phỏng đoán.
Critical Scientific Judgment
Người giám sát đủ methodological competence để nhận diện lỗi.
Một researcher có access đến code nhưng không hiểu model assumption chưa tạo meaningful oversight.
Intervention Authority
Người giám sát có quyền reject, modify, override hoặc stop.
Review không có authority là symbolic oversight.
Accountability
Human decision maker tiếp tục chịu trách nhiệm.
Documentation không tự tạo accountability.
5.3. Chuỗi hành động MHO
Inspect → Question → Reject → Modify → Override → Stop → Document → Account.
Inspect: kiểm tra input, output, evidence và records.
Question: chất vấn logic và evidence.
Reject: loại bỏ output không đủ căn cứ.
Modify: sửa output hoặc workflow.
Override: thay AI recommendation bằng human decision.
Stop: dừng workflow khi risk không thể kiểm soát.
Document: tạo audit trail.
Account: nhận responsibility cho final decision.
5.4. Failure modes
Automation bias
Human accepts AI because output appears confident or technically sophisticated.
Epistemic asymmetry
Human lacks expertise to evaluate AI work.
Authority asymmetry
Human recognizes error but lacks authority to intervene.
Ba failure modes cho thấy:
Human presence does not guarantee meaningful oversight.
- RESEARCH INTEGRITY VÀ SCIENTIFIC TRUST
6.1. Research Integrity
RAG-ER xem RI là process-level outcome.
RI bao gồm:
accuracy;
evidential validity;
methodological coherence;
responsible data governance;
authorship integrity;
source verification;
reproducibility hoặc appropriate traceability;
scientific accountability.
Construct contamination cần được tránh.
AIT hỏi: AI involvement có visible không?
AIP hỏi: history có reconstructable không?
MHO hỏi: human có thể hiểu và can thiệp không?
RI hỏi: process có duy trì scientific standards không?
6.2. Scientific Trust
ST là justified confidence rằng research process và claims đủ integrity để stakeholders có thể dựa vào một cách hợp lý.
ST không phải trust in AI.
ST cũng không phải maximal trust.
Nó là calibrated scientific trust.
Logic:
RI → Verifiability → Reliability → Calibrated Trust.
Trust phải tương xứng với evidence.
- KHUNG LÝ THUYẾT VÀ GIẢ THUYẾT
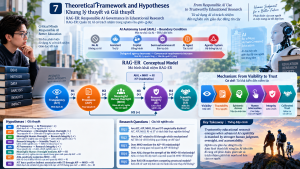
7.1. Kiến trúc RAG-ER
Mô hình chính:
AIT → AIP → MHO → RI → ST
Đường trực tiếp:
AIP → RI
Điều kiện biên:
AIAL × MHO → RI
Mechanism:
Visibility → Traceability → Epistemic Access → Human Intervention → Integrity → Calibrated Trust.
7.2. H1: AIT → AIP
Transparency requirements có thể thúc đẩy provenance practices vì meaningful disclosure cần records.
H1. AI Transparency có quan hệ tích cực với AI Provenance.
Đây là directional hypothesis, không phải causal fact.
Reverse model AIP → AIT phải được kiểm tra.
7.3. H2: AIP → MHO
Provenance cung cấp epistemic access cần cho oversight.
H2. AI Provenance có quan hệ tích cực với Meaningful Human Oversight.
7.4. H3: MHO → RI
MHO giúp phát hiện và ngăn AI error trở thành scientific error.
H3. Meaningful Human Oversight có quan hệ tích cực với Research Integrity.
7.5. H4: RI → ST
Scientific trust cần dựa trên demonstrated integrity.
H4. Research Integrity có quan hệ tích cực với Scientific Trust.
7.6. H5: AIP → RI
Provenance hỗ trợ auditability, attribution, reproducibility và error localization.
H5. AI Provenance có quan hệ tích cực với Research Integrity.
7.7. H6: Mediation của MHO
Provenance chỉ tạo record. Human oversight chuyển record thành action.
H6. MHO trung gian mối quan hệ giữa AIP và RI.
7.8. H7: AI Autonomy Level
AIAL là mức AI có thể khởi tạo, tổ chức, thực hiện, điều chỉnh hoặc hoàn thành research action mà không cần simultaneous human approval.
Continuum:
No AI → Assistant → Copilot → Semi-autonomous AI → AI Agent → Agentic System.
Khi delegated agency tăng, governance exposure tăng.
H7. AIAL điều tiết tích cực quan hệ MHO–RI, theo đó mối liên hệ tích cực giữa MHO và RI mạnh hơn khi AI autonomy cao hơn.
7.9. H8: Serial indirect effect
H8. AIT có indirect association tích cực với ST thông qua chuỗi AIP → MHO → RI.
7.10. Research Questions
RQ1: AIT, AIP, MHO, RI và ST có empirically distinct không?
RQ2: AIT liên hệ với RI thông qua mechanisms nào?
RQ3: MHO có trung gian AIP–RI không?
RQ4: AIAL có thay đổi strength của MHO–RI không?
RQ5: RAG-ER có outperform competing structural models không?
- PHƯƠNG PHÁP NGHIÊN CỨU
8.1. Thiết kế tổng thể
Nghiên cứu cần được triển khai dưới dạng:
multi-phase scale development and structural validation study.
Không nên thực hiện EFA, CFA và SEM trên cùng một dataset nếu có thể tránh.
Quy trình:
Construct Specification → Item Generation → Content Validation → Cognitive Interviewing → EFA → Independent CFA → SEM → Competing Models → Invariance → Performance Validation.
8.2. Phase 1 – Construct specification
Literature review cần bao phủ:
responsible AI;
AI transparency;
provenance;
traceability;
meaningful human oversight;
research integrity;
scientific trust;
AI autonomy.
Mục tiêu là xác định domain boundaries.
Đặc biệt cần làm rõ:
AIT ≠ AIP;
AIP ≠ MHO;
MHO ≠ RI;
RI ≠ ST.
Nếu theoretical boundaries yếu, statistical discriminant validity khó có ý nghĩa.
8.3. Phase 2 – Item generation
Khoảng 10–12 initial items/construct có thể được phát triển.
Items nên tập trung behaviour và capability.
AIT item:
“Tôi công bố AI được sử dụng trong các research tasks có ảnh hưởng đáng kể.”
AIP item:
“Tôi có thể truy nguyên một material AI output tới input, verification và decision liên quan.”
MHO item:
“Tôi có thể dừng AI-assisted workflow nếu output không thể được bảo vệ bằng evidence.”
RI item:
“AI-assisted claim chỉ được giữ lại sau appropriate independent verification.”
ST item:
“Tôi chỉ dựa vào AI-assisted research output khi process tạo output có thể được kiểm chứng.”
AIAL item:
“AI system có thể điều chỉnh chuỗi research actions mà không cần approval cho từng bước.”
8.4. Participants
Participants nên có research experience thực tế.
Các nhóm ưu tiên:
postgraduate students;
doctoral candidates;
early-career researchers;
university lecturers;
researchers.
Eligibility nên yêu cầu:
ít nhất một thesis, dissertation, research project hoặc manuscript experience;
và đã sử dụng GenAI trong ít nhất một research-related task.
8.5. Sample size
Total target:
N ≈ 700–1.000.
Một allocation khả thi:
EFA: 250–350.
CFA/SEM: 450–650.
Không nên coi đây là fixed rule.
Final N cần được hỗ trợ bằng power analysis hoặc Monte Carlo simulation.
8.6. Content validation
Expert panel khoảng 10–15 người.
Expertise:
research methods;
psychometrics;
AI governance;
educational technology;
research integrity.
Các dimension đánh giá:
relevance;
clarity;
representativeness;
construct specificity.
Metrics:
I-CVI;
S-CVI/Ave;
modified κ.
Construct assignment disagreement phải được xem như theoretical warning chứ không chỉ statistical nuisance.
8.7. Cognitive interviews
15–30 participants.
Kỹ thuật:
think-aloud;
paraphrasing;
comprehension probes;
judgment probes.
Các thuật ngữ ưu tiên:
provenance;
oversight;
override;
accountability;
autonomy;
scientific trust.
Ví dụ:
“Khi đọc ‘override AI’, anh/chị nghĩ mình cần thực hiện hành động cụ thể nào?”
Cognitive interviews tạo response-process validity evidence mà CFA không thể thay thế.
8.8. Exploratory Factor Analysis
Kiểm tra:
missingness;
distribution;
floor/ceiling effects;
KMO;
Bartlett;
parallel analysis;
loadings;
cross-loadings;
communalities;
factor interpretability.
Không sử dụng eigenvalue > 1 như criterion duy nhất.
Item retention cần kết hợp statistical performance với content coverage.
8.9. Confirmatory Factor Analysis
CFA sử dụng independent sample.
Competing measurement models:
C1 – One-factor model.
C2 – Five correlated constructs.
C3 – Higher-order governance factor, chỉ khi theory và data hỗ trợ.
C4 – Collapsed-factor alternatives, chẳng hạn AIT+AIP hoặc MHO+RI.
Báo cáo:
χ²;
CFI;
TLI;
RMSEA + 95% CI;
SRMR.
Không dùng một cutoff duy nhất để quyết định model validity.
8.10. Reliability
Báo cáo:
Cronbach’s α;
McDonald’s ω;
Composite Reliability.
Alpha không nên là reliability indicator duy nhất.
8.11. Convergent validity
Kiểm tra:
standardized loading;
CR;
AVE.
Low AVE cần được đánh giá cùng theoretical coverage và reliability thay vì loại item máy móc.
8.12. Discriminant validity
HTMT được ưu tiên.
Các cặp nguy cơ cao:
AIT–AIP;
AIP–MHO;
MHO–RI;
RI–ST.
Nếu HTMT quá cao, researcher phải xem lại construct definition trước khi thêm correlated residuals.
8.13. Structural Equation Modelling
Structural model:
AIT → AIP;
AIP → MHO;
MHO → RI;
AIP → RI;
RI → ST.
Mediation:
5.000 bootstrap samples.
Báo cáo:
standardized β;
SE;
95% CI;
p;
R²;
direct effect;
indirect effect;
total effect.
Với cross-sectional data, sử dụng ngôn ngữ:
“associated with”;
“consistent with”;
“supports the hypothesized mechanism”.
Không viết:
“causes”.
8.14. Moderation
H7:
MHO × AIAL → RI.
Không median split AIAL.
Có thể dùng:
latent interaction;
product indicators;
observed interaction nếu justification đủ mạnh.
Báo cáo simple slopes ở low, medium và high AIAL.
8.15. Competing structural models
Đây là phần bắt buộc.
M1: AIT → AIP → MHO → RI → ST.
M2: AIP → AIT → MHO → RI → ST.
M3: AIT và AIP song song → MHO → RI → ST.
M4: AIT, AIP, MHO trực tiếp → RI → ST.
So sánh:
fit;
parsimony;
theoretical plausibility;
predictive performance.
Nếu M3 outperform M1, conclusion phải thay đổi.
Theory phải phục tùng evidence.
8.16. Measurement invariance
Các nhóm:
graduate students vs researchers;
STEM vs social sciences/education;
low vs high AI experience;
assistant-level vs agentic-AI experience.
Chuỗi:
Configural → Metric → Scalar → Strict, nếu phù hợp.
Chỉ so latent means khi mức invariance cần thiết được hỗ trợ.
8.17. Common-method bias
Procedural remedies:
anonymity;
item separation;
randomization;
temporal separation;
performance criterion.
Có thể bổ sung common latent method factor.
Harman single-factor test không đủ.
8.18. Performance-based validation
RAG-ER cần vượt self-report.
Đề xuất:
Responsible AI Research Governance Scenario.
Một AI agent thực hiện:
literature search;
screening;
synthesis;
code generation;
analysis;
conclusion.
Case chứa governance failures:
fabricated citation;
personal data exposure;
unauthorized change in inclusion criterion;
unsupported causal claim;
incomplete provenance record.
Participant phải:
Inspect;
Question;
Accept/Reject;
Modify;
Override;
Stop;
Document;
Account.
Performance score tạo criterion validity evidence cho MHO.
Điều này kiểm tra:
Perceived oversight ≠ Demonstrated oversight.
8.19. AI Governance của chính nghiên cứu
RAG-ER phải áp dụng principles của mình vào chính study workflow.
Nếu AI được sử dụng cho:
search;
translation;
coding;
analysis;
summarization;
drafting;
cần ghi ít nhất:
tool;
purpose;
data category;
material output;
verification;
human disposition.
Participant raw data không nên được đưa vào external AI system nếu chưa có ethics, consent, privacy và contractual safeguards thích hợp.
Nguyên tắc phản tư:
A governance framework should be capable of governing the process by which the framework itself is developed.
- PLANNED ANALYSIS AND REPORTING ARCHITECTURE
Ở giai đoạn hiện tại, RAG-ER là theoretical development and validation protocol.
Chưa có dataset thực nghiệm.
Do đó không được điền:
factor loading;
CFI;
TLI;
RMSEA;
β;
p;
R²;
indirect effects;
hoặc moderation coefficients giả định.
Fabricated results sẽ mâu thuẫn trực tiếp với Research Integrity.
Khi empirical study được thực hiện, Results nên theo thứ tự:
- sample characteristics;
- item development;
- content validity;
- cognitive interviewing;
- EFA;
- CFA;
- reliability;
- convergent validity;
- discriminant validity;
- competing measurement models;
- structural paths;
- mediation;
- moderation;
- competing structural models;
- invariance;
- performance validity.
Các reporting tables có thể được preregistered hoặc pre-specified nhưng numeric cells phải để trống cho đến khi actual analysis hoàn thành.
- THẢO LUẬN
10.1. Từ disclosure sang governance
Đóng góp thứ nhất của RAG-ER là tái định vị disclosure như entry condition, không phải end point.
Disclosure tạo visibility.
Governance đòi hỏi:
visibility;
traceability;
intervention;
accountability.
Vì vậy:
Disclosure is not governance.
Một article có AI declaration hoàn chỉnh vẫn có thể governance yếu nếu output không được verified.
10.2. Transparency và provenance là hai construct khác nhau
Novelty quan trọng của RAG-ER nằm ở distinction:
Transparency tells us that and how AI was involved.
Provenance allows us to reconstruct what happened.
Transparency có thể đạt cao ở mức communicative nhưng provenance vẫn thấp.
Điều ngược lại cũng có thể xảy ra: một research lab có detailed internal log nhưng disclosure ra ngoài yếu.
Chính khả năng hai construct tách biệt này tạo cơ sở cho discriminant validity testing.
10.3. Provenance tạo điều kiện nhận thức, không tự tạo governance
AIP không phải sufficient condition cho RI.
Một log không được xem xét không bảo vệ scientific process.
Provenance tạo epistemic access.
Human oversight biến access thành action.
Mechanism:
AIP → Epistemic Access → MHO.
Điều này giải thích vì sao MHO được đặt như mediator.
10.4. Oversight là năng lực hành động
RAG-ER chuyển MHO từ “principle” sang sequence of actions.
Inspect xác định evidence.
Question tạo critical challenge.
Reject, Modify và Override thay đổi outcome.
Stop giới hạn damage.
Document bảo vệ auditability.
Account gắn final responsibility.
Vì vậy:
Provenance without oversight = records without governance.
10.5. AI autonomy làm governance trở thành vấn đề tỷ lệ
Không phải mọi AI use cần cùng governance intensity.
Grammar checker và autonomous agent không tương đương.
Khi autonomy tăng, AI có thể:
tự chọn action;
tự điều chỉnh plan;
tự sử dụng tool;
tự tạo downstream consequences.
Vì vậy:
AI autonomy ↑ → delegated agency ↑ → governance exposure ↑.
AIAL làm cho RAG-ER chuyển từ static governance sang autonomy-sensitive governance.
10.6. Scientific Trust phải earned through integrity
Một trong những lỗi nhận thức lớn của AI era là đánh đồng performance với trustworthiness.
Một system tạo câu trả lời đẹp không đảm bảo:
source đúng;
data đúng;
method đúng;
inference đúng.
RAG-ER do đó khẳng định:
Scientific Trust should be an outcome of Research Integrity, not an inference from AI sophistication.
Đây là calibrated trust.
10.7. Accountability không được chuyển giao
Porsdam Mann et al. (2024) nhấn mạnh human contribution, vetting và responsibility trong scholarly AI use.
Điều này phù hợp với RAG-ER:
AI có thể thực thi.
AI có thể recommend.
AI có thể generate.
Nhưng scientific accountability vẫn thuộc về con người.
Do đó:
AI execution ≠ transfer of scientific responsibility.
10.8. Từ principles sang mechanisms
Responsible AI thường được mô tả qua:
fairness;
transparency;
accountability;
safety;
human control.
RAG-ER không thay thế principles.
Nó bổ sung cơ chế:
Visibility → Traceability → Epistemic Access → Intervention → Integrity → Calibrated Trust.
Nhờ vậy có thể nhận diện bốn failure configurations.
Transparency without provenance
AI involvement visible nhưng history không reconstructable.
Provenance without oversight
Records tồn tại nhưng không được sử dụng để challenge hoặc intervene.
Oversight without authority
Human reviewer có mặt nhưng không đủ quyền.
Trust without integrity
Confidence được tạo từ output quality thay vì evidence quality.
Bốn configurations này tạo nền tảng cho các nghiên cứu tiếp theo về governance failure.
- ĐÓNG GÓP LÝ THUYẾT
11.1. Governance chain
Đóng góp đầu tiên là architecture:
Transparency → Provenance → Meaningful Human Oversight → Research Integrity → Scientific Trust.
Đây không chỉ là sequence of variables mà là mechanism proposition.
11.2. AIP như một research-governance construct
AIP được operationalize như reconstructability của AI-mediated knowledge production.
Nó mở rộng provenance từ metadata thành governance capability.
11.3. MHO như multidimensional oversight capability
MHO được cấu thành bởi:
Epistemic Access + Critical Judgment + Intervention Authority + Accountability.
Đây là distinction quan trọng giữa oversight thực chất và human presence.
11.4. Autonomy-sensitive governance
AIAL đưa delegated agency vào model.
Logic:
AI autonomy ↑ → Oversight requirement ↑.
Điều này làm RAG-ER thích hợp cho cả GenAI hiện tại và emerging agentic AI.
11.5. Scientific Trust downstream của RI
Trust không được xem như attitude đối với AI.
Nó là justified reliance đối với research process.
Điều này tạo kết nối trực tiếp giữa responsible AI governance và philosophy of scientific reliability.
11.6. Human accountability trong agentic environment
Ngay khi AI có khả năng thực thi chuỗi actions, RAG-ER vẫn giữ:
Human scientific accountability as non-delegable.
Đây là normative anchor của model.
- HÀM Ý THỰC HÀNH
12.1. RAG-ER Scale
Một scale được validation tốt có thể đánh giá profile của:
AIT;
AIP;
MHO;
RI;
ST;
và AIAL.
Điều này cho phép institutions chẩn đoán điểm yếu cụ thể thay vì chỉ hỏi người dùng “có sử dụng AI có trách nhiệm hay không”.
12.2. AIPL-ER
AIPL-ER có thể được tích hợp vào:
thesis;
dissertation;
research projects;
journal articles;
ethics review;
research data management.
Không nhất thiết công bố toàn bộ log. Mục tiêu là tạo internal auditability và cung cấp material records khi cần.
12.3. MHO-ER Checklist
Checklist:
Inspect → Question → Reject → Modify → Override → Stop → Document → Account.
Checklist này có thể dùng trong:
research training;
doctoral supervision;
research governance;
ethics committee review;
AI-assisted analysis.
12.4. Từ tool-based policy sang risk-based governance
Institutional policy thường hỏi:
“Tool này được phép hay không?”
RAG-ER đề xuất hỏi:
“AI đang thực hiện function gì?”
“Epistemic impact bao nhiêu?”
“Autonomy bao nhiêu?”
“Provenance cần mức nào?”
“Human intervention cần mức nào?”
Đây là chuyển dịch:
Tool-based policy → Function- and risk-based governance.
12.5. Implications for research training
Training không nên chỉ dạy prompt engineering.
Cần đào tạo:
evidence verification;
provenance management;
methodological reasoning;
AI risk assessment;
override capability;
accountability.
Một researcher biết prompt nhưng không biết reject AI output chưa có meaningful oversight.
12.6. Implications for publishers và reviewers
Khi AI tham gia substantive methodology, reviewer có thể cần biết không chỉ AI được dùng mà còn governance evidence liên quan.
RAG-ER không đề xuất disclosure unlimited.
Nó đề xuất proportional documentation tương xứng epistemic impact.
- HẠN CHẾ VÀ HƯỚNG NGHIÊN CỨU TƯƠNG LAI
RAG-ER có một số giới hạn cần được xác định rõ.
Thứ nhất, đây là theoretical model và validation protocol. Các structural relationships chưa phải empirical findings.
Thứ hai, AIT → AIP có thể reciprocal. Provenance tốt có thể tạo transparency tốt hơn. Vì vậy competing models là bắt buộc.
Thứ ba, self-reported MHO có thể chịu metacognitive bias. Một người có thể tin mình có khả năng override nhưng performance task cho kết quả khác.
Thứ tư, AIAL thay đổi nhanh theo technological development. Items nên đo autonomy level thay vì product category cố định.
Thứ năm, RI có disciplinary variation. Quantitative, qualitative và mixed-methods traditions có những chuẩn justification khác nhau.
Thứ sáu, Scientific Trust có thể khác theo stakeholder. Reviewer, researcher, editor, participant và public có thể sử dụng evidence khác nhau để calibrate trust.
Thứ bảy, framework được phát triển trong bối cảnh giáo dục và cần cross-domain validation trước khi mở rộng sang y sinh, engineering hoặc corporate research.
Nghiên cứu tiếp theo nên ưu tiên longitudinal designs, cross-country validation, disciplinary invariance và experimental manipulation.
Một experimental design đặc biệt hữu ích là randomize participants vào ba conditions:
AI Assistant.
AI Copilot.
AI Agent.
Sau đó giữ research task tương đương và kiểm tra:
MHO behavior;
error detection;
intervention;
Research Integrity outcomes.
Nếu MHO đặc biệt có giá trị ở high-autonomy condition, bằng chứng sẽ hỗ trợ mạnh H7 hơn cross-sectional moderation.
- KẾT LUẬN
GenAI và Agentic AI đang mở rộng đáng kể khả năng thực hiện nghiên cứu, đồng thời tái phân phối agency trong quá trình sản xuất tri thức. Khi AI ngày càng tham gia sâu vào literature retrieval, screening, coding, analysis, interpretation và writing, governance không thể tiếp tục được giản lược thành disclosure. Sự tham gia của AI không còn chỉ là một sự kiện kỹ thuật cần được công bố, mà đã trở thành một yếu tố cấu trúc định hình cách tri thức khoa học được tạo ra, kiểm chứng và biện minh.
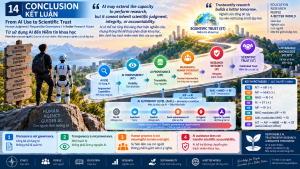
RAG-ER đề xuất quá trình chuyển đổi:
AI Use → Visibility → Traceability → Meaningful Oversight → Research Integrity → Scientific Trust.
Kiến trúc trung tâm:
AIT → AIP → MHO → RI → ST
cùng với:
AIP → RI
và:
AIAL × MHO → RI.
Đóng góp đầu tiên của RAG-ER là phân biệt transparency với provenance. Transparency làm AI involvement trở nên visible; provenance làm production history trở nên reconstructable. Sự phân biệt này có ý nghĩa nhận thức luận sâu sắc: một tuyên bố minh bạch rằng “AI đã được sử dụng” không cung cấp đủ cơ sở để tái dựng điều gì đã thực sự xảy ra trong quá trình nghiên cứu. Chỉ khi provenance được thiết lập, cộng đồng khoa học mới có thể kiểm toán các quyết định, phát hiện các lỗi tiềm ẩn và quy trách nhiệm cho các tuyên bố khoa học.
Đóng góp thứ hai là tái khái niệm hóa meaningful human oversight. Một human-in-the-loop chỉ có ý nghĩa governance khi con người có epistemic access, critical judgment, intervention authority và accountability. Sự hiện diện đơn thuần của con người trong workflow không chứng minh rằng con người thực sự hiểu, đánh giá và có khả năng can thiệp vào các quyết định của hệ thống. Meaningful oversight đòi hỏi một cấu trúc quyền lực và năng lực nhận thức cụ thể, không chỉ là một vị trí trong quy trình.
Đóng góp thứ ba là đưa AI autonomy thành boundary condition. Khi AI chuyển từ assistant sang copilot và agent, delegated agency tăng và yêu cầu provenance/oversight cũng phải tăng. Điều này có nghĩa là governance không thể áp dụng một chính sách đồng nhất cho mọi mức độ tự chủ của AI. Một công cụ chỉnh sửa ngữ pháp và một AI agent tự thực hiện chuỗi hành động nghiên cứu đòi hỏi các mức độ kiểm soát, ghi nhận và trách nhiệm hoàn toàn khác nhau.
Đóng góp thứ tư là đặt Scientific Trust sau Research Integrity. Trust không nên được suy ra từ AI performance, confidence hay fluency. Nó phải được tạo ra từ một scientific process đủ traceable, verifiable và accountable. Đây là sự đảo ngược logic thông thường trong AI trust literature: thay vì hỏi “AI có đáng tin không?”, RAG-ER hỏi “quy trình nghiên cứu có đủ liêm chính để niềm tin khoa học được đặt đúng chỗ hay không?”
Bốn mệnh đề cô đọng toàn bộ RAG-ER là:
- Disclosure is not governance.
- Transparency is not provenance.
- Human presence is not meaningful human oversight.
- AI assistance does not transfer scientific accountability.
Những mệnh đề này không chỉ là các nguyên tắc chuẩn tắc mà còn là các giả thuyết có thể kiểm định thực nghiệm. Chúng xác lập một chương trình nghiên cứu về governance mechanisms trong AI-assisted knowledge production, đồng thời cung cấp nền tảng lý thuyết cho việc thiết kế các công cụ quản trị cụ thể như AIPL-ER và MHO-ER Checklist.
Trong môi trường agentic research, câu hỏi quyết định sẽ không còn là liệu “một con người có nằm trong vòng lặp” hay không. Câu hỏi quan trọng hơn là liệu con người có duy trì tri thức để phán đoán, bằng chứng để kiểm chứng, quyền lực để can thiệp và trách nhiệm để bảo vệ validity của scientific claim hay không. Đây là thách thức trung tâm mà RAG-ER hướng đến giải quyết: không phải để hạn chế AI, mà để bảo đảm rằng khi AI tham gia ngày càng sâu vào quá trình sản xuất tri thức, các chuẩn mực khoa học vẫn được duy trì và trách nhiệm khoa học vẫn thuộc về con người.
TUYÊN BỐ TÍNH MỚI
RAG-ER chuyển Responsible AI Governance trong nghiên cứu giáo dục từ một tập hợp principles và disclosure requirements sang một testable mechanism architecture.
Mô hình:
- phân biệt AI Transparency với AI Provenance;
- khái niệm hóa provenance như reconstructable production history;
- operationalize Meaningful Human Oversight thành epistemic access, critical judgment, intervention authority và accountability;
- giới thiệu AI Autonomy Level như boundary condition;
- đặt Scientific Trust downstream của Research Integrity;
- phát triển AIPL-ER và MHO-ER như governance artefacts;
- đề xuất chương trình validation kết hợp psychometric evidence với demonstrated performance.
TUYÊN BỐ ĐÓNG GÓP
Đóng góp cơ chế chính của nghiên cứu là:
Visibility → Traceability → Epistemic Access → Intervention → Integrity → Calibrated Scientific Trust.
Đóng góp đo lường nằm ở việc chuyển transparency, provenance và meaningful oversight thành constructs có thể kiểm định bằng expert review, cognitive interviewing, EFA, independent CFA, SEM, competing-model analysis, measurement invariance và performance-based validation.
Đóng góp thực hành nằm ở ba artefacts:
RAG-ER Scale.
AI Provenance Log for Educational Research – AIPL-ER.
Meaningful Human Oversight Checklist for Educational Research – MHO-ER.
TÀI LIỆU THAM KHẢO
- All European Academies. (2023). The European code of conduct for research integrity: 2023 revised edition. ALLEA. https://doi.org/10.26356/ECOC
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association.
- Autio, C., Schwartz, R., Dunietz, J., Jain, S., Stanley, M., Tabassi, E., Hall, P., & Roberts, K. (2024). Artificial intelligence risk management framework: Generative artificial intelligence profile (NIST AI 600-1). National Institute of Standards and Technology. https://doi.org/10.6028/NIST.AI.600-1
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, 149. https://doi.org/10.3389/fpubh.2018.00149
- Do, H. V., Bui, T. T., Tran, D. H., Nguyen, H. T., & Dinh, L. D. (2026). Developing and validating an AI literacy scale for university students in Vietnam. IFLA Journal, 52(2), 222–233. https://doi.org/10.1177/03400352251385058
- European Commission. (2024). Guidelines on the responsible use of generative AI in research. Directorate-General for Research and Innovation.
- European Commission. (2026). Updated ERA living guidelines on the responsible use of generative AI in research. Directorate-General for Research and Innovation.
- European Parliament & Council of the European Union. (2024). Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union.
- González Canché, M. S. (2026). Data science, interactive visualizations, and generative AI tools for the analysis of qualitative, mixed-methods, and multimodal evidence. Elsevier.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage.
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43, 115–135. https://doi.org/10.1007/s11747-014-0403-8
- Lazar, J., Feng, J. H., & Hochheiser, H. (2017). Research methods in human-computer interaction (2nd ed.). Morgan Kaufmann.
- Miao, F., & Holmes, W. (2023). Guidance for generative AI in education and research. UNESCO.
- National Institute of Standards and Technology. (2023). Artificial intelligence risk management framework (AI RMF 1.0). NIST.
- Nisbet, R., Miner, G. D., & McCormick, K. (2024). Handbook of statistical analysis: AI and ML applications (3rd ed.). Academic Press.
- Organisation for Economic Co-operation and Development. (2024). Recommendation of the Council on Artificial Intelligence. OECD.
- Porsdam Mann, S., Vazirani, A. A., Aboy, M., Earp, B. D., Minssen, T., Cohen, I. G., et al. (2024). Guidelines for ethical use and acknowledgement of large language models in academic writing. Nature Machine Intelligence, 6, 1272–1274. https://doi.org/10.1038/s42256-024-00922-7
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004
- Sterz, S., Baum, K., Biewer, S., Hermanns, H., Lauber-Rönsberg, A., Meinel, P., & Langer, M. (2024). On the quest for effectiveness in human oversight: Interdisciplinary perspectives. In Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (pp. 2495–2507). Association for Computing Machinery. https://doi.org/10.1145/3630106.3659051
- Thủ tướng Chính phủ. (2021). Quyết định số 127/QĐ-TTg ngày 26 tháng 01 năm 2021 ban hành Chiến lược quốc gia về nghiên cứu, phát triển và ứng dụng trí tuệ nhân tạo đến năm 2030. Chính phủ Việt Nam.
- Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
- Williamson, K., & Johanson, G. (Eds.). (2018). Research methods: Information, systems, and contexts (2nd ed.). Chandos Publishing.
