
From Generative AI-Assisted Synthesis to Valid Research Gaps: The Roles of Evidence Mapping, Source Verification, and Knowledge Synthesis Quality in Academic Literature Reviews
NGUYỄN VĂN HÙNG
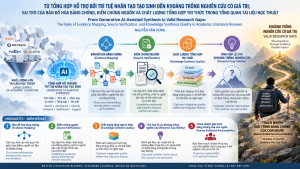
HIGHLIGHTS
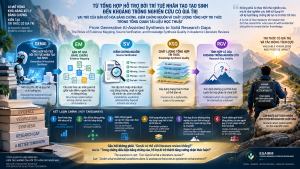
- Bản đồ hóa bằng chứng (Evidence Mapping) cấu trúc hóa các mối quan hệ giữa luận điểm, nguồn tài liệu và bằng chứng.
- Kiểm chứng nguồn (Source Verification) xác lập tính chấp nhận được của bằng chứng, vượt ra ngoài yêu cầu về độ chính xác của trích dẫn.
- Chất lượng tổng hợp tri thức (Knowledge Synthesis Quality) phản ánh năng lực tích hợp bằng chứng thay vì chỉ thể hiện sự trôi chảy về ngôn ngữ.
- Tính hợp lệ của khoảng trống nghiên cứu (Research Gap Validity) đánh giá liệu các tuyên bố về những điều khoa học còn chưa biết có được bằng chứng bảo chứng hay không.
- Trách nhiệm giải trình bằng chứng của con người (Human Evidential Accountability) bảo
TÓM TẮT
Bối cảnh. Trí tuệ nhân tạo tạo sinh (Generative Artificial Intelligence — GenAI) đang tái cấu trúc tổng quan tài liệu học thuật thông qua khả năng hỗ trợ tìm kiếm, tóm tắt, phân loại, so sánh, tổng hợp và đề xuất khoảng trống nghiên cứu. Những chức năng này có thể giảm gánh nặng thủ tục và mở rộng đáng kể quy mô thông tin mà nhà nghiên cứu có thể xử lý. Tuy nhiên, năng lực xử lý cao hơn không tự động tạo ra chất lượng nhận thức luận cao hơn. Tổng quan hỗ trợ bởi AI vẫn có thể chứa nguồn bịa đặt, sai lệch thư mục, trình bày sai nội dung nguồn, tổng hợp chọn lọc, bỏ sót bằng chứng mâu thuẫn và những tuyên bố khoảng trống vượt quá phạm vi mà cơ sở bằng chứng cho phép.
Vấn đề nghiên cứu. Vấn đề trung tâm do đó không còn đơn thuần là liệu GenAI có thể hỗ trợ tổng quan tài liệu hay không, mà là trong những điều kiện bằng chứng nào hỗ trợ của GenAI có thể chuyển hóa thành tổng hợp tri thức có thể bảo vệ và các tuyên bố có căn cứ về những gì khoa học chưa biết. Sự tồn tại của nguồn, độ chính xác thư mục, tính trung thực của diễn giải, sự phù hợp giữa tuyên bố và nguồn, chất lượng tổng hợp và tính hợp lệ của khoảng trống là các chức năng nhận thức luận có liên quan nhưng không đồng nhất.
Mục tiêu. Bài viết phát triển Evidence-Grounded AI Literature Review Model (EGAIRM). Mô hình phân biệt Evidence Mapping (EM) như cơ chế cấu trúc hóa bằng chứng; Source Verification (SV) như cơ chế xác lập tính chấp nhận được của bằng chứng; Knowledge Synthesis Quality (KSQ) như chất lượng tích hợp tri thức xuyên nguồn; và Research Gap Validity (RGV) như kết quả nhận thức luận ở hạ nguồn. Cơ chế trung tâm là:
EM → SV → KSQ → RGV.
Phương pháp đề xuất. Nghiên cứu đề xuất thí nghiệm so sánh ngẫu nhiên ba điều kiện: (A) tổng quan truyền thống; (B) tổng quan hỗ trợ bởi GenAI; và (C) GenAI + EM + SV. Tất cả người tham gia làm việc với cùng một corpus bằng chứng chuẩn hóa nhằm tách biệt năng lực tìm kiếm khỏi chất lượng tổng hợp. Tương phản xác nhận chính là C−B; ước lượng chính là chênh lệch trung bình KSQ giữa hai điều kiện. RGV là kết quả nhận thức luận thứ cấp then chốt. Các kết quả bổ sung gồm độ chính xác trích dẫn, trình bày sai nguồn, tài liệu tham khảo bịa đặt, tích hợp bằng chứng mâu thuẫn, hành vi kiểm chứng, tỷ lệ sử dụng đầu ra AI chưa kiểm chứng và thời gian thực hiện nhiệm vụ.
Đóng góp. EGAIRM chuyển trọng tâm từ AI capability sang epistemic mechanism. Mô hình tái khái niệm hóa research gap từ một sản phẩm tu từ thành một tuyên bố phụ thuộc bằng chứng có thể được đánh giá về tính hợp lệ. Human Evidential Accountability (HEA) được đặt làm nền tảng quản trị: AI có thể tạo các synthesis và gap ứng viên, nhưng trách nhiệm kiểm chứng nguồn, hiệu chỉnh suy luận, xác lập bảo chứng bằng chứng và phê chuẩn tuyên bố khoa học cuối cùng vẫn thuộc về nhà nghiên cứu con người.
Từ khóa: Generative AI; literature review; evidence mapping; source verification; knowledge synthesis; research gap validity; evidence traceability; research integrity; human evidential accountability.
ABSTRACT
Background. Generative Artificial Intelligence (GenAI) is transforming academic literature reviewing by supporting retrieval, summarization, classification, comparison, synthesis, and candidate research-gap generation. These capabilities can reduce procedural burden and expand information-processing capacity. Greater processing capacity, however, does not necessarily produce greater epistemic quality. AI-assisted reviews may contain fabricated references, bibliographic inaccuracies, source misrepresentation, selective synthesis, omitted contradictory evidence, and research-gap claims that exceed what the underlying evidence warrants.
Research problem. The central question is therefore no longer simply whether GenAI can assist literature reviewing, but under what evidential conditions AI assistance can be translated into defensible knowledge synthesis and warranted claims about what remains unknown. Source existence, bibliographic accuracy, content fidelity, claim–source correspondence, synthesis quality, and research-gap validity constitute related but non-equivalent epistemic functions.
Objective. This article develops the Evidence-Grounded AI Literature Review Model (EGAIRM). EGAIRM conceptualizes Evidence Mapping (EM) as an evidence-structuring mechanism, Source Verification (SV) as a mechanism for establishing evidential admissibility, Knowledge Synthesis Quality (KSQ) as the quality of cross-source knowledge integration, and Research Gap Validity (RGV) as a downstream epistemic outcome. Its central mechanism is EM → SV → KSQ → RGV.
Proposed method. A three-condition randomized comparative experiment is proposed: Traditional Literature Review, GenAI-Assisted Literature Review, and GenAI + Evidence Mapping + Source Verification. Participants work from a common standardized evidence corpus. The primary confirmatory contrast is Condition C versus Condition B, with the mean difference in KSQ as the primary estimand. RGV constitutes the key secondary epistemic outcome. Behavioral and integrity outcomes include citation accuracy, source misrepresentation, hallucinated-reference rate, contradictory-evidence integration, verification behavior, unverified AI incorporation, and time-on-task.
Contribution. EGAIRM shifts the theoretical focus from technological capability to epistemic mechanism. It reconceptualizes research gaps as evidence-dependent claims whose validity can be evaluated. Human Evidential Accountability provides the governance foundation: AI may generate candidate scholarly outputs, but human researchers retain responsibility for verification, interpretation, inferential calibration, evidential warrant, and final scientific claims.
Keywords: Generative AI; literature review; evidence mapping; source verification; knowledge synthesis quality; research gap validity; evidence traceability; research integrity; human evidential accountability.
1. GIỚI THIỆU
1.1. Tổng quan tài liệu như một quá trình kiến tạo và kiểm định tri thức
Tổng quan tài liệu không đơn thuần là thủ tục mở đầu trước nghiên cứu thực nghiệm. Nó là một hoạt động nhận thức luận trong đó nhà nghiên cứu phải xác định điều gì đã được biết, mức độ chắc chắn của tri thức hiện có, nơi bằng chứng hội tụ hoặc phân kỳ, các giới hạn phương pháp làm suy yếu suy luận và những bất định nào còn đủ ý nghĩa để biện minh cho nghiên cứu tiếp theo (Booth et al., 2016; Creswell & Creswell, 2023).
Vì vậy, chất lượng tổng quan không thể được suy ra từ số lượng nguồn hoặc độ trôi chảy của văn bản. Một bài tổng quan có thể chứa nhiều tài liệu tham khảo nhưng vẫn yếu nếu các nghiên cứu chỉ được tóm tắt tuần tự, mối quan hệ claim–evidence không rõ, bằng chứng trái chiều bị loại khỏi narrative hoặc kết luận vượt quá những gì thiết kế nghiên cứu cho phép.
Sự phát triển của GenAI làm vấn đề này trở nên cấp thiết. GenAI có thể hỗ trợ xác định từ khóa, tóm tắt tài liệu, trích xuất thông tin, phân nhóm chủ đề, so sánh nghiên cứu, hình thành narrative synthesis và đề xuất khoảng trống nghiên cứu. Tuy nhiên, những chức năng này chủ yếu mở rộng information-processing capacity.
Chúng không tự động tạo evidential warrant.
Phân biệt nền tảng của nghiên cứu vì vậy là:
Năng lực xử lý thông tin không đồng nhất với năng lực bảo chứng tri thức.
1.2. Nghịch lý hiệu quả–tính hợp lệ
GenAI tạo ra một efficiency–validity paradox.
Một mặt, AI có thể giảm thời gian và cognitive burden của những hoạt động lặp lại hoặc information-intensive. Mặt khác, chính tốc độ, quy mô và sự trôi chảy của output có thể che khuất những điểm yếu về provenance, source fidelity, contradiction handling và inferential calibration.
Một tổng quan do đó có thể:
nhanh hơn nhưng không hợp lệ hơn;
trôi chảy hơn nhưng không có căn cứ bằng chứng tốt hơn;
nhiều citation hơn nhưng không truy nguyên tốt hơn.
Walters và Wilder (2023) chỉ ra rằng citation do ChatGPT tạo có thể bao gồm tài liệu bịa đặt và các lỗi thư mục đáng kể. Những nghiên cứu gần đây về literature review do LLM tạo tiếp tục cho thấy một vấn đề rộng hơn: ngay cả khi citation dẫn đến nguồn có thật, claim gắn với nguồn đó vẫn có thể không được nguồn bảo chứng đầy đủ.
Do đó:
Real Source ≠ Valid Citation.
và:
Correct Citation ≠ Correct Interpretation.
Điều cần kiểm tra không chỉ là sự tồn tại của nguồn mà là toàn bộ evidence chain.
1.3. Từ technology-effect question đến epistemic-mechanism question
Câu hỏi:
“GenAI có cải thiện literature review không?”
không đủ mạnh về lý thuyết.
GenAI có thể cải thiện tốc độ nhưng không cải thiện synthesis. Nó có thể mở rộng coverage nhưng tăng verification burden. Nó có thể hỗ trợ comparison nhưng đồng thời tạo automation reliance.
Câu hỏi mạnh hơn là:
Trong những điều kiện bằng chứng nào, hỗ trợ AI trở thành tăng cường nhận thức luận?
EGAIRM chuyển từ:
Technology → Performance
sang:
AI Context → Evidence Structuring → Verification → Knowledge Integration → Gap Validation.
AI vì vậy là technological condition, không phải epistemic authority.
1.4. Khoảng trống nghiên cứu
Bốn khoảng trống liên kết tạo nền tảng cho nghiên cứu.
Thứ nhất, summary quality không đồng nhất với synthesis quality. Một hệ thống có thể tóm tắt từng nghiên cứu tương đối chính xác nhưng vẫn thất bại trong việc xác định quan hệ xuyên nghiên cứu, giải thích bất đồng hoặc hiệu chỉnh ranh giới suy luận.
Thứ hai, citation checking hẹp hơn source verification. Xác nhận DOI, tác giả hoặc tiêu đề chỉ kiểm tra một phần của vấn đề; nó chưa trả lời liệu nguồn có hỗ trợ claim đang được viết hay không.
Thứ ba, Evidence Mapping chưa được khai thác đầy đủ như một evidence-governance mechanism trong AI-assisted reviewing. Nghiên cứu về multiple-document literacy cho thấy việc làm hiển thị quan hệ nguồn và sử dụng epistemic scaffolds có thể hỗ trợ đánh giá và tích hợp tài liệu (Barzilai et al., 2020).
Thứ tư, research gap cần được đánh giá về validity, không chỉ novelty. Các phương pháp evidence synthesis đã có truyền thống nhận diện research needs và evidence gaps; vì vậy, đóng góp của EGAIRM không nằm ở tuyên bố rằng trước đây chưa có phương pháp nhận diện gap. Đóng góp nằm ở việc liên kết EM, SV, KSQ và RGV thành một architecture có thể kiểm định trong bối cảnh GenAI.
Câu hỏi nghiên cứu là:
- Evidence Mapping và Source Verification định hình quá trình chuyển từ GenAI-assisted reviewing sang Knowledge Synthesis Quality và Research Gap Validity như thế nào?
2. GENAI VÀ SỰ THAY ĐỔI KIẾN TRÚC TỔNG QUAN
GenAI cần được phân tích theo nhiệm vụ. Bốn chức năng có thể được phân biệt:
Retrieval assistance — hỗ trợ xác định khái niệm, từ khóa và candidate sources.
Processing assistance — tóm tắt, phân loại và trích xuất thông tin.
Synthesis assistance — so sánh và tạo candidate relationships.
Gap-generation assistance — đề xuất unresolved questions hoặc candidate research gaps.
Thành công ở một cấp không bảo chứng cấp tiếp theo:
Retrieval ≠ Verification.
Summary ≠ Synthesis.
Citation Generation ≠ Evidential Warrant.
Gap Generation ≠ Gap Validation.
Trong EGAIRM, AI-Assisted Synthesis (AIS) được định nghĩa là việc sử dụng GenAI để tổ chức, tóm tắt, so sánh, kết nối hoặc tạo diễn giải ứng viên từ corpus bằng chứng.
AIS là research condition/capability, không phải quality construct.
Hai researcher sử dụng cùng một AI system có thể khác nhau rất lớn về chất lượng cuối cùng do khác biệt trong verification behavior, contradiction handling, willingness to reject AI outputs và methodological competence.
Do đó, AI-use frequency không phải proxy đáng tin cậy cho responsible AI use.
AI-assisted reviewing cũng có thể tạo ít nhất bốn tầng failure:
Fabrication — nguồn không tồn tại.
Bibliographic distortion — nguồn tồn tại nhưng metadata sai.
Content misrepresentation — nguồn tồn tại nhưng finding bị mô tả sai.
Inferential distortion — finding tương đối đúng nhưng được dùng để bảo chứng cho kết luận vượt quá design, population, measurement hoặc context.
Kiến trúc này cho thấy source verification vẫn cần thiết ngay cả khi hallucinated citations giảm mạnh trong tương lai.
3. EVIDENCE MAPPING: CƠ CHẾ CẤU TRÚC HÓA BẰNG CHỨNG
3.1. Định nghĩa
Evidence Mapping (EM) là quá trình cấu trúc hóa có hệ thống các quan hệ:
Research Question → Claim → Source → Method → Sample/Context → Finding → Evidence Strength → Convergence/Divergence → Limitation → Unresolved Issue.
Giá trị của EM không nằm chủ yếu ở visualization.
Nó nằm ở việc làm cho evidence architecture trở nên visible, comparable, challengeable và traceable.
3.2. Từ source-centred sang claim-centred synthesis
Source-centred reviewing thường tạo cấu trúc:
Study A → Summary
Study B → Summary
Study C → Summary.
Cấu trúc này có thể đúng ở cấp từng nghiên cứu nhưng không nhất thiết tạo synthesis.
Claim-centred reviewing thay đổi đơn vị phân tích:
Claim
↓
Supporting Evidence ↔ Contradictory Evidence
↓
Methodological Differences
↓
Population/Context Differences
↓
Boundary Conditions
↓
Remaining Uncertainty.
Như vậy, đơn vị suy luận không còn là bài báo mà là claim–evidence relationship.
3.3. Cognitive externalization
Multiple-document synthesis tạo cognitive load cao vì researcher phải đồng thời theo dõi sources, methods, samples, constructs, findings, limitations và contradictions.
Evidence Mapping externalizes cấu trúc đó.
Barzilai et al. (2020) cho thấy digital epistemic scaffolds và document mapping có thể hỗ trợ source evaluation và integration. Trong EGAIRM, nguyên lý này được mở rộng sang AI-assisted review, nơi tốc độ xử lý có thể vượt quá khả năng theo dõi liên tục của con người.
3.4. Evidence traceability
Một synthesis claim nên có thể truy ngược:
Synthesis Claim → Finding → Source → Method → Sample/Context.
Đây là evidence traceability.
Traceability không bảo đảm truth. Nó bảo đảm auditability.
Nếu researcher hoặc reviewer không thể truy ngược một claim đến evidence underlying, claim đó trở nên khó kiểm tra và khó bảo vệ.
3.5. Contradiction visibility
Một nguy cơ của fluent synthesis là contradictory evidence bị làm mờ.
EM buộc researcher biểu diễn:
Convergence ↔ Divergence
và hỏi liệu bất đồng xuất phát từ population, measurement, method, context hay genuine theoretical boundary.
Theo cách này, contradiction trở thành nguồn của explanation thay vì chỉ là noise.
Tuy nhiên, một evidence map có thể được tổ chức rất tốt nhưng vẫn chứa source sai.
Do đó:
Evidence visibility không đồng nhất với evidence validity.
Đây là lý do SV phải đứng sau EM.
4. SOURCE VERIFICATION: TỪ NGUỒN CÓ THẬT ĐẾN BẰNG CHỨNG CÓ THỂ CHẤP NHẬN
4.1. Định nghĩa
Source Verification (SV) là quá trình đánh giá có hệ thống liệu một nguồn và cách sử dụng nguồn đó có đáp ứng điều kiện cần thiết để đóng vai trò bằng chứng cho một scientific claim hay không.
EGAIRM đề xuất năm tầng.
Tầng 1 — Existence Verification
Nguồn có tồn tại hay không?
Tầng 2 — Bibliographic Verification
Author, year, title, journal và identifier có chính xác hay không?
Tầng 3 — Content Verification
Nguồn có thực sự báo cáo finding được gán cho nó hay không?
Tầng 4 — Claim–Source Verification
Finding có hỗ trợ claim cụ thể trong manuscript hay không?
Tầng 5 — Inferential Verification
Claim có nằm trong boundaries của design, population, measurement, context và uncertainty hay không?
4.2. Epistemic gatekeeping
SV biến workflow:
AI Output → Literature Review
thành:
AI Candidate Output → Verification → Accept / Correct / Reject → Admissible Evidence → Synthesis.
Vì vậy, SV là một epistemic gatekeeping mechanism.
Madsen và Silva (2026) nhấn mạnh nhu cầu chuyển citation education trong kỷ nguyên GenAI khỏi trọng tâm định dạng và plagiarism prevention sang critical citation literacy và epistemic responsibility.
Điều này củng cố phân biệt:
APA correctness ≠ Evidential correctness.
4.3. Tính bền vững của SV
Nếu GenAI tương lai đạt bibliographic accuracy rất cao, SV vẫn cần thiết.
Lý do là source selection, content interpretation và inferential calibration không được giải quyết chỉ bằng việc citation tồn tại.
Do đó, SV là một model-independent scholarly requirement.
5. KNOWLEDGE SYNTHESIS QUALITY
5.1. Định nghĩa
Knowledge Synthesis Quality (KSQ) là mức độ một literature review tích hợp bằng chứng đã kiểm chứng để biểu diễn convergence, divergence, contradiction, explanatory relationships, boundary conditions và remaining uncertainty, đồng thời duy trì traceability giữa synthesis claims và underlying evidence.
Sáu dimensions là:
Coverage
Integration
Comparative Depth
Contradictory-Evidence Handling
Evidential Traceability
Inferential Calibration.
5.2. Từ summary đến knowledge synthesis
Cần phân biệt:
Summary — nguồn riêng lẻ nói gì?
Aggregation — những findings nào đã được tập hợp?
Synthesis — các findings liên hệ với nhau như thế nào?
Knowledge synthesis — evidence collectively warrants điều gì, trong conditions nào và với uncertainty nào?
Một synthesis trưởng thành có cấu trúc:
Convergence → Divergence → Explanation → Boundary → Uncertainty.
5.3. Illusion of synthesis
GenAI có thể tạo narrative coherence mà không có evidential coherence.
Một đoạn văn có thể rất trôi chảy nhưng bỏ qua contradictory findings hoặc ghép những nghiên cứu không thực sự comparable.
Đây là illusion of synthesis.
Vì vậy:
Linguistic Fluency ≠ Knowledge Synthesis Quality.
Writing quality, nếu cần, phải được đo riêng khỏi KSQ.
6. RESEARCH GAP VALIDITY
6.1. Định nghĩa
Research Gap Validity (RGV) là mức độ một tuyên bố về khoảng trống nghiên cứu được hỗ trợ bởi phạm vi tài liệu phù hợp, bằng chứng có thể truy nguyên, xem xét thích đáng bằng chứng hội tụ và trái chiều, đồng thời không vượt quá những gì corpus thực sự cho phép kết luận.
RGV gồm:
Evidence Coverage
Traceability
Contradictory-Evidence Consideration
Boundary Calibration
Gap Justification
Overall Defensibility.
6.2. RGV không phải KSQ
KSQ đánh giá state of knowledge.
RGV đánh giá claim about what remains unknown.
Do đó:
High KSQ ≠ Automatically High RGV.
Researcher có thể tổng hợp literature chính xác nhưng vẫn overclaim novelty.
Đây là ranh giới discriminant quan trọng nhất của EGAIRM.
6.3. RGV không phải novelty
Novelty hỏi một hướng nghiên cứu có mới không.
Validity hỏi tuyên bố rằng một meaningful gap tồn tại có được evidence bảo chứng hay không.
Một gap có thể mới nhưng không hợp lệ.
Một gap có thể hợp lệ nhưng không đủ quan trọng.
6.4. Từ apparent absence đến defensible gap
Không tìm thấy tài liệu không đủ để chứng minh gap.
Apparent absence có thể phản ánh search strategy yếu, database coverage hạn chế, terminology khác biệt hoặc language/date restrictions.
Do đó:
Absence of Evidence ≠ Evidence of a Research Gap.
Một defensible gap đòi hỏi:
Adequate Coverage → Verified Evidence → Cross-Study Synthesis → Remaining Uncertainty → Bounded Gap Claim.
7. EGAIRM: MÔ HÌNH LÝ THUYẾT TÍCH HỢP
7.1. Core architecture
EVIDENCE MAPPING — EM
↓ H1
SOURCE VERIFICATION — SV
↓ H2
KNOWLEDGE SYNTHESIS QUALITY — KSQ
↓ H3
RESEARCH GAP VALIDITY — RGV
Các đường trực tiếp:
EM → KSQ — H4
SV → RGV — H5.
Các đường gián tiếp:
EM → SV → KSQ — H6
EM → SV → KSQ → RGV — H7.
7.2. Condition–Mechanism–Outcome architecture
EGAIRM tách ba tầng.
Experimental Condition
Traditional vs. GenAI vs. GenAI + EM + SV.
Epistemic Mechanism
EM → SV.
Epistemic Outcomes
KSQ → RGV.
Điều này tránh lỗi lý thuyết:
AI Exposure = Mechanism.
AI exposure chỉ tạo technological condition. Evidence practices mới là candidate mechanism.
7.3. Human Evidential Accountability
Toàn bộ model vận hành dưới Human Evidential Accountability (HEA).
HEA là trách nhiệm và thẩm quyền liên tục của researcher trong việc:
inspect;
verify;
challenge;
correct;
reject;
interpret;
justify
các evidence-dependent outputs trong human–AI workflow.
Human presence không đủ.
Meaningful accountability đòi hỏi:
Verification Authority
Rejection Authority
Interpretive Authority
Inferential Authority
Final Accountability.
8. KIẾN TRÚC LẬP LUẬN PHỐI HỢP
| Luận điểm | Luận cứ | Cơ sở học thuật | Construct | Hypothesis/Test | Đóng góp |
| AI capability không bảo đảm epistemic quality | GenAI có thể tạo citation/source errors | Walters & Wilder; Linardon et al. | AIS/SV | B vs. C | Chuyển từ capability sang evidence discipline |
| Evidence cần được cấu trúc | Multi-source reasoning đòi hỏi externalization | Barzilai et al. | EM | H1, H4 | EM như evidence-structuring mechanism |
| Source existence chưa đủ | Real source có thể không warrant claim | Citation-literacy literature | SV | H1, H2, H5 | SV như epistemic gatekeeper |
| Verified evidence chưa phải synthesis | Synthesis cần integration và contradiction handling | Review-methodology literature | KSQ | H2–H4 | KSQ khác source accuracy |
| Good synthesis chưa tự tạo valid gap | Gap là inference về remaining uncertainty | Evidence-synthesis literature | RGV | H3, H5, H7 | Operationalization của RGV |
| AI không thay thế accountability | Candidate output cần human justification | AI-governance literature | HEA | Process measures | Governance foundation |
Kiến trúc tổng thể:
AI Capability → Evidential Risk → EM → SV → KSQ → RGV → Human Evidential Accountability.
9. GIẢ THUYẾT NGHIÊN CỨU
H1. Evidence Mapping Quality có liên hệ tích cực với Source Verification Quality.
H2. Source Verification Quality có liên hệ tích cực với Knowledge Synthesis Quality.
H3. Knowledge Synthesis Quality có liên hệ tích cực với Research Gap Validity.
H4. Evidence Mapping Quality có liên hệ tích cực với Knowledge Synthesis Quality.
H5. Source Verification Quality có liên hệ tích cực với Research Gap Validity.
H6. Source Verification Quality tạo thành đường dẫn gián tiếp giữa Evidence Mapping Quality và Knowledge Synthesis Quality.
H7. Evidence Mapping Quality có liên hệ gián tiếp với Research Gap Validity thông qua Source Verification Quality và Knowledge Synthesis Quality.
H6–H7 chỉ nên được diễn giải là indirect associations consistent with the proposed mechanism nếu design không cung cấp temporal ordering và causal identification đầy đủ.
Ở experimental level:
H8. GenAI + EM + SV tạo KSQ cao hơn GenAI-only.
H9. GenAI + EM + SV tạo RGV cao hơn GenAI-only.
H10. GenAI + EM + SV tạo ít citation errors, source misrepresentations và hallucinated references hơn GenAI-only.
Traditional vs. GenAI-only nên được xem là exploratory nếu directional hypotheses chưa được preregister.
10. PHƯƠNG PHÁP ĐỀ XUẤT
10.1. Thiết kế
Một randomized three-condition experiment được đề xuất:
Condition A — Traditional Literature Review
Không sử dụng GenAI.
Condition B — GenAI-Assisted Literature Review
Được sử dụng GenAI nhưng không có structured evidence-verification protocol.
Condition C — GenAI + EM + SV
Sử dụng GenAI cùng Evidence Mapping và Source Verification protocol.
Primary confirmatory comparison:
C − B.
Đây là contrast có giá trị lý thuyết cao nhất vì nó kiểm tra liệu structured evidence discipline tạo incremental epistemic value khi AI đã hiện diện.
10.2. Participants và sample-size determination
Target population gồm sinh viên năm cuối hoặc sau đại học đã hoàn thành formal research-methods training.
Baseline variables nên gồm:
research-methods competence;
literature-review experience;
GenAI familiarity;
academic background.
Không khóa trước một N cụ thể nếu chưa hoàn thành power analysis.
Sample size phải được xác định bằng a priori power/design analysis, hoặc simulation-based analysis khi mô hình và indirect effects khiến closed-form calculation không phù hợp.
Power assumptions phải được công bố: primary estimand, expected effect, reliability, alpha, power, allocation ratio và attrition.
10.3. Randomization
Participants được randomize sau baseline assessment.
Final protocol phải prespecify:
allocation ratio;
randomization algorithm;
stratification nếu sử dụng;
handling of deviations.
Nếu prior GenAI experience được xem là strong prognostic factor, stratification có thể được xem xét nhưng phải xác định trước data collection.
10.4. Standardized evidence corpus
Mọi participants sử dụng cùng evidence package.
Điều này kiểm soát retrieval ability.
Corpus phải chứa:
convergent findings;
contradictory findings;
methodological heterogeneity;
population/context differences;
evidence-strength variation;
limitations;
unresolved issues;
apparent but weakly supported gaps;
ít nhất một defensible gap.
Không nên làm gap quá rõ vì có thể gây ceiling effect.
10.5. Task
Workflow chung:
Review → Organize → Compare → Synthesize → Identify Gap → Justify Gap.
Condition C:
Map → Verify → Compare → Synthesize → Challenge → Identify Gap → Justify Gap.
10.6. Construct Definition–Operationalization Matrix
| Construct | Definition | Theoretical domain | Dimensions | Observable evidence | Discriminant boundary | Expected role |
| EM | Cấu trúc hóa quan hệ claim–evidence | Multiple-document/evidence structuring | Coverage, linking, comparison, contradiction, traceability | Evidence map | EM ≠ note-taking | Mechanism |
| SV | Đánh giá tính chấp nhận được của source use | Epistemic/source evaluation | Existence, metadata, content, claim fit, inference | Logs + artifacts | SV ≠ formatting | Mechanism |
| KSQ | Tích hợp verified evidence thành state of knowledge | Knowledge synthesis | Coverage, integration, depth, contradictions, traceability, calibration | Final synthesis | KSQ ≠ fluency | Primary outcome |
| RGV | Validity của claim về remaining unknown | Scientific inference/gap justification | Coverage, traceability, contradiction, boundary, justification, defensibility | Gap claim + rationale | RGV ≠ novelty | Key secondary outcome |
10.7. Measurement development
Construct development phải đi trước definitive hypothesis testing:
Domain Specification
→ Expert Content Validation
→ Cognitive/Pilot Testing
→ Rater Calibration
→ Measurement Evaluation
→ Confirmatory Testing.
Expert panel đánh giá relevance, clarity, representativeness và construct contamination.
Pilot participants giúp xác định ambiguity, floor/ceiling effects và rubric interpretation.
Anchor artifacts được sử dụng để calibrate raters.
Một falsification test đặc biệt quan trọng là:
KSQ và RGV có empirically separable hay không?
Nếu không, claim rằng RGV là một distinct downstream construct phải được sửa đổi.
10.8. Behavioral outcomes
Các outcomes gồm:
Citation Accuracy
Source Misrepresentation Rate
Hallucinated Reference Rate
Contradictory-Evidence Integration
Verification Action Count
Unverified AI Incorporation Rate
Time-on-Task.
Nhờ đó có thể kiểm tra hai patterns:
Efficiency ↑ / Epistemic Quality ↔ hoặc ↓
so với:
Efficiency ↑ / Epistemic Quality ↑.
10.9. AI interaction logs
Trong B và C:
Prompt → AI Output → Candidate Claim/Source → Verification Action → Correction/Rejection → Final Incorporation.
Behavioral traces này mạnh hơn self-report frequency trong việc đánh giá responsible AI practice.
10.10. Reproducibility
Empirical report phải ghi rõ, trong phạm vi có thể xác định:
AI provider;
model/version;
study window;
interface;
system/researcher instructions;
participant instructions;
permitted/prohibited functions;
controllable parameters;
logging procedures;
substantial model changes during data collection.
10.11. Independent rating
Ít nhất hai raters độc lập đánh giá artifacts.
Workflow:
Rubric Development → Anchor Artifacts → Training → Pilot Rating → Calibration → Main Rating.
Raters nên được blinded to experimental condition khi khả thi.
10.12. Treatment fidelity
Condition C phải được kiểm tra về:
evidence-map completeness;
protocol adherence;
verification actions;
verification accuracy;
claim–source checks;
documented corrections/rejections.
Null C−B effect trong điều kiện fidelity thấp không thể được xem ngay là falsification của EGAIRM.
10.13. Primary estimand
Primary estimand:
ΔKSQ(C−B) = Mean KSQ_C − Mean KSQ_B.
RGV là key secondary epistemic outcome.
Các integrity/process outcomes là secondary outcomes.
Hierarchy này phải được preregister để hạn chế outcome switching và multiplicity ambiguity.
11. CHIẾN LƯỢC PHÂN TÍCH
Preliminary analysis kiểm tra missingness, score distributions, baseline balance, protocol deviations, fidelity và inter-rater agreement.
Measurement evaluation phải đi trước structural interpretation.
Empirical architecture cần hỗ trợ:
EM ≠ SV ≠ KSQ ≠ RGV.
Primary analysis kiểm định C vs. B trên KSQ, báo cáo:
estimated mean difference;
95% confidence interval;
standardized effect size;
exact p value.
Key secondary analysis kiểm định C vs. B trên RGV.
Mechanism analysis đánh giá:
EM → SV → KSQ → RGV.
Indirect effects cần confidence intervals.
Tuy nhiên:
Statistical Mediation ≠ Demonstrated Causal Mechanism.
Nếu temporal ordering và causal assumptions không được đáp ứng, conclusions phải giới hạn ở indirect associations.
Competing models cần được kiểm tra, ví dụ:
EM → KSQ → RGV
và:
SV → EM → KSQ → RGV.
Robustness analyses nên xem xét prior research competence, GenAI experience, treatment adherence, rater effects, alternative scoring specifications và missing-data assumptions.
12. KIẾN TRÚC KẾT QUẢ VÀ FALSIFIABILITY
Bản thảo này là theoretical-development/research-design manuscript.
Không có empirical dataset.
Vì vậy không được tạo giả:
participant characteristics;
effect sizes;
p values;
confidence intervals;
fit indices;
hypothesis-support statements.
Future empirical manuscript có thể sử dụng:
Table 1. Participant Characteristics and Baseline Equivalence
Table 2. Reliability, Measurement Quality, and Inter-Rater Agreement
Table 3. Descriptive Statistics by Experimental Condition
Table 4. Prespecified Experimental Contrasts
Table 5. Direct and Indirect Associations in EGAIRM
Figures:
Figure 1. Evidence-Grounded AI Literature Review Model
Figure 2. Condition–Mechanism–Outcome Architecture
Figure 3. Evidence Mapping and Source Verification Workflow
EGAIRM có khả năng bị bác bỏ hoặc sửa đổi nếu:
EM và SV không phân biệt empirically;
KSQ và RGV collapse thành một construct;
C tăng verification nhưng không tăng KSQ;
SV không có incremental explanatory value;
competing models giải thích data tốt hơn;
RGV không tương ứng với expert judgment về defensible gap claims.
13. THẢO LUẬN
13.1. Từ AI capability đến evidence discipline
Đóng góp trung tâm của EGAIRM là chuyển explanatory level.
Không hỏi đơn giản:
AI có tốt cho literature review không?
Mà hỏi:
Cơ chế nào biến AI-assisted processing thành defensible knowledge?
EGAIRM trả lời bằng evidence discipline.
AI tạo capacity.
EM tạo structure.
SV tạo admissibility.
KSQ tạo integrated state of knowledge.
RGV kiểm tra inference về remaining unknown.
13.2. Productive epistemic friction
AI thường được đánh giá bởi lượng friction mà nó loại bỏ.
Nhưng scientific reasoning cần một mức friction có giá trị.
Researcher phải dừng lại để hỏi:
Nguồn có thật?
Finding có được mô tả đúng?
Claim có được nguồn hỗ trợ?
Contradictory evidence có bị bỏ qua?
Inference có vượt boundary?
EM và SV tạo những checkpoints này.
Bài viết gọi đó là productive epistemic friction: effort làm giảm procedural speed nhưng có thể tăng auditability và defensibility.
Vì vậy, Condition C có thể mất nhiều thời gian hơn B nhưng vẫn là outcome tích cực nếu KSQ và RGV tăng đủ lớn.
13.3. Verification beyond hallucination
SV không chỉ là anti-hallucination mechanism.
Ngay cả với một AI không bịa citation, researcher vẫn cần đánh giá source relevance, content fidelity, claim fit và inference.
Vì vậy SV vẫn có giá trị trong future high-accuracy AI environments.
13.4. Verified evidence chưa phải synthesized knowledge
Một researcher có thể xác minh chính xác mọi citation nhưng vẫn viết literature review yếu.
Verification không tự tạo:
comparison;
explanation;
contradiction handling;
boundary identification.
Vì vậy:
SV is necessary but insufficient for KSQ.
13.5. Good synthesis chưa đủ tạo valid gap
KSQ tốt chỉ cho biết state of knowledge được biểu diễn tốt.
RGV hỏi liệu state đó bảo chứng cho một claim cụ thể về unknown hay không.
Đây là lý do:
KSQ → RGV
thay vì coi hai constructs là đồng nhất.
13.6. Human Evidential Accountability
AI có thể tạo candidate summary.
AI có thể tạo candidate synthesis.
AI có thể tạo candidate gap.
Nhưng candidate output chỉ trở thành scientific claim khi evidence chain được researcher kiểm tra và biện minh.
HEA vì vậy không phải một moderator mới. Nó là governance foundation của toàn bộ model.
13.7. Competing explanations
Nếu C vượt B, ít nhất bốn alternative explanations phải được xem xét:
mapping template làm tăng attention;
protocol làm tăng time-on-task;
externalization làm giảm cognitive load;
demand characteristics làm participants thận trọng hơn.
Vì vậy, support cho EGAIRM phải đến từ sự hội tụ của experimental contrasts, process measures, fidelity evidence, measurement structure và competing-model tests.
14. ĐÓNG GÓP LÝ THUYẾT
Đóng góp 1 — Construct differentiation.
EGAIRM phân biệt:
AIS ≠ EM ≠ SV ≠ KSQ ≠ RGV.
Đóng góp 2 — Mechanism specification.
Mô hình thay:
GenAI → Better Literature Review
bằng:
AI Context → EM → SV → KSQ → RGV.
Đóng góp 3 — Verification reconceptualization.
Câu hỏi chuyển từ:
“Nguồn có tồn tại?”
sang:
“Nguồn này có bảo chứng cho claim này?”
Đóng góp 4 — Research-gap reconceptualization.
Research gap được xem là bounded epistemic claim about unresolved uncertainty.
Đóng góp 5 — Human Evidential Accountability.
AI có thể hỗ trợ processing; human researcher vẫn chịu trách nhiệm đối với evidential warrant và final scientific claim.
Tuyên bố lý thuyết trung tâm của EGAIRM là:
EGAIRM không giải thích liệu GenAI có thể tổng hợp literature hay không; mô hình giải thích cách cấu trúc hóa và kiểm chứng bằng chứng quyết định liệu tổng hợp hỗ trợ bởi AI có đủ cơ sở để bảo vệ một tuyên bố về những gì khoa học chưa biết hay không.
15. HÀM Ý GIÁO DỤC VÀ THỰC TIỄN
Research-methods education cần chuyển từ “cách sử dụng GenAI” sang evidence governance competence.
Workflow được đề xuất:
Search → Retrieve → Map → Verify → Compare → Synthesize → Challenge → Identify Gap → Justify Gap.
Rubrics cho literature review nên giảm phụ thuộc vào:
word count;
reference count;
linguistic polish.
Và tăng trọng số cho:
Evidence Integration;
Claim–Source Correspondence;
Contradictory-Evidence Handling;
Traceability;
Inferential Calibration;
Gap Justification.
Responsible AI use cũng nên được đánh giá qua behavior:
verify → correct → reject → justify
thay vì chỉ hỏi “bạn sử dụng AI bao nhiêu lần?”.
16. LIÊM CHÍNH NGHIÊN CỨU VÀ QUẢN TRỊ AI
EGAIRM xác định integrity-risk chain:
Fabrication → Misrepresentation → Selective Synthesis → False Gap.
Fabrication phá vỡ source existence.
Misrepresentation phá vỡ source–claim fidelity.
Selective synthesis làm méo trạng thái tri thức.
False gap làm sai justification cho nghiên cứu tiếp theo.
Vì vậy, research integrity trong AI-assisted reviewing cần chuỗi:
Source Fidelity → Evidence Traceability → Interpretive Transparency → Inferential Restraint → Human Accountability.
Nguyên tắc quản trị:
AI-generated synthesis must remain auditable back to human-verifiable evidence.
17. HẠN CHẾ VÀ NGHIÊN CỨU TƯƠNG LAI
Thứ nhất, EM, SV, KSQ và RGV cần empirical measurement validation.
Thứ hai, standardized corpus tăng internal validity nhưng làm giảm ecological realism.
Thứ ba, model drift và interface changes tạo thách thức cho reproducibility.
Thứ tư, student samples không đại diện đầy đủ cho experienced researchers.
Thứ năm, HEA có thể có giá trị ngoài literature review nhưng việc mở rộng sang data analysis, interpretation, peer review hoặc publication decision-making cần được kiểm định riêng.
Thứ sáu, không phải mọi claim cần cùng verification intensity. Future research nên phát triển risk-adaptive verification protocols, trong đó mức kiểm chứng tương ứng với epistemic consequence của claim.
18. KẾT LUẬN
GenAI đang thay đổi tốc độ và quy mô tổng quan tài liệu học thuật. Nó không thay đổi tiêu chuẩn bằng chứng cần thiết để một tuyên bố trở thành scientific knowledge claim.
EGAIRM mô tả quá trình:
Evidence Mapping → Source Verification → Knowledge Synthesis Quality → Research Gap Validity.
Evidence Mapping cấu trúc bằng chứng.
Source Verification xác lập tính chấp nhận được của bằng chứng.
Knowledge Synthesis Quality xây dựng trạng thái tri thức có thể bảo vệ.
Research Gap Validity xác định những gì có thể được tuyên bố hợp pháp là chưa biết.
Human Evidential Accountability duy trì trách nhiệm đối với toàn bộ chuỗi.
Do đó, câu hỏi trung tâm không phải:
“GenAI có thể viết literature review không?”
mà là:
“Trong những điều kiện bằng chứng nào, hỗ trợ AI trở thành tăng cường nhận thức luận?”
Câu trả lời lý thuyết của EGAIRM là:
AI expands processing capacity.
Evidence Mapping structures evidence.
Source Verification establishes evidential admissibility.
Knowledge Synthesis constructs a defensible state of knowledge.
Research Gap Validity calibrates what can legitimately be claimed as unknown.
Human Evidential Accountability retains responsibility for the scientific claim.
TUYÊN BỐ ĐÓNG GÓP CỦA TÁC GIẢ (CRediT)
Nguyễn Văn Hùng: Khái niệm hóa; Phương pháp luận; Điều tra; Viết – Bản thảo gốc; Viết – Xem xét & Chỉnh sửa.
TÀI LIỆU THAM KHẢO CỐT LÕI
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association.
- Barzilai, S., Mor-Hagani, S., Zohar, A. R., Shlomi-Elooz, T., & Ben-Yishai, R. (2020). Making sources visible: Promoting multiple document literacy with digital epistemic scaffolds. Computers & Education, 157, 103980.
- Booth, A., Sutton, A., & Papaioannou, D. (2016). Systematic approaches to a successful literature review (2nd ed.). SAGE.
- Creswell, J. W., & Creswell, J. D. (2023). Research design: Qualitative, quantitative, and mixed methods approaches (6th ed.). SAGE.
- González Canché, M. S. (2026). Data science, interactive visualizations, and generative AI tools for the analysis of qualitative, mixed-methods, and multimodal evidence. Morgan Kaufmann.
- Linardon, J., Messer, M., Anderson, C., Soliman, O. M., Liu, C., Firth, J., & Torous, J. (2026). Fluency without fidelity: Errors in citation-attributed claims in large language model-generated literature reviews in mental health. Journal of Technology in Behavioral Science.
- Madsen, D. Ø., & Silva, E. S. (2026). Teaching citation in the age of generative AI: Rethinking research literacy, academic integrity, and epistemic responsibility. The Journal of Academic Librarianship, 52(4), Article 103267.
- Miao, F., & Holmes, W. (2023). Guidance for generative AI in education and research. UNESCO.
- Munn, Z., Peters, M. D. J., Stern, C., Tufanaru, C., McArthur, A., & Aromataris, E. (2018). Systematic review or scoping review? Guidance for authors when choosing between a systematic or scoping review approach. BMC Medical Research Methodology, 18, 143.
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71.
- Sandoval, W. A., & Millwood, K. A. (2005). The quality of students’ use of evidence in written scientific explanations. Cognition and Instruction, 23(1), 23–55.
- Singh, U. G. (Ed.). (2026). GenAI in higher education: Ethical frontiers, challenge and sustainable pathways. Elsevier.
- Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045.
- Williamson, K., & Johanson, G. (Eds.). (2018). Research methods: Information, systems, and contexts (2nd ed.). Chandos Publishing.
