
From AI-Assisted Statistical Analysis to Defensible Statistical Judgment: The Roles of Automation Dependence, Verification Behavior, and AI Literacy in Generative AI Environments
NGUYỄN VĂN HÙNG
TÓM TẮT
Bối cảnh
Trí tuệ nhân tạo tạo sinh (Generative Artificial Intelligence – GenAI) đang thay đổi nhanh chóng cách sinh viên đại học thực hiện phân tích thống kê. Các hệ thống AI hiện có thể đề xuất phương pháp phân tích, tạo mã lệnh, hỗ trợ kiểm tra giả định, tính kích thước hiệu ứng và khoảng tin cậy, trực quan hóa dữ liệu, hỗ trợ chẩn đoán mô hình và tạo diễn giải kết quả theo phong cách học thuật. Sự mở rộng năng lực kỹ thuật này có thể giảm đáng kể rào cản thao tác và lập trình. Tuy nhiên, khả năng tiếp cận tính toán thống kê dễ dàng hơn không đồng nghĩa với sự cải thiện tương ứng về suy luận và phán đoán thống kê.
Vấn đề nghiên cứu
Khoảng trống trung tâm nằm ở việc phần lớn tranh luận về AI trong giáo dục thống kê tập trung vào khả năng hỗ trợ, độ chính xác, hiệu suất hoặc thái độ đối với AI, trong khi chưa giải thích đầy đủ cơ chế khiến cùng một năng lực AI có thể tăng cường hoặc thay thế phán đoán của người học. Một sinh viên có thể nhận được phép kiểm định đúng mà không hiểu vì sao nó phù hợp; có thể báo cáo đúng giá trị p nhưng diễn giải sai; hoặc chấp nhận một khuyến nghị AI có vẻ thuyết phục nhưng không tương thích với thiết kế nghiên cứu.
Mục tiêu và khung lý thuyết
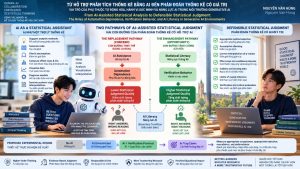
Nghiên cứu phát triển Mô hình Hai Con đường của Phán đoán Thống kê có Hỗ trợ AI, tích hợp sáu cấu trúc: AI Assistance, Statistical Literacy, Automation Dependence, Verification Behavior, AI Literacy và Statistical Judgment Quality. Mô hình đề xuất con đường thay thế: AI Assistance → Automation Dependence → giảm Statistical Judgment Quality, và con đường tăng cường: Statistical Literacy → Verification Behavior → tăng Statistical Judgment Quality. Giao thức Xác minh được đề xuất như một can thiệp làm thay đổi kiến trúc hành vi của việc sử dụng AI, trong khi AI Literacy đóng vai trò điều kiện biên.
Phương pháp đề xuất
Thiết kế thực nghiệm gồm ba điều kiện: Không AI, AI Không Giới hạn, và AI + Giao thức Xác minh. Người tham gia thực hiện các nhiệm vụ phán đoán thống kê về lựa chọn phương pháp, giả định, giá trị p, kích thước hiệu ứng, khoảng tin cậy, ngoại lệ, dữ liệu thiếu và giới hạn suy luận nhân quả. Một mô thức hiệu chỉnh hành vi bằng AI Trap Cases được phát triển, trong đó người học tiếp xúc với khuyến nghị AI đúng, đúng một phần và sai nhưng có vẻ hợp lý nhằm đo khả năng chấp nhận thích hợp, từ chối thích hợp, overreliance và underreliance.
Đóng góp
Nghiên cứu đóng góp một giải thích cơ chế về hai kết quả cạnh tranh của AI; phân biệt chất lượng phán đoán với độ chính xác tính toán; vận hành hóa giám sát con người thông qua Verification Behavior; phân biệt Automation Dependence với tần suất sử dụng AI; định vị AI Literacy như điều kiện biên; và phát triển AI Trap Cases thành một behavioral calibration paradigm. Luận đề trung tâm là giá trị giáo dục của GenAI không nên được đánh giá chủ yếu bằng tốc độ tạo kết quả mà bằng khả năng người học độc lập xác minh, diễn giải, giới hạn, phản biện và bảo vệ suy luận thống kê.
Từ khóa: trí tuệ nhân tạo tạo sinh; năng lực thống kê; phán đoán thống kê; hành vi xác minh; phụ thuộc tự động hóa; năng lực AI; phụ thuộc thích hợp; hiệu chỉnh hành vi; cộng tác Người–AI.
ABSTRACT
Background
Generative Artificial Intelligence (GenAI) is rapidly transforming how university students conduct statistical analysis. Contemporary AI systems can recommend analytical methods, generate executable code, assist with assumption checking, calculate effect sizes and confidence intervals, visualize data, support model diagnostics, and produce academically styled interpretations of statistical results. This expansion of technical capability can substantially reduce procedural and programming barriers. However, easier access to statistical computation does not necessarily translate into corresponding improvements in statistical reasoning and judgment.
Research Problem
A central gap in the emerging literature is that much of the discussion surrounding AI in statistics education has focused on technical assistance, accuracy, efficiency, or attitudes toward AI, while providing limited explanation of the mechanisms through which the same AI capability may either augment or displace learners’ statistical judgment. A student may obtain the correct statistical test without understanding why it is appropriate, report an accurate p-value while interpreting it incorrectly, or accept a plausible AI recommendation that is methodologically inconsistent with the research design.
Aim and Theoretical Framework
This study develops a Dual-Path Model of AI-Assisted Statistical Judgment integrating six constructs: AI Assistance, Statistical Literacy, Automation Dependence, Verification Behavior, AI Literacy, and Statistical Judgment Quality. The model proposes a displacement pathway, in which AI Assistance → Automation Dependence → lower Statistical Judgment Quality, and an augmentation pathway, in which Statistical Literacy → Verification Behavior → higher Statistical Judgment Quality. A structured Verification Protocol is proposed as an intervention designed to alter the behavioral architecture of AI use, while AI Literacy is conceptualized as a boundary condition shaping how learners respond to AI assistance.
Proposed Method
A three-condition experimental design is proposed: No AI, AI Unrestricted, and AI + Verification Protocol. Participants complete performance-based statistical judgment tasks involving method selection, assumption evaluation, interpretation of p-values, effect sizes, confidence intervals, outliers, missing data, and limits to causal inference. An AI Trap Behavioral Calibration Paradigm is introduced in which learners are exposed to AI recommendations that are correct, partially correct, or plausible but methodologically incorrect. The paradigm is designed to measure appropriate acceptance, appropriate resistance, overreliance, and underreliance.
Contribution
The study contributes a mechanism-based explanation of two competing consequences of AI assistance; distinguishes judgment quality from computational accuracy; operationalizes meaningful human oversight through Verification Behavior; separates Automation Dependence from frequency of AI use; positions AI Literacy as a boundary condition; and develops AI Trap Cases into a behavioral calibration paradigm for evaluating human–AI reliance. The central argument is that the educational value of GenAI should not be assessed primarily by how quickly it produces statistical outputs, but by whether learners remain able to independently verify, interpret, qualify, challenge, and defend AI-assisted statistical inferences.
Keywords: generative artificial intelligence; statistical literacy; statistical judgment; verification behavior; automation dependence; AI literacy; appropriate reliance; behavioral calibration; human–AI collaboration.
- GIỚI THIỆU
Trí tuệ nhân tạo tạo sinh đang tái cấu trúc môi trường thực hành thống kê trong giáo dục đại học. Những nhiệm vụ từng đòi hỏi người học phải có kiến thức tương đối vững về phần mềm, cú pháp lập trình và quy trình phân tích nay có thể được hỗ trợ trong một giao diện hội thoại. Sinh viên có thể mô tả câu hỏi nghiên cứu, cung cấp cấu trúc dữ liệu, yêu cầu AI đề xuất phương pháp, tạo mã R hoặc Python, giải thích giả định, diễn giải kết quả và thậm chí soạn một đoạn báo cáo thống kê theo phong cách bài báo khoa học.
Sự thay đổi này tạo ra một cơ hội giáo dục đáng kể. GenAI có thể làm giảm rào cản kỹ thuật, hỗ trợ người học tiếp cận những quy trình phân tích trước đây vượt quá năng lực lập trình của họ và cung cấp phản hồi gần như tức thời. Trong cách nhìn lạc quan, AI giải phóng nguồn lực nhận thức khỏi thao tác kỹ thuật để người học tập trung vào những vấn đề có giá trị cao hơn như câu hỏi nghiên cứu, thiết kế, diễn giải và ý nghĩa của bằng chứng.
Tuy nhiên, chính khả năng tạo ra câu trả lời nhanh chóng, trôi chảy và có vẻ chuyên nghiệp lại tạo ra một nghịch lý. Khi chi phí để nhận được một đầu ra thống kê thuyết phục giảm mạnh, người học có thể ít phải tự hình thành, kiểm tra và bảo vệ phán đoán của mình hơn. Công nghệ vì vậy có thể giảm tải thao tác nhưng đồng thời làm giảm nhu cầu thực hành một số hoạt động nhận thức vốn tạo nên năng lực thống kê.
Schwarz (2025) cho thấy GenAI có thể hỗ trợ phân tích thống kê, đặc biệt thông qua tạo mã, nhưng không phải lúc nào cũng tuân thủ đầy đủ các thủ tục phân tích tiêu chuẩn. Điều này cho thấy năng lực kỹ thuật của AI không loại bỏ nhu cầu về kiến thức thống kê và giám sát con người. Vấn đề không còn đơn giản là AI có tạo được một phân tích hay không, mà là ai có khả năng xác định phân tích đó có đáng tin và có thể bảo vệ về mặt phương pháp hay không.
Sự phân biệt này đặc biệt quan trọng bởi một đầu ra đúng về mặt tính toán không nhất thiết tạo ra một suy luận đúng về mặt khoa học. Một mô hình có thể tính đúng giá trị p nhưng diễn giải sai ý nghĩa của nó. Một AI có thể chọn được phương pháp hợp lý nhưng bỏ qua điều kiện áp dụng. Một đoạn văn có thể sử dụng thuật ngữ thống kê chính xác nhưng đưa ra tuyên bố nhân quả từ dữ liệu quan sát.
Vì vậy:
Tính toán Thống kê ≠ Phán đoán Thống kê.
Tính toán đề cập đến việc thực hiện phép toán, ước lượng mô hình và tạo đầu ra. Phán đoán đề cập đến việc quyết định phương pháp nào phù hợp, giả định nào cần được xem xét, bằng chứng mạnh đến mức nào, kết luận có thể đi xa đến đâu và giới hạn nào phải được công khai.
GenAI có khả năng tự động hóa ngày càng nhiều hoạt động thuộc nhóm thứ nhất. Điều đó không có nghĩa nhóm thứ hai trở nên không cần thiết.
Ngược lại, khi AI có thể tạo ra các đầu ra ngày càng thuyết phục, năng lực phán đoán có thể trở nên quan trọng hơn.
1.1. Khoảng trống nghiên cứu
Ba dòng nghiên cứu hiện có cung cấp nền tảng quan trọng nhưng vẫn để lại một khoảng trống lý thuyết.
Dòng thứ nhất tập trung vào khả năng của GenAI trong hỗ trợ học tập, lập trình và phân tích dữ liệu. Các nghiên cứu này giúp xác định AI có thể làm gì nhưng chưa nhất thiết giải thích người học còn thực hiện phần nào của quá trình phán đoán.
Dòng thứ hai nghiên cứu trust, reliance và overreliance trong hệ thống Người–AI. Bằng chứng cho thấy con người có thể làm theo lời khuyên AI ngay cả khi tồn tại thông tin phản bác. Tuy nhiên, việc chuyển các kết quả này vào bối cảnh phán đoán thống kê đòi hỏi một cơ chế chuyên biệt hơn, bởi việc xác định một khuyến nghị thống kê đúng hay sai thường phụ thuộc vào hiểu biết về thiết kế, giả định, đo lường và suy luận.
Dòng thứ ba nghiên cứu AI literacy. Các khung hiện đại nhấn mạnh hiểu biết, ứng dụng, đánh giá phê phán và đạo đức. Tuy nhiên, biết AI có giới hạn không đồng nghĩa với biết một phân tích thống kê sai ở đâu.
Do đó, điều đã biết là AI có thể hỗ trợ phân tích; người dùng có thể overrely; và AI literacy có vai trò quan trọng.
Điều chưa được giải thích đầy đủ là:
Cơ chế nào khiến cùng một quyền truy cập AI dẫn đến tăng cường phán đoán ở người học này nhưng dẫn đến thay thế phán đoán ở người học khác?
Khoảng trống thứ hai là đo lường. Nếu AI luôn đưa ra đáp án đúng trong nghiên cứu thực nghiệm, người dùng chấp nhận mọi khuyến nghị có thể đạt thành tích rất cao dù không có khả năng phân biệt chất lượng lời khuyên. Do đó, độ chính xác đầu ra không đủ để đo chất lượng cộng tác Người–AI.
Khoảng trống thứ ba liên quan đến human oversight. Trong nhiều thảo luận, giám sát con người được xem như một nguyên tắc chuẩn tắc, nhưng ít được vận hành hóa thành một chuỗi hành vi có thể quan sát và kiểm định.
1.2. Mục tiêu nghiên cứu
Nghiên cứu này giải quyết ba khoảng trống trên bằng cách phát triển một mô hình cơ chế, một cấu trúc đo lường và một giao thức thực nghiệm.
Câu hỏi trung tâm là:
Trong điều kiện nào hỗ trợ GenAI tăng cường phán đoán thống kê của sinh viên, và trong điều kiện nào nó thay thế phán đoán đó?
Mô hình đề xuất hai con đường:
Con đường Thay thế
AI Assistance
→ Automation Dependence
→ ↓ Statistical Judgment Quality
Con đường Tăng cường
Statistical Literacy
→ Verification Behavior
→ ↑ Statistical Judgment Quality
Đồng thời:
AI + Verification Protocol
→ Verification Behavior
→ ↑ Statistical Judgment Quality.
AI Literacy được định vị như một boundary condition, ảnh hưởng đến xác suất AI Assistance chuyển hóa thành phụ thuộc hay xác minh.
1.3. Đóng góp nghiên cứu
Nghiên cứu dự kiến đóng góp trên sáu phương diện.
Thứ nhất, phát triển Dual-Path Model giải thích vì sao AI có thể đồng thời tạo lợi ích và rủi ro.
Thứ hai, xây dựng Statistical Judgment Quality (SJQ) như một kết quả khác với computational accuracy.
Thứ ba, khái niệm hóa Verification Behavior (VB) như cơ chế hành vi của meaningful human oversight.
Thứ tư, phân biệt Automation Dependence (AD) với AI-use frequency.
Thứ năm, định vị AI Literacy (AIL) như điều kiện biên thay vì thay thế Statistical Literacy.
Thứ sáu, phát triển AI Trap Behavioral Calibration Paradigm để đo appropriate reliance thông qua hành vi.
- NỀN TẢNG LÝ THUYẾT
2.1. Từ năng lực tính toán đến phán đoán thống kê
Phân tích thống kê chứa các nhiệm vụ có độ sâu nhận thức khác nhau. Tính trung bình, ước lượng hồi quy, chạy ANOVA, tính khoảng tin cậy hoặc tạo biểu đồ là những hoạt động có thể được tự động hóa ở mức độ đáng kể. Tuy nhiên, việc quyết định liệu một mô hình có phù hợp với câu hỏi nghiên cứu hay không là một nhiệm vụ khác về bản chất.
Phán đoán thống kê đòi hỏi người phân tích xem xét đồng thời câu hỏi nghiên cứu, thiết kế, cấu trúc dữ liệu, đo lường, giả định, độ bất định và giới hạn suy luận.
Một người có thể tạo được kết quả đúng nhưng vẫn đưa ra kết luận sai.
Vì vậy:
Đầu ra Đúng ≠ Suy luận Thống kê Đúng.
Wasserstein và Lazar (2016), cũng như Wasserstein et al. (2019), nhấn mạnh rằng kết luận khoa học không nên được rút gọn thành việc một giá trị p vượt qua hay không vượt qua ngưỡng .05. Một suy luận có giá trị cần xem xét bối cảnh, độ bất định, độ lớn hiệu ứng và toàn bộ bằng chứng.
Do đó:
Ý nghĩa Thống kê ≠ Tầm quan trọng của Bằng chứng.
Trong môi trường GenAI, sự phân biệt này đặc biệt quan trọng. AI có thể báo cáo chính xác p = .032 nhưng vẫn tạo ra diễn giải không phù hợp nếu coi kết quả đó là bằng chứng chắc chắn, bỏ qua kích thước hiệu ứng hoặc suy diễn quan hệ nhân quả.
Nghiên cứu này định nghĩa Statistical Judgment Quality là mức độ mà người học có khả năng lựa chọn, đánh giá, diễn giải, giới hạn và bảo vệ một suy luận thống kê dựa trên câu hỏi nghiên cứu, dữ liệu, giả định, kết quả phân tích và độ bất định.
SJQ bao gồm tám miền:
- sự phù hợp của phương pháp;
- đánh giá giả định;
- diễn giải giá trị p;
- diễn giải kích thước hiệu ứng;
- diễn giải khoảng tin cậy;
- xử lý ngoại lệ;
- xử lý dữ liệu thiếu;
- giới hạn suy luận nhân quả.
SJQ vì thế không đồng nhất với statistical knowledge, computational accuracy hoặc confidence.
- STATISTICAL LITERACY VÀ NỀN TẢNG CỦA XÁC MINH
Statistical Literacy (SL) được xem là năng lực hiểu, diễn giải và đánh giá phê phán bằng chứng thống kê. Trong môi trường AI, chức năng quan trọng nhất của SL không chỉ là giúp người học tự phân tích mà còn cung cấp tiêu chuẩn để đánh giá phân tích do AI đề xuất.
Một người học chỉ có thể xác minh một khuyến nghị khi biết điều gì cần được xác minh.
Nếu AI đề xuất hồi quy tuyến tính, người học cần hiểu cấu trúc biến, giả định, hình thức quan hệ, residuals và giới hạn của suy luận. Nếu AI đề xuất loại bỏ ngoại lệ, người học cần hiểu rằng giá trị cực đoan không tự động là dữ liệu sai.
SL cung cấp ba nguồn lực.
Thứ nhất, khung kỳ vọng: người học biết một phân tích hợp lý cần bao gồm những yếu tố nào.
Thứ hai, tiêu chuẩn chẩn đoán: người học biết dấu hiệu nào cho thấy một khuyến nghị có vấn đề.
Thứ ba, kỷ luật suy luận: người học biết khi nào bằng chứng không đủ để hỗ trợ một kết luận mạnh.
Tuy nhiên, kiến thức không bảo đảm hành động.
Do đó:
Biết cách Xác minh ≠ Thực hiện Xác minh.
SL được xem là tiền đề của VB, chứ không phải chính VB.
- AUTOMATION DEPENDENCE VÀ CON ĐƯỜNG THAY THẾ
Automation Dependence được định nghĩa là xu hướng trong đó người học chuyển giao phán đoán phân tích cho AI đến mức giảm hoặc từ bỏ đánh giá độc lập.
Khái niệm này khác với AI Use.
Một người có thể sử dụng AI thường xuyên nhưng phản biện mọi đề xuất. Người khác có thể chỉ hỏi AI một lần nhưng chấp nhận hoàn toàn.
Do đó:
Sử dụng AI ≠ Phụ thuộc AI.
Bằng chứng về overreliance cho thấy người dùng có thể tiếp tục làm theo khuyến nghị AI dù có thông tin bối cảnh mâu thuẫn. Trong thống kê, nguy cơ này đặc biệt đáng chú ý vì nhiều lỗi không thể nhận diện bằng kiến thức phổ thông mà cần kiến thức miền.
Năm biểu hiện của AD được đề xuất:
AD1 – Chấp nhận không xác minh.
AD2 – Tiếp tục làm theo AI khi khuyến nghị sai.
AD3 – Từ bỏ phán đoán ban đầu mà không có căn cứ độc lập.
AD4 – Không xem xét phương án thay thế sau khi nhận khuyến nghị AI.
AD5 – Neo nhận thức vào định khung của AI.
Automation Dependence do đó là một cấu trúc hành vi về chuyển giao thẩm quyền phán đoán, không phải thước đo mức sử dụng công nghệ.
Con đường thay thế được biểu diễn:
AI Assistance → Automation Dependence → ↓ Statistical Judgment Quality.
- VERIFICATION BEHAVIOR VÀ CON ĐƯỜNG TĂNG CƯỜNG
Verification Behavior là tập hợp các hành động quan sát được mà người học sử dụng để kiểm tra độc lập tính phù hợp, tính đúng đắn, độ bất định và giới hạn của khuyến nghị AI trước khi đưa ra phán đoán cuối cùng.
VB khác với review.
Đọc lại đầu ra AI không phải xác minh.
Hỏi cùng AI “bạn có chắc không?” cũng không tạo ra xác minh độc lập.
VB có thể bao gồm:
- kiểm tra dữ liệu;
- kiểm tra giả định;
- tái tính toán;
- chạy mã độc lập;
- kiểm tra code;
- so sánh mô hình;
- thực hiện phân tích thay thế;
- kiểm tra độ nhạy;
- tham khảo nguồn phương pháp;
- đánh giá effect size;
- đánh giá confidence interval;
- sửa khuyến nghị AI;
- biện minh lựa chọn cuối cùng.
Do đó:
Human Review ≠ Statistical Verification.
Điểm này làm rõ khái niệm meaningful human oversight. Sự có mặt của con người trong quy trình không đủ. Con người phải có cả năng lực lẫn hành vi để phát hiện và sửa sai.
Con đường tăng cường là:
Statistical Literacy → Verification Behavior → ↑ Statistical Judgment Quality.
Giao thức Xác minh được thiết kế để kích hoạt cơ chế này:
AI + Verification Protocol → Verification Behavior → ↑ SJQ.
- APPROPRIATE RELIANCE: CẤU TRÚC LIÊN QUAN NHƯNG KHÔNG ĐỒNG NHẤT
Một hiệu chỉnh quan trọng sau phản biện là tách rõ Automation Dependence, Verification Behavior và Appropriate Reliance.
Appropriate Reliance không phải một dạng khác của VB.
Nó là chất lượng của quyết định phụ thuộc vào AI xét theo tính đúng đắn của lời khuyên.
Nếu AI đúng và người học chấp nhận, đây là appropriate acceptance.
Nếu AI sai và người học từ chối hoặc sửa, đây là appropriate resistance.
Nếu AI sai và người học chấp nhận, đây là overreliance.
Nếu AI đúng và người học từ chối không có căn cứ, đây là underreliance.
Do đó, Appropriate Reliance là outcome of calibration, trong khi Verification Behavior là process mechanism.
Automation Dependence phản ánh xu hướng chuyển giao phán đoán.
SJQ phản ánh chất lượng của suy luận cuối cùng.
Bốn cấu trúc vì vậy có ranh giới:
AD = xu hướng phụ thuộc
VB = quá trình kiểm chứng
Appropriate Reliance = mức hiệu chỉnh quyết định với chất lượng AI
SJQ = chất lượng phán đoán thống kê cuối cùng.
Sự phân biệt này là thiết yếu đối với discriminant validity của mô hình.
- AI LITERACY NHƯ ĐIỀU KIỆN BIÊN
AI Literacy bao gồm hiểu biết về AI, khả năng sử dụng, đánh giá, nhận diện giới hạn và trách nhiệm đạo đức.
Ng et al. (2021) cho thấy AI literacy không nên được rút gọn thành khả năng thao tác. Các khung UNESCO tiếp tục nhấn mạnh tư duy lấy con người làm trung tâm, đạo đức và đánh giá có trách nhiệm.
Trong bối cảnh Việt Nam, nghiên cứu gần đây cũng cho thấy AI literacy có thể bao gồm hiểu biết, ứng dụng và đạo đức/trách nhiệm.
Tuy nhiên:
AI Literacy ≠ Statistical Literacy.
Biết AI có thể hallucinate không cho biết một kiểm định có phù hợp hay không.
Do đó, AIL được xem là boundary condition.
AIL cao có thể giúp người học:
- nhận biết AI không phải nguồn thẩm quyền tuyệt đối;
- hiểu đầu ra cần xác minh;
- nhận diện uncertainty;
- đặt câu hỏi phản biện;
- tránh anthropomorphism;
- nhận diện giới hạn dữ liệu và đạo đức.
Vì vậy, AIL được kỳ vọng làm giảm AI Assistance → AD và tăng AI Assistance → VB.
- KIẾN TRÚC LẬP LUẬN TÍCH HỢP
Mười ba phát biểu học thuật của nghiên cứu được tích hợp thành một mạch duy nhất thay vì được trình bày như các trích dẫn độc lập.
Schwarz (2025) thiết lập điểm khởi đầu: GenAI có thể mở rộng năng lực phân tích nhưng không thay thế nhu cầu về hiểu biết thống kê.
Ellis và Slade (2023) đưa vấn đề sang cấp độ sư phạm: giá trị của AI phụ thuộc vào cách hoạt động tương tác được thiết kế.
Nghiên cứu về overreliance bổ sung nguy cơ: con người có thể làm theo AI ngay cả khi có bằng chứng mâu thuẫn.
Từ đây, appropriate reliance trở thành mục tiêu hợp lý hơn maximum trust.
Các khung AI literacy của Ng et al. và UNESCO cho thấy người dùng cần khả năng đánh giá phê phán chứ không chỉ khả năng sử dụng.
Tuy nhiên, AI literacy không đủ để xác minh thống kê; Statistical Literacy cung cấp kiến thức miền cần thiết.
Điều này dẫn tới Verification Behavior như cơ chế nối năng lực với phán đoán.
Quan điểm của Wasserstein và cộng sự về suy luận thống kê tiếp tục mở rộng tiêu chuẩn đánh giá: một phán đoán tốt không thể bị rút gọn thành p < .05 mà phải xem xét uncertainty, effect magnitude, context và limitations.
Cuối cùng, human-centred AI yêu cầu quyền chủ thể và trách nhiệm của con người phải được duy trì.
Toàn bộ kiến trúc có thể biểu diễn:
AI Capability
→ Analytical Opportunity
→ Reliance Risk
→ Need for Calibrated Reliance
→ Statistical Literacy + AI Literacy
→ Verification Behavior
→ Defensible Statistical Judgment
→ Human Scientific Accountability.
Mạch này giải thích vì sao AI không có một hiệu ứng giáo dục cố định.
Cùng một capability có thể dẫn đến displacement hoặc augmentation tùy cơ chế hành vi được kích hoạt.
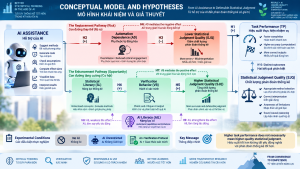
- MÔ HÌNH KHÁI NIỆM VÀ GIẢ THUYẾT
9.1. Con đường thay thế
AI Assistance → Automation Dependence → Lower SJQ
H1. Các điều kiện có AI sẽ cải thiện hiệu suất thực hiện nhiệm vụ so với điều kiện Không AI.
H2. Nhóm AI Không Giới hạn sẽ có Automation Dependence cao hơn nhóm Không AI và AI + Verification.
H3. Automation Dependence có quan hệ nghịch với Statistical Judgment Quality.
H6. Automation Dependence trung gian hóa tác động bất lợi của AI Không Giới hạn lên SJQ.
9.2. Con đường tăng cường
Statistical Literacy → Verification Behavior → Higher SJQ
H4. Statistical Literacy có quan hệ thuận với Verification Behavior.
H5. Verification Behavior có quan hệ thuận với SJQ.
H7. Verification Behavior trung gian hóa tác động tích cực của AI + Verification lên SJQ.
9.3. Điều kiện biên
H8. AI Literacy điều tiết tác động của AI Assistance lên Automation Dependence; AIL cao làm suy yếu tác động này.
H9. AI Literacy điều tiết tác động của AI Assistance lên Verification Behavior; AIL cao làm tăng xu hướng xác minh.
9.4. Hiệu suất và phán đoán
H10. Hiệu suất thực hiện nhiệm vụ và Statistical Judgment Quality là hai kết quả phân biệt về mặt thực nghiệm; cải thiện hiệu suất không tất yếu đồng nghĩa với cải thiện SJQ.
- PHƯƠNG PHÁP NGHIÊN CỨU ĐỀ XUẤT
10.1. Thiết kế
Nghiên cứu sử dụng thiết kế thực nghiệm ngẫu nhiên ba điều kiện:
A – No AI
B – AI Unrestricted
C – AI + Verification Protocol
Đối sánh B–C là đối sánh chính vì cả hai nhóm đều được tiếp cận cùng hệ thống AI. Khác biệt trọng yếu nằm ở behavioral architecture.
Điều này cho phép kiểm tra một câu hỏi mạnh hơn “AI có hiệu quả không?”:
Cùng một AI nhưng cách tổ chức tương tác khác nhau có tạo ra chất lượng phán đoán khác nhau hay không?
10.2. Người tham gia
Đối tượng mục tiêu là sinh viên đại học đã hoàn thành ít nhất một học phần thống kê hoặc phương pháp nghiên cứu định lượng.
Cỡ mẫu phải được xác định trước bằng power analysis dựa trên primary contrast và mô hình chính.
Không sử dụng effect size quan sát sau nghiên cứu để biện minh hồi cứu cho cỡ mẫu.
10.3. Phân nhóm
Người tham gia được phân bổ ngẫu nhiên sau khi hoàn thành baseline assessment.
Nếu tuyển mẫu từ nhiều lớp, có thể sử dụng block randomization theo lớp hoặc prior statistical ability.
10.4. Chuẩn hóa môi trường AI
Cần ghi nhận:
- nhà cung cấp;
- tên mô hình;
- phiên bản;
- ngày truy cập;
- system settings;
- browsing availability;
- giới hạn prompt;
- memory settings;
- các hạn chế dữ liệu;
- thay đổi mô hình trong thời gian nghiên cứu.
- NHIỆM VỤ PHÁN ĐOÁN THỐNG KÊ
Các nhiệm vụ phải đánh giá reasoning thay vì recall.
11.1. Lựa chọn phương pháp
Người học chọn và biện minh phương pháp phù hợp với câu hỏi, thiết kế và dữ liệu.
11.2. Kiểm tra giả định
Người học xác định giả định nào quan trọng và hậu quả của vi phạm.
11.3. Diễn giải giá trị p
Đánh giá khả năng tránh các diễn giải sai phổ biến.
11.4. Kích thước hiệu ứng
Phân biệt statistical detectability và substantive importance.
11.5. Khoảng tin cậy
Đánh giá precision và uncertainty.
11.6. Ngoại lệ
Xác định liệu quan sát bất thường cần điều tra, giữ, mô hình hóa khác hay loại bỏ.
11.7. Dữ liệu thiếu
Đánh giá tác động của missingness và lựa chọn chiến lược xử lý.
11.8. Giới hạn nhân quả
Phân biệt association với causation dựa trên thiết kế.
- GIAO THỨC XÁC MINH
Giao thức gồm tám bước:
- Câu hỏi nghiên cứu
Xác định điều cần suy luận.
- Phương pháp ứng viên
Hình thành ít nhất một phương án trước khi chấp nhận AI.
- Giả định
Xác định các điều kiện quan trọng.
- Khuyến nghị AI
Thu nhận đề xuất từ hệ thống.
- Kiểm tra độc lập
Đối chiếu khuyến nghị với dữ liệu, thiết kế và kiến thức thống kê.
- Phương án thay thế
Xem xét ít nhất một phương án hợp lý khác khi có.
- Độ bất định
Đánh giá effect size, CI, sensitivity và limitations.
- Biện minh cuối cùng
Giải thích tại sao quyết định cuối cùng được chấp nhận.
Chuỗi đầy đủ:
Câu hỏi
→ Phương pháp Ứng viên
→ Giả định
→ Khuyến nghị AI
→ Kiểm tra Độc lập
→ Phương án Thay thế
→ Độ Bất định
→ Biện minh Cuối cùng.
- AI TRAP BEHAVIORAL CALIBRATION PARADIGM
Một đóng góp phương pháp trung tâm của nghiên cứu là nâng AI Trap Cases từ một kỹ thuật tạo tình huống thành mô thức đo hiệu chỉnh hành vi.
Nguyên tắc cơ bản là chất lượng reliance không thể được quan sát nếu AI luôn đúng.
Do đó, AI validity được thao tác có chủ đích.
Các trường hợp gồm:
- AI đúng hoàn toàn;
- AI đúng phương pháp nhưng diễn giải thiếu;
- AI tính toán đúng nhưng suy luận quá mức;
- AI đề xuất phương pháp sai nhưng có vẻ hợp lý;
- AI bỏ qua giả định;
- AI đưa ra ngôn ngữ nhân quả không được thiết kế hỗ trợ.
Bốn trạng thái hiệu chỉnh:
| Chất lượng AI | Hành vi người học | Phân loại |
| Đúng | Chấp nhận | Appropriate acceptance |
| Đúng | Từ chối không hợp lý | Underreliance |
| Sai | Chấp nhận | Overreliance |
| Sai | Từ chối/hiệu chỉnh | Appropriate resistance |
Do đó:
Appropriate Reliance ≠ Acceptance Rate.
Chỉ số quan trọng là khả năng phân biệt chất lượng lời khuyên.
Có thể phát triển:
- Appropriate Acceptance Rate;
- Appropriate Resistance Rate;
- Overreliance Rate;
- Underreliance Rate;
- Correction Quality;
- Calibration Accuracy.
Mô thức này tạo ra một outcome hành vi mạnh hơn generalized trust scale.
- ĐO LƯỜNG
14.1. Statistical Literacy
Ưu tiên performance-based assessment.
Các miền gồm variability, sampling, uncertainty, significance, effect size, confidence interval, assumptions và causal reasoning.
14.2. AI Literacy
Năm miền chính:
- kiến thức;
- ứng dụng;
- đánh giá phê phán;
- nhận thức giới hạn;
- đạo đức và trách nhiệm.
Nên kết hợp objective assessment với self-report.
14.3. Automation Dependence
AD được đo chủ yếu từ hành vi:
AD1 – unverified acceptance;
AD2 – following erroneous AI;
AD3 – judgment abandonment;
AD4 – alternative suppression;
AD5 – AI anchoring.
14.4. Verification Behavior
VB được mã hóa từ:
- kiểm tra dữ liệu;
- kiểm tra giả định;
- code inspection;
- recalculation;
- alternative analysis;
- source checking;
- sensitivity checking;
- uncertainty qualification;
- correction;
- justification.
14.5. Appropriate Reliance
Appropriate Reliance được xác định từ tương tác:
AI validity × learner response.
Đây là outcome calibration, không phải mediator.
14.6. Statistical Judgment Quality
SJQ là outcome chính và được đánh giá bằng rubric đa chiều:
- methodological fit;
- assumption reasoning;
- inferential accuracy;
- uncertainty;
- effect magnitude;
- alternatives;
- causal restraint;
- final justification.
- DỮ LIỆU QUÁ TRÌNH
Quá trình được ghi nhận:
Phán đoán Ban đầu
→ Prompt
→ AI Output
→ Accept/Reject
→ Verification
→ Correction
→ Final Judgment
→ Justification.
Điều này cho phép phân biệt:
AI Đề xuất ≠ Sinh viên Chấp nhận ≠ Được Xác minh.
Process traces cũng cho phép xác định hướng thay đổi:
- sai → đúng;
- đúng → sai;
- đúng → đúng;
- sai → sai.
Đặc biệt, trường hợp:
Human initially correct → AI wrong → Human changes to wrong
là bằng chứng hành vi mạnh của automation-induced displacement.
Ngược lại:
Human initially wrong → AI recommendation → Human independently verifies → Human corrects
phản ánh augmentation.
- ĐỘ TIN CẬY VÀ GIÁ TRỊ ĐO LƯỜNG
Các nhiệm vụ mở cần ít nhất hai người chấm độc lập cho một tỷ lệ đủ lớn hoặc toàn bộ mẫu khi khả thi.
Quy trình gồm:
- coding manual;
- anchor responses;
- training;
- calibration;
- blind condition labels;
- disagreement resolution.
ICC hoặc weighted kappa được sử dụng tùy thang đo.
Tuy nhiên:
Reliability ≠ Validity.
Content validity cần được đánh giá bởi chuyên gia thống kê, phương pháp nghiên cứu và AI in education.
Construct validity cần kiểm tra cấu trúc của SL, AIL, AD, VB và SJQ.
Discriminant validity đặc biệt quan trọng giữa:
AD – VB – Appropriate Reliance – SJQ.
- KẾ HOẠCH PHÂN TÍCH THỐNG KÊ
17.1. Preregistration
Trước khi thu thập dữ liệu, nghiên cứu nên đăng ký trước:
- primary outcome;
- primary contrast;
- hypotheses;
- exclusion criteria;
- stopping rule;
- coding rules;
- analysis models;
- missing-data strategy;
- robustness analyses.
17.2. Primary outcome
Primary outcome:
Statistical Judgment Quality.
Primary contrast:
AI Unrestricted vs. AI + Verification Protocol.
Đây là đối sánh có giá trị lý thuyết cao nhất.
17.3. Manipulation check
Nhóm Verification phải có VB cao hơn nhóm AI Unrestricted.
Nếu không, intervention không được xem là đã hoạt động theo thiết kế.
17.4. Phân tích H1–H3
So sánh thời gian/efficiency giữa điều kiện.
So sánh AD.
Ước lượng quan hệ AD → SJQ.
Báo cáo effect sizes và confidence intervals.
17.5. Mediation
Kiểm tra:
AI Unrestricted → AD → SJQ
và:
AI + Verification → VB → SJQ.
Ước lượng indirect effects cùng bootstrap hoặc interval estimation phù hợp.
17.6. Moderation
Kiểm tra:
AI Assistance × AIL → AD
và:
AI Assistance × AIL → VB.
Không diễn giải moderation chỉ dựa vào significance của từng simple slope.
17.7. Trap-case models
Vì nhiều nhiệm vụ được lồng trong cùng sinh viên, mixed-effects modeling được ưu tiên khi phù hợp.
Outcome nhị phân Accept/Reject có thể được phân tích bằng generalized mixed-effects model.
Predictors:
- AI validity;
- condition;
- AIL;
- SL;
- interaction terms.
Random intercept cho participant và, nếu thiết kế cho phép, task.
17.8. Missing data
Cần mô tả:
- mức missingness;
- pattern;
- nguyên nhân khả dĩ;
- phương pháp xử lý.
Không tự động sử dụng complete-case analysis nếu thiếu dữ liệu có thể gây thiên lệch.
17.9. Multiplicity
Primary hypothesis/contrast phải được xác định trước.
Các phân tích thứ cấp và exploratory cần được phân biệt rõ.
17.10. Robustness và sensitivity
Có thể bao gồm:
- alternative scoring specifications;
- exclusion of low-engagement cases;
- models with baseline ability;
- models with/without class clustering;
- alternative operationalization of VB;
- sensitivity to trap-case difficulty.
17.11. Nguyên tắc diễn giải
Báo cáo phải ưu tiên:
Effect Size + Confidence Interval + Uncertainty + Model Diagnostics + Robustness + Substantive Meaning.
Không sử dụng p < .05 như tiêu chuẩn duy nhất của bằng chứng.
- KẾT QUẢ
Phiên bản hiện tại là theoretical-development and experimental-protocol manuscript.
Do nghiên cứu thực nghiệm chưa được tiến hành, phần này không báo cáo β, p, confidence interval, effect size, reliability coefficient hoặc bất kỳ kết quả thực nghiệm giả định nào.
Sau khi dữ liệu được thu thập, Results nên được tổ chức theo thứ tự:
- participant flow;
- baseline balance;
- manipulation check;
- primary outcome;
- secondary outcomes;
- mediation;
- moderation;
- AI trap calibration;
- robustness and sensitivity analyses.
Việc giữ phần Results ở trạng thái chưa có dữ liệu là cần thiết để bảo đảm liêm chính khoa học.
- THẢO LUẬN
Đóng góp quan trọng nhất của mô hình không nằm ở tuyên bố rằng AI “tốt” hoặc “xấu” đối với học thống kê. Mô hình giải thích vì sao cùng một công nghệ có thể tạo ra hai kết quả khác nhau.
Trong con đường displacement, AI trở thành nguồn thẩm quyền nhận thức. Người học nhận khuyến nghị trước khi hình thành đánh giá độc lập, neo vào cách AI định khung vấn đề, giảm tìm kiếm phương án thay thế và chấp nhận đầu ra mà không kiểm tra đủ.
Trong con đường augmentation, AI đóng vai trò mở rộng không gian phân tích. Nó có thể tạo mã, đề xuất phương án, giải thích hoặc hỗ trợ khám phá, nhưng các đầu ra vẫn được xem là provisional claims cần xác minh.
Do đó, biến quyết định không đơn thuần là AI access.
Nó là:
Architecture of Human–AI Interaction.
Điều này giải thích tại sao efficiency và learning quality có thể tách rời.
AI có thể làm một sinh viên nhanh hơn mà không làm sinh viên đó giỏi hơn trong việc đánh giá bằng chứng.
Ngược lại, một Verification Protocol có thể ban đầu làm chậm quá trình vì người học phải kiểm tra nhiều hơn nhưng tạo ra chất lượng suy luận tốt hơn.
Vì vậy:
Efficiency Gain ≠ Inference Quality Gain.
Đóng góp thứ hai nằm ở việc tái định nghĩa human oversight.
Human oversight không phải sự hiện diện hình thức của một con người ở cuối chuỗi tự động.
Giám sát có ý nghĩa đòi hỏi:
**Domain Competence
- AI Competence
- Verification Behavior
- Accountability.**
Thiếu domain competence, người dùng không biết phải kiểm tra gì.
Thiếu AI competence, người dùng có thể đánh giá sai khả năng và giới hạn của hệ thống.
Thiếu Verification Behavior, kiến thức không chuyển thành hành động.
Thiếu accountability, verification có thể trở thành box-ticking.
Đóng góp thứ ba là AI Trap Behavioral Calibration Paradigm.
Paradigm này thay đổi câu hỏi từ:
“Người học tin AI đến mức nào?”
sang:
“Người học có điều chỉnh mức phụ thuộc theo chất lượng thực tế của lời khuyên hay không?”
Đây là sự chuyển từ attitude measurement sang behavioral discrimination.
Một người có trust cao nhưng biết từ chối AI sai có thể là người cộng tác với AI tốt hơn người có trust thấp nhưng từ chối cả khuyến nghị đúng.
Đóng góp thứ tư là phân biệt rõ AD, VB, Appropriate Reliance và SJQ.
Bốn khái niệm này đại diện cho bốn tầng:
Tendency → Process → Calibration → Judgment Outcome.
AD = tendency.
VB = process.
Appropriate Reliance = calibration.
SJQ = outcome.
Kiến trúc này tạo khả năng kiểm định cơ chế rõ hơn và giảm conceptual overlap.
- ĐÓNG GÓP LÝ THUYẾT
Đóng góp 1 – Dual-Path Theory
Mô hình thay thế câu hỏi đơn hướng “AI ảnh hưởng thế nào?” bằng câu hỏi cơ chế “AI đi qua pathway nào?”.
Đóng góp 2 – Statistical Judgment Quality
SJQ chuyển outcome từ computational correctness sang defensible inference.
Đóng góp 3 – Verification Behavior
VB biến meaningful human oversight thành cơ chế hành vi có thể quan sát.
Đóng góp 4 – Automation Dependence
AD được phân biệt với usage intensity và generalized trust.
Đóng góp 5 – AI Literacy as Boundary Condition
AIL quyết định một phần cách người học tương tác với AI nhưng không thay thế Statistical Literacy.
Đóng góp 6 – Behavioral Calibration Paradigm
AI Trap Cases tạo ra phương pháp thực nghiệm để đo appropriate reliance.
Tổng hợp lại, nghiên cứu đề xuất:
AI Capability
→ Opportunity/Risk
→ Dependence or Verification
→ Calibration
→ Statistical Judgment
→ Scientific Accountability.
- HÀM Ý GIÁO DỤC
Kết quả lý thuyết dẫn đến một thay đổi quan trọng trong thiết kế giáo dục.
Câu hỏi không nên chỉ là:
“Cho phép AI hay cấm AI?”
Mà là:
“AI được phép tham gia ở đâu và người học phải chứng minh phán đoán độc lập như thế nào?”
Một nguyên tắc phù hợp là:
Verification-First Pedagogy.
Quy trình:
Dùng AI
→ Xác minh
→ So sánh
→ Đánh giá Bất định
→ Biện minh.
Đánh giá cũng cần chuyển từ final answer sang reasoning trace.
Sinh viên có thể được yêu cầu nộp:
- initial judgment;
- AI recommendation;
- assumptions;
- verification evidence;
- alternative analysis;
- acceptance/rejection decision;
- final justification.
Việc sử dụng deliberately imperfect AI cũng có giá trị sư phạm.
Nếu sinh viên chỉ gặp AI đúng, họ học cách sử dụng AI nhưng không học cách chống lại AI sai.
AI literacy và Statistical Literacy do đó cần được dạy song song nhưng phân biệt.
- ĐẠO ĐỨC VÀ QUẢN TRỊ AI
Một nghiên cứu sử dụng AI trong phân tích thống kê cần xem xét không chỉ hiệu năng mà cả dữ liệu, quyền riêng tư, tính minh bạch và trách nhiệm.
Giao thức nghiên cứu cần ghi nhận:
- provider;
- model;
- version;
- access date;
- prompts;
- data restrictions;
- logging;
- retention;
- informed consent;
- de-identification;
- model changes.
Dữ liệu cá nhân hoặc dữ liệu bị hạn chế không được đưa vào hệ thống bên ngoài nếu chưa được phép.
Nguyên tắc trách nhiệm của nghiên cứu là:
AI tạo
→ Con người đánh giá
→ Con người xác minh
→ Con người biện minh
→ Con người chịu trách nhiệm.
Do đó:
Ủy thác Phân tích ≠ Ủy thác Trách nhiệm Khoa học.
- HẠN CHẾ
Thứ nhất, AI thay đổi nhanh nên external validity theo thời gian là thách thức.
Thứ hai, prompt competence có thể tạo heterogeneity.
Thứ ba, novelty effects có thể ảnh hưởng engagement.
Thứ tư, prior statistical ability là confounder tiềm năng cần đo và kiểm soát.
Thứ năm, trap cases có thể không tái tạo hoàn toàn complexity của nghiên cứu thực tế.
Thứ sáu:
Immediate Performance ≠ Durable Learning.
Một intervention có thể cải thiện SJQ trong phiên thực nghiệm mà không tạo transfer lâu dài.
Thứ bảy, AD và VB không phải hai đầu của cùng một continuum. Người học có thể biểu hiện cả hai ở những thời điểm khác nhau.
Thứ tám, self-reported AI literacy có nguy cơ chịu calibration bias.
Thứ chín, hiệu quả của Verification Protocol có thể phụ thuộc vào task complexity và expertise.
Cuối cùng, framework hiện tại phải được kiểm định trước khi các quan hệ nhân quả được khẳng định.
- HƯỚNG NGHIÊN CỨU TƯƠNG LAI
Nghiên cứu tiếp theo nên kiểm tra Human-first vs. AI-first.
AI-first có thể tăng tốc nhưng tăng anchoring.
Human-first có thể bảo vệ independent judgment nhưng tăng cognitive load.
Một hướng thứ hai là expertise.
Novices có thể hưởng lợi lớn nhất từ AI nhưng đồng thời có khả năng xác minh thấp nhất.
Một hướng thứ ba là delayed unaided assessment.
Để tuyên bố learning, không chỉ performance, người học cần được kiểm tra sau đó mà không có AI.
Một hướng thứ tư là so sánh answer-generating AI với verification-oriented AI.
Một AI được thiết kế để hỏi “Bạn đã kiểm tra giả định nào?” có thể tạo tác động giáo dục khác với AI trực tiếp đưa ra đáp án.
Một hướng thứ năm là longitudinal development:
Repeated AI Use
→ Verification/Dependence Habits
→ Epistemic Agency
→ Long-Term Statistical Judgment.
Một hướng thứ sáu là transfer.
Nếu Verification Protocol có giá trị giáo dục thực sự, người học phải dần nội hóa logic của giao thức và áp dụng nó cho những vấn đề mới mà không cần scaffold bên ngoài.
- KẾT LUẬN
GenAI đang làm giảm mạnh chi phí kỹ thuật của phân tích thống kê. AI có thể tạo mã, đề xuất phương pháp, giải thích giả định, tính toán, trực quan hóa và hỗ trợ viết báo cáo.
Nhưng khả năng tự động hóa thao tác không giải quyết vấn đề cốt lõi của suy luận khoa học.
Một phân tích thống kê chỉ có giá trị khi người thực hiện có thể xác định:
- phương pháp có phù hợp không;
- giả định có hợp lý không;
- bằng chứng mạnh đến đâu;
- kết luận còn bất định như thế nào;
- phương án thay thế có thể làm thay đổi kết luận hay không;
- giới hạn nhân quả nằm ở đâu.
Do đó:
Computation ≠ Statistical Judgment.
Nghiên cứu đề xuất hai pathway.
Displacement Pathway
AI Assistance
→ Automation Dependence
→ ↓ Statistical Judgment Quality.
Augmentation Pathway
Statistical Literacy
→ Verification Behavior
→ ↑ Statistical Judgment Quality.
Trong môi trường được thiết kế phù hợp:
AI + Verification Protocol
→ Verification Behavior
→ ↑ Statistical Judgment Quality.
AI Literacy là boundary condition giúp giải thích tại sao cùng một AI có thể tạo ra các phản ứng khác nhau.
Một đóng góp đặc biệt của nghiên cứu là chuyển appropriate reliance từ thái độ sang hành vi thông qua AI Trap Behavioral Calibration Paradigm.
Người sử dụng AI tốt không phải người luôn chấp nhận AI.
Cũng không phải người luôn nghi ngờ AI.
Đó là người có khả năng phân biệt khi nào AI đáng tin và khi nào AI phải bị phản biện.
Bảy phân biệt của nghiên cứu có thể được tổng kết:
Tính toán ≠ Phán đoán Thống kê
Đầu ra Đúng ≠ Suy luận Đúng
Khuyến nghị AI ≠ Biện minh Thống kê
Ý nghĩa Thống kê ≠ Tầm quan trọng Bằng chứng
Human Review ≠ Statistical Verification
AI Assistance ≠ Automation Dependence
Efficiency Gain ≠ Inference Quality Gain
Từ đó, tiêu chuẩn quan trọng để đánh giá GenAI trong giáo dục thống kê không phải số lượng thao tác AI có thể tự động hóa.
Tiêu chuẩn là liệu người học có còn có thể độc lập trả lời:
Vì sao phương pháp này phù hợp?
Giả định nào hỗ trợ suy luận?
Điều gì có thể làm cho khuyến nghị AI sai?
Tôi đã xác minh bằng cách nào?
Kết luận còn bất định đến đâu?
Tôi có thể bảo vệ suy luận này mà không chỉ viện dẫn thẩm quyền của AI hay không?
Nếu người học không thể trả lời, AI có nguy cơ đã thay thế phán đoán.
Nếu người học có thể trả lời và sử dụng AI để mở rộng khả năng phân tích mà vẫn duy trì quyền kiểm soát nhận thức, AI có thể thực sự tăng cường năng lực khoa học.
Luận đề cuối cùng của nghiên cứu là:
AI có thể tự động hóa tính toán thống kê; nhưng phán đoán thống kê vẫn phải được con người học tập, thực hành, xác minh, giới hạn và bảo vệ bằng trách nhiệm khoa học.
TUYÊN BỐ VỀ VIỆC SỬ DỤNG GENERATIVE AI VÀ CÔNG NGHỆ HỖ TRỢ AI TRONG QUÁ TRÌNH CHUẨN BỊ BẢN THẢO
Trong quá trình chuẩn bị công trình này, tác giả đã sử dụng công cụ trí tuệ nhân tạo tạo sinh để hỗ trợ tổ chức cấu trúc, cải thiện diễn đạt và khả năng đọc của bản thảo. Sau khi sử dụng công cụ, tác giả đã rà soát, kiểm chứng và hiệu chỉnh nội dung khi cần thiết và chịu trách nhiệm đầy đủ đối với nội dung cuối cùng của công trình.
TÀI LIỆU THAM KHẢO
- American Statistical Association. (2016). Guidelines for assessment and instruction in statistics education: College report 2016. American Statistical Association.
- Do, H. V., Bui, T. T., Tran, D. H., Nguyen, H. T., & Dinh, L. D. (2026). Artificial intelligence literacy among Vietnamese university students: Measurement and implications for higher education. IFLA Journal, 52(2), 222–233.
- Ellis, A. R., & Slade, E. (2023). A new era of learning: Considerations for ChatGPT as a tool to enhance statistics and data science education. Journal of Statistics and Data Science Education, 31(2), 128–133.
- Gal, I. (2002). Adults’ statistical literacy: Meanings, components, responsibilities. International Statistical Review, 70(1), 1–25.
- Klingbeil, A., Grützner, C., & Schreck, P. (2024). Trust and reliance on AI: An experimental investigation of overreliance on artificial intelligence advice. Computers in Human Behavior, 160, 108352.
- Lintner, T. (2024). A systematic review of AI literacy scales. npj Science of Learning.
- Miao, F., & Holmes, W. (2023). Guidance for generative AI in education and research. UNESCO.
- Miao, F., Shiohira, K., & Lao, N. (2024). AI competency framework for students. UNESCO.
- Ng, D. T. K., Leung, J. K. L., Chu, S. K. W., & Qiao, M. S. (2021). Conceptualizing AI literacy: An exploratory review. Computers and Education: Artificial Intelligence, 2, 100041.
- Passi, S., Dhanorkar, S., & Vorvoreanu, M. (2024). Appropriate reliance on generative AI: Research synthesis (MSR-TR-2024-7). Microsoft Research.
- Schwarz, J. (2025). The use of generative AI in statistical data analysis and its impact on teaching statistics at universities of applied sciences. Teaching Statistics, 47(2), 118–128.
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133.
- Wasserstein, R. L., Schirm, A. L., & Lazar, N. A. (2019). Moving to a world beyond “p < 0.05.” The American Statistician, 73(sup1), 1–19.
- Zhai, C., Wibowo, S., & Li, L. D. (2024). The effects of over-reliance on AI dialogue systems on students’ cognitive abilities: A systematic review. Smart Learning Environments, 11, Article 28.
