
THE IMPACT OF USING CHATGPT AS AN “ACADEMIC CRITIQUE PARTNER” ON THE DEVELOPMENT OF ARGUMENTATIVE WRITING SKILLS
Nguyễn Văn Hùng
HIGHLIGHTS
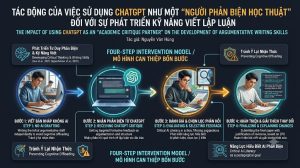
- Xác lập mô hình can thiệp bốn bước (Four-Step Intervention Model): Tích hợp ChatGPT như “người phản biện học thuật” (academic critique partner) vào quy trình viết qua bốn giai đoạn: viết bản nháp không có AI → nhận phản biện từ ChatGPT → đánh giá và chọn lọc phản hồi → viết bản cuối và giải thích thay đổi, dựa trên nguyên lý Vùng Phát triển Gần nhất (ZPD) và Học nghề Nhận thức (Cognitive Apprenticeship).
- Luận giải cơ chế “phản hồi quá trình có kiểm soát” (Controlled Formative Feedback): Đối chiếu với bằng chứng sơ bộ từ Oppenheimer, Cash và Connell Pensky (2025) về hiệu quả của LLM như đối tác học tập hợp tác, với cải thiện khoảng một độ lệch chuẩn trên ba chiều. ▸ [EE-02]
- Tích hợp bằng chứng về tác động nhận thức của ChatGPT: Tổng quan hệ thống của Guo và cộng sự (2025) xác nhận ChatGPT có thể tăng cường tư duy phản biện khi được nhúng trong thiết kế có giàn giáo, nhưng gây hại khi sử dụng không cấu trúc.
- Bối cảnh hóa thực tiễn Việt Nam 2020–2026: Đối chiếu với nghiên cứu của Meniado và cộng sự (2024) về perceptions của sinh viên EFL tại Việt Nam, và can thiệp hành động của Lam và Nam (2025) tại Học viện Phòng không – Không quân – nghiên cứu tiên phong tích hợp ChatGPT vào giảng dạy viết luận nghị luận tiếng Việt cho học viên quân sự Lào, với “vùng không AI” ở giai đoạn viết nháp. ▸ [EV-01]
- Đề xuất thiết kế thực nghiệm đối chứng cho kiểm định tương lai: So sánh nhóm đối chứng (phản hồi từ giảng viên theo cùng rubric) với nhóm thực nghiệm (phản hồi từ ChatGPT + giảng viên) trên ba bài luận trong 10 tuần, với đánh giá độc lập bởi hai giảng viên và phân tích thinking trail. ▸ [IC-06]
- Xác lập khung “hiểu biết AI phản biện” (Critical AI Literacy): Đề xuất năng lực đánh giá, chọn lọc và tích hợp phản hồi AI như một mục tiêu sư phạm độc lập, dựa trên bằng chứng về nguy cơ ủy thác nhận thức và “hiệu ứng kỹ năng rỗng”.
TÓM TẮT BÀI BÁO (STRUCTURED ABSTRACT)
Tóm tắt tiếng Việt
Bối cảnh (Background): Sinh viên ngày càng sử dụng ChatGPT để viết bài luận học thuật, nhưng có nguy cơ suy giảm kỹ năng viết lập luận do ủy thác nhận thức (cognitive offloading) và phụ thuộc quá mức vào AI. OECD (2026) cảnh báo rằng việc ủy thác nhiệm vụ nhận thức cho chatbot phổ thông tạo ra rủi ro “lười biếng siêu nhận thức” (metacognitive laziness) và có thể cản trở việc hình thành kỹ năng trong dài hạn. Trong một thí nghiệm tại Thổ Nhĩ Kỳ với GPT-4, sinh viên sử dụng AI hoàn thành nhiệm vụ thành công hơn 48%, nhưng hiệu suất giảm 17% khi AI bị loại bỏ. ▸ [EV-02] Nghiên cứu của Guo và cộng sự (2025) xác nhận rằng rủi ro này rõ rệt hơn ở người viết mới và sinh viên có năng lực AI hạn chế.
Vấn đề nghiên cứu (Research Problem): Y văn về phản hồi từ GenAI trong viết học thuật cho thấy ChatGPT có thể cung cấp phản hồi về nội dung và tổ chức với tỷ lệ cao hơn giảng viên. Tại Việt Nam, Lam và Nam (2025) đã tiến hành can thiệp hành động 15 tuần tích hợp ChatGPT vào giảng dạy viết luận nghị luận tiếng Việt cho 32 học viên quân sự Lào, với “vùng không AI” ở giai đoạn viết nháp, và ghi nhận cải thiện có ý nghĩa thống kê về cấu trúc lập luận (p < 0,001). Tuy nhiên, nghiên cứu này thiếu nhóm đối chứng, đối tượng là học viên quân sự Lào học tiếng Việt như ngoại ngữ, và chưa xác lập khung năng lực “critical AI literacy” như mục tiêu sư phạm độc lập. ▸ [EV-01] Oppenheimer, Cash và Connell Pensky (2025) đã cung cấp bằng chứng sơ bộ rằng LLM có thể là đối tác phản biện cải thiện kỹ năng viết lập luận, nhưng nghiên cứu này thiếu nhóm đối chứng và chưa kiểm định tại Việt Nam. ▸ [EE-02] Meniado và cộng sự (2024) khảo sát perceptions của sinh viên EFL tại Thái Lan và Việt Nam, nhưng chỉ dừng ở mức độ perceptions.
Mục tiêu (Purpose): Nghiên cứu đặt ba mục tiêu: (1) xây dựng mô hình can thiệp bốn bước sử dụng ChatGPT như critique partner dựa trên ZPD và Cognitive Apprenticeship; (2) đề xuất thiết kế thực nghiệm có nhóm đối chứng để đánh giá tác động lên chất lượng lập luận và mức độ phụ thuộc AI; (3) nhận diện các yếu tố ảnh hưởng đến hiệu quả can thiệp trong bối cảnh giáo dục đại học Việt Nam.
Phương pháp tiếp cận (Approach): Nghiên cứu vận dụng phương pháp tổng hợp lý thuyết tích hợp, kết nối ZPD của Vygotsky (1978), Học nghề Nhận thức, Phản hồi Quá trình của Nicol và Macfarlane-Dick (2006), và mô hình Human–AI Co-creation với bằng chứng từ Oppenheimer và cộng sự (2025), Meniado và cộng sự (2024), Guo và cộng sự (2025), và Lam và Nam (2025). Thiết kế thực nghiệm đối chứng với 100 sinh viên được đề xuất cho kiểm định tương lai. ▸ [IC-08, EV-01]
Kết quả lý thuyết (Theoretical Results): Nghiên cứu thiết lập mô hình can thiệp bốn bước, xác lập ba biến đo lường cốt lõi (chất lượng lập luận, mức độ phụ thuộc AI, thái độ với AI), và đề xuất ba giả thuyết (H1–H3) về hiệu quả của phản hồi ChatGPT so với phản hồi giảng viên, vai trò của prompt engineering, và sự khác biệt theo năng lực AI của sinh viên.
Đóng góp (Contribution): Đóng góp của bài viết là cung cấp mô hình can thiệp khả vận hành để tích hợp ChatGPT như critique partner trong viết học thuật, bổ sung thiết kế đối chứng mà các nghiên cứu tiên phong tại Việt Nam (Lam & Nam, 2025) chưa có, đồng thời đề xuất khung “critical AI literacy” như một mục tiêu sư phạm. ▸ [EV-01]
Bối cảnh ứng dụng (Context): Giáo dục đại học Việt Nam giai đoạn 2020–2026, với bằng chứng từ Meniado và cộng sự (2024) về perceptions và Lam và Nam (2025) về can thiệp hành động, được lựa chọn làm bối cảnh tham chiếu.
Keywords / Từ khóa: ChatGPT; academic critique partner; argumentative writing; formative feedback; cognitive offloading; critical AI literacy; Vietnamese higher education.
Structured English Abstract
Background: Students increasingly use ChatGPT to write academic essays, but there is a risk of declining argumentative writing skills due to cognitive offloading and over-reliance on AI. The OECD (2026) warns that offloading cognitive tasks to general-purpose chatbots creates risks of “metacognitive laziness.” In an experiment in Turkey with GPT-4, students using AI completed tasks 48% more successfully, but performance dropped 17% when AI was removed. ▸ [EV-02] Research by Guo et al. (2025) confirms that this risk is more pronounced among novice writers and students with limited AI literacy.
Research Problem: The literature on GenAI feedback in academic writing shows that ChatGPT can provide higher ratios of content- and organization-related feedback than teachers. In Vietnam, Lam and Nam (2025) conducted a 15-week action research integrating ChatGPT into Vietnamese argumentative writing instruction for 32 Lao military cadets, with an “AI-free zone” during initial drafting, and reported statistically significant improvement in argument structure (p < .001). However, this study lacked a control group, involved Lao military cadets learning Vietnamese as a foreign language, and did not establish a “critical AI literacy” framework as an independent pedagogical objective. ▸ [EV-01] Oppenheimer, Cash, and Connell Pensky (2025) provided preliminary evidence that LLMs can serve as critical partners improving argumentative writing skills, but this study lacked a control group and has not been validated in Vietnam. ▸ [EE-02] Meniado et al. (2024) surveyed EFL students’ perceptions in Thailand and Vietnam, but stopped at the level of perceptions.
Purpose: The study sets three objectives: (1) to construct a four-step intervention model using ChatGPT as a critique partner based on ZPD and Cognitive Apprenticeship; (2) to propose a controlled experimental design assessing effects on argument quality and AI dependence; (3) to identify factors influencing intervention effectiveness in Vietnamese higher education.
Approach: Adopting an integrative theoretical synthesis, the study connects Vygotsky’s (1978) ZPD, Cognitive Apprenticeship, Formative Feedback theory (Nicol & Macfarlane-Dick, 2006), and the Human–AI Co-creation model with evidence from Oppenheimer et al. (2025), Meniado et al. (2024), Guo et al. (2025), and Lam and Nam (2025). A controlled experimental design with 100 students is proposed for future validation. ▸ [IC-08, EV-01]
Theoretical Results: The study establishes a four-step intervention model, specifies three core measures (argument quality, AI dependence, attitude toward AI), and formulates three propositions (H1–H3) regarding the efficacy of ChatGPT feedback versus teacher feedback, the role of prompt engineering, and differences by students’ AI literacy.
Contribution: The contribution lies in providing an operational intervention model for integrating ChatGPT as a critique partner in academic writing, adding a controlled design that pioneering Vietnamese studies (Lam & Nam, 2025) have not yet employed, while proposing a “critical AI literacy” framework as a pedagogical objective. ▸ [EV-01]
Application Context: Vietnamese higher education during 2020–2026, with evidence from Meniado et al.’s (2024) perceptions study and Lam and Nam’s (2025) action research, serves as the reference context.
Keywords: ChatGPT; academic critique partner; argumentative writing; formative feedback; cognitive offloading; critical AI literacy; Vietnamese higher education.
1. GIỚI THIỆU (INTRODUCTION)
1.1. Bối cảnh (Context)
Sự phổ biến của ChatGPT trong giáo dục đại học giai đoạn 2020–2026 đã tạo ra một thay đổi căn bản trong thực tiễn viết học thuật. Sinh viên ngày càng sử dụng công cụ này để tạo ý tưởng, phác thảo, và thậm chí viết toàn bộ bài luận. Tuy nhiên, song hành với tiện ích là nguy cơ suy giảm kỹ năng viết lập luận – năng lực cốt lõi mà giáo dục đại học kỳ vọng nuôi dưỡng. OECD (2026) trong Digital Education Outlook 2026 cảnh báo rằng việc ủy thác nhiệm vụ nhận thức cho chatbot phổ thông tạo ra rủi ro “lười biếng siêu nhận thức” (metacognitive laziness) và “buông bỏ” (disengagement), từ đó cản trở việc hình thành kỹ năng trong dài hạn. Trong một thí nghiệm tại Thổ Nhĩ Kỳ với GPT-4, sinh viên sử dụng AI hoàn thành nhiệm vụ thành công hơn 48%, nhưng hiệu suất giảm 17% khi AI bị loại bỏ trong điều kiện thi cử truyền thống. ▸ [EV-02]
Tuy nhiên, OECD cũng nhấn mạnh một phân biệt có ý nghĩa thiết kế: khi GenAI được sử dụng dưới sự dẫn dắt của các nguyên tắc sư phạm rõ ràng, nó có thể hỗ trợ học tập và nuôi dưỡng tư duy phản biện, sáng tạo và hợp tác; nhưng khi thiết kế hoặc sử dụng thiếu định hướng sư phạm, “việc ủy thác nhiệm vụ cho GenAI chỉ nâng cao biểu hiện mà không tạo ra lợi ích học tập thực sự”. Điều này có nghĩa là câu hỏi thiết kế sư phạm trở nên cấp thiết: làm thế nào để sử dụng ChatGPT như một “người phản biện học thuật” (academic critique partner) – tức là một tác nhân kích thích phán đoán phản biện của sinh viên – thay vì như một công cụ tạo nội dung thay thế quá trình học?
Nghiên cứu của Oppenheimer, Cash và Connell Pensky (2025) cung cấp bằng chứng sơ bộ có ý nghĩa thiết kế. ▸ [EE-02] Trong một can thiệp kéo dài một học kỳ với 154 sinh viên đại học, sinh viên được yêu cầu viết bài luận lập luận, nhận phê bình từ LLM, và cải thiện bài viết bằng cách tích hợp hoặc phản bác phê bình. Kết quả cho thấy sinh viên cải thiện đáng kể trên ba chiều: chất lượng lập luận ban đầu (từ 2,58 lên 2,90 trên thang 3 điểm), kỹ thuật prompt (từ 2,34 lên 2,89), và chất lượng phản hồi đối với phê bình của AI (từ 2,41 lên 2,88) – mỗi chiều cải thiện khoảng một độ lệch chuẩn. ▸ [IC-02] Tuy nhiên, cần lưu ý rằng đây là thiết kế single-group, không có nhóm đối chứng; tác giả tự thừa nhận cần nghiên cứu thêm để tách biệt hiệu ứng nhân quả. ▸ [EE-02]
1.2. Vấn đề nghiên cứu (Research Problem)
Y văn về sử dụng GenAI trong viết học thuật đang đối mặt với ba khoảng trống liên quan đến câu hỏi can thiệp.
Khoảng trống thứ nhất – thiếu mô hình can thiệp có đối chứng cho bối cảnh Việt Nam. Oppenheimer và cộng sự (2025) đã cung cấp bằng chứng sơ bộ rằng LLM có thể là đối tác phản biện cải thiện kỹ năng viết lập luận trong bối cảnh lớp học Hoa Kỳ, nhưng thiếu nhóm đối chứng. ▸ [EE-02] Tại Việt Nam, Lam và Nam (2025) đã tiến hành can thiệp hành động 15 tuần tích hợp ChatGPT vào giảng dạy viết luận nghị luận tiếng Việt cho 32 học viên quân sự Lào tại Học viện Phòng không – Không quân, với “vùng không AI” ở giai đoạn viết nháp ban đầu, và ghi nhận cải thiện có ý nghĩa thống kê về cấu trúc lập luận, mạch lạc, ngữ pháp (p < 0,001) . Đây là nghiên cứu tiên phong tại Việt Nam về tích hợp ChatGPT có cấu trúc vào viết luận nghị luận. ▸ [EV-01] Tuy nhiên, nghiên cứu này thiếu nhóm đối chứng, đối tượng là học viên quân sự Lào học tiếng Việt như ngoại ngữ (không phải sinh viên đại học Việt Nam học viết học thuật), và chưa xác lập khung năng lực “critical AI literacy” như mục tiêu sư phạm độc lập. Meniado và cộng sự (2024) đã khảo sát perceptions của sinh viên EFL tại Thái Lan và Việt Nam, nhưng chỉ dừng ở mức độ perceptions. ▸ [EE-06]
Khoảng trống thứ hai – thiếu đánh giá tác động lên kỹ năng độc lập. Các nghiên cứu hiện có thường đo lường chất lượng bài viết cuối cùng hoặc mức độ hài lòng, nhưng ít đo lường liệu sinh viên có phát triển kỹ năng viết lập luận độc lập – khả năng huy động thao tác phản biện khi AI vắng mặt. Oppenheimer và cộng sự (2025) đã cố gắng đo lường chất lượng bài luận viết không có LLM, nhưng thiếu nhóm đối chứng. Lam và Nam (2025) có “vùng không AI” ở viết nháp nhưng không có bài kiểm tra cuối kỳ không AI để đo chuyển giao kỹ năng. ▸ [EV-01]
Khoảng trống thứ ba – thiếu khung “hiểu biết AI phản biện” như mục tiêu sư phạm. OECD (2026) nhấn mạnh tầm quan trọng của tư duy phản biện và siêu nhận thức trong kỷ nguyên AI. Lam và Nam (2025) có đề cập “prompt literacy” và “metacognitive coaching” như năng lực phát triển, nhưng chưa hệ thống hóa thành khung 4 năng lực có thể dạy và đánh giá. ▸ [EV-01] Khung “critical AI literacy” – năng lực đánh giá, chọn lọc, và tích hợp phản hồi AI – chưa được xác lập rõ ràng như một mục tiêu học tập độc lập. ▸ [EE-05]
1.3. Mục tiêu và câu hỏi nghiên cứu (Objectives and Research Questions)
Nghiên cứu đặt ba mục tiêu: (1) xây dựng mô hình can thiệp bốn bước sử dụng ChatGPT như critique partner dựa trên ZPD và Cognitive Apprenticeship; (2) đề xuất thiết kế thực nghiệm có nhóm đối chứng để đánh giá tác động lên chất lượng lập luận và mức độ phụ thuộc AI; (3) nhận diện các yếu tố ảnh hưởng đến hiệu quả can thiệp trong bối cảnh giáo dục đại học Việt Nam.
Câu hỏi nghiên cứu tương ứng: (1) Sử dụng ChatGPT như critique partner có cải thiện chất lượng lập luận của sinh viên không? (2) Sinh viên có phát triển kỹ năng viết lập luận độc lập khi AI vắng mặt không? (3) Các yếu tố nào (năng lực AI, chất lượng prompt, thái độ với AI) ảnh hưởng đến hiệu quả can thiệp?
▸ [IC-08] Định vị phương pháp: Bài viết là một tổng hợp lý thuyết tích hợp nhằm xây dựng mô hình can thiệp và đề xuất thiết kế thực nghiệm cho kiểm định tương lai; bài viết không báo cáo dữ liệu thực nghiệm đã thu thập.
1.4. Phạm vi nghiên cứu (Scope)
Phạm vi lý thuyết giới hạn ở thiết kế can thiệp sử dụng ChatGPT như critique partner trong viết lập luận học thuật, dựa trên ZPD, Cognitive Apprenticeship, và Formative Feedback. Phạm vi thực nghiệm đề xuất giới hạn ở sinh viên năm hai tại một trường đại học Việt Nam, giai đoạn 2020–2026, với 100 sinh viên tham gia trong 10 tuần.
2. CƠ SỞ LÝ THUYẾT TÍCH HỢP (INTEGRATED THEORETICAL FOUNDATIONS)
2.1. Vùng Phát triển Gần nhất và Giàn giáo Nhận thức
Vygotsky (1978) xác lập nguyên lý trung tâm của kiến tạo xã hội: học tập là quá trình kiến tạo tri thức thông qua tương tác xã hội trong Vùng Phát triển Gần nhất (ZPD). Cơ chế then chốt là giàn giáo (scaffolding): hỗ trợ có cấu trúc, tạm thời và giảm dần. Trong bối cảnh sử dụng ChatGPT như critique partner, ZPD cung cấp tiêu chuẩn đánh giá: ChatGPT chỉ có giá trị sư phạm nếu nó cung cấp phản hồi ở mức độ phù hợp với khả năng hiện tại, không quá thấp và không quá cao.
2.2. Học nghề Nhận thức (Cognitive Apprenticeship)
Cognitive Apprenticeship là mô hình sư phạm trong đó chuyên gia làm mẫu các quá trình nhận thức (modeling), hướng dẫn thực hành (coaching), và dần dần rút lui (fading). Trong mô hình can thiệp đề xuất, ChatGPT đóng vai trò “người thầy làm mẫu” ở giai đoạn đầu – đưa ra phản biện mẫu – và dần chuyển sang vai trò “người phản biện” khi sinh viên đã nội hóa tiêu chí. Oppenheimer và cộng sự (2025) đã chứng minh sinh viên có thể phản bác các tuyên bố của LLM trong 87,8% phản hồi, cho thấy họ đóng vai trò người tiêu dùng phản biện thay vì chấp nhận thụ động.
2.3. Phản hồi Quá trình (Formative Feedback)
Nicol và Macfarlane-Dick (2006) xác lập bảy nguyên tắc của phản hồi tốt. Phản hồi từ ChatGPT có thể đáp ứng một số nguyên tắc – đặc biệt là cung cấp thông tin chất lượng cao về nội dung và tổ chức – nhưng thiếu đối thoại có trách nhiệm giải trình và căn chỉnh với mục tiêu khóa học. Do đó, mô hình can thiệp đề xuất kết hợp phản hồi từ ChatGPT với phản hồi từ giảng viên. Mayer (2021) bổ sung yêu cầu thiết kế giao diện AI theo nguyên tắc học tập đa phương tiện để giảm tải nhận thức ngoại lai.
2.4. Mô hình Human–AI Co-creation
Mô hình Human–AI Co-creation phân định vai trò: con người xác định mục tiêu, đánh giá, và chịu trách nhiệm; AI tạo lựa chọn, đề xuất, và phác thảo. Can thiệp phải đảm bảo sinh viên không ủy thác các thao tác nhận thức cốt lõi cho AI, và đặt sinh viên vào vị trí chủ động đánh giá, chọn lọc, và tích hợp phản hồi.
3. TỔNG QUAN NGHIÊN CỨU (LITERATURE REVIEW)
3.1. LLM như Đối tác Học tập Hợp tác trong Viết Lập luận
Oppenheimer, Cash và Connell Pensky (2025) đã kiểm định can thiệp với 154 sinh viên đại học. Kết quả cho thấy cải thiện đáng kể trên ba chiều: chất lượng lập luận (2,58→2,90, *t*(109)=6,22, *p*<,001), kỹ năng prompt (2,34→2,89, *t*(109)=8,80, *p*<,001), và chất lượng phản hồi đối với phê bình (2,41→2,88, *t*(109)=5,44, *p*<,001). ▸ [IC-02] Phân tích định tính: phản tư trong 92,7% phản hồi, phản bác LLM trong 87,8%, chấp nhận phản hồi trong 93,6% (κs=0,81–0,89). Hạn chế: thiếu nhóm đối chứng; bối cảnh Hoa Kỳ, sinh viên bản ngữ. ▸ [EE-02]
3.2. Perceptions của Sinh viên EFL tại Việt Nam
Meniado và cộng sự (2024) khảo sát 357 sinh viên EFL tại Thái Lan và Việt Nam. Sinh viên đánh giá cao ChatGPT ở giai đoạn trước khi viết (4,17 và 4,06 trên thang 5), nhưng điểm thấp hơn ở giai đoạn sau khi viết. Hạn chế: chỉ dừng ở perceptions, chưa đo tác động thực nghiệm. ▸ [EE-06]
3.3. Can thiệp Hành động tại Việt Nam: Lam và Nam (2025)
▸ [EV-01] Lam và Nam (2025) đã tiến hành nghiên cứu hành động 15 tuần tại Học viện Phòng không – Không quân Việt Nam với 32 học viên quân sự Lào học tiếng Việt như ngoại ngữ (VFL). ChatGPT được tích hợp có chiến lược ở các giai đoạn: khơi gợi ý tưởng, phân tích văn bản mẫu, lập dàn ý, và chỉnh sửa – đồng thời loại trừ AI ở giai đoạn viết nháp ban đầu để bảo vệ tính chính chủ và giọng văn cá nhân . Kết quả định lượng từ ba bài kiểm tra viết cho thấy cải thiện có ý nghĩa thống kê về cấu trúc lập luận, mạch lạc, ngữ pháp, và vốn từ vựng (p < 0,001). Dữ liệu định tính từ nhật ký học tập và quan sát giáo viên cho thấy chuyển biến từ lệ thuộc AI sang sử dụng có chọn lọc, phản biện, và có ý thức thể loại; học viên dần hình thành “prompt literacy” và năng lực tự chỉnh sửa . Hạn chế: thiết kế action research không có nhóm đối chứng; đối tượng là học viên quân sự Lào học VFL, không phải sinh viên đại học Việt Nam; chưa xác lập khung “critical AI literacy” hệ thống.
Hàm ý cho nghiên cứu hiện tại: Lam và Nam (2025) cung cấp bằng chứng thực nghiệm đầu tiên tại Việt Nam rằng tích hợp ChatGPT có cấu trúc – đặc biệt với “vùng không AI” ở viết nháp – có thể cải thiện kỹ năng viết lập luận. Nghiên cứu hiện tại kế thừa nguyên lý thiết kế này (Bước 1: viết nháp không AI) và bổ sung: (a) nhóm đối chứng; (b) đối tượng sinh viên đại học không chuyên ngoại ngữ; (c) khung critical AI literacy như mục tiêu sư phạm độc lập; (d) đo lường chuyển giao kỹ năng qua bài luận cuối kỳ không AI. ▸ [EV-01]
3.4. Tác động Nhận thức của ChatGPT
Guo và cộng sự (2025) tổng quan hệ thống 65 nghiên cứu: ChatGPT tăng cường tư duy phản biện khi có giàn giáo, gây hại khi không cấu trúc; rủi ro rõ hơn ở người viết mới và sinh viên năng lực AI hạn chế. OECD (2026) cảnh báo về “phân ly kỹ thuật số thứ hai” – sinh viên có hoàn cảnh khó khăn có thể dùng AI như lối tắt. ▸ [RB-CR03] Rào cản văn hóa học tập thụ động tại Việt Nam: sinh viên quen với việc tiếp nhận tri thức một chiều có thể ít có xu hướng phản bác AI hơn, làm giảm hiệu quả của Bước 3 (đánh giá và chọn lọc phản hồi). Đây là yếu tố điều tiết tiềm ẩn cần kiểm định.
4. MÔ HÌNH NGHIÊN CỨU (RESEARCH MODEL)
4.1. Quy trình Can thiệp Bốn bước
Bước 1 – Viết bản nháp không có AI: Sinh viên viết bản nháp đầu tiên mà không sử dụng AI. Bước này đóng vai trò “điểm neo” để đo năng lực độc lập. Lam và Nam (2025) đã sử dụng nguyên lý tương tự (“vùng không AI”) để bảo vệ authorial voice . ▸ [EV-01]
Bước 2 – Nhận phản biện từ ChatGPT: Sinh viên nhập bản nháp với prompt yêu cầu phản biện học thuật có cấu trúc: “Hãy đóng vai một người phản biện học thuật khó tính… Không viết lại bài cho tôi.”
Bước 3 – Đánh giá, chọn lọc, sửa đổi: Sinh viên đánh giá phản hồi nào phù hợp, chọn lọc, và sửa đổi. Đây là bước then chốt để phát triển critical AI literacy.
Bước 4 – Viết bản cuối và giải thích thay đổi: Sinh viên viết bản cuối và giải trình lý do thay đổi, lý do từ chối phản hồi không phù hợp.
4.2. Biến Đo lường
Chất lượng Lập luận: Rubric 4 chiều (luận điểm, bằng chứng, lập luận, phản biện), đánh giá độc lập bởi hai giảng viên.
Mức độ Phụ thuộc AI: Số lần sử dụng ChatGPT (thinking trail), mức độ copy-paste, tỷ lệ thay đổi không có hướng dẫn trực tiếp.
Thái độ với AI: Khảo sát Likert 5 điểm.
4.3. So sánh Tương phản với Các Mô hình Can thiệp Đã có
| Mô hình | Trọng tâm | Điểm mạnh | Điểm hạn chế so với mô hình đề xuất |
| Oppenheimer et al. (2025) | LLM như đối tác phản biện | Bằng chứng sơ bộ về cải thiện ~1 SD trên 3 chiều | Thiếu nhóm đối chứng; bối cảnh Hoa Kỳ |
| Meniado et al. (2024) | Perceptions của sinh viên EFL | Dữ liệu perceptions từ Việt Nam | Chỉ dừng ở perceptions |
| Lam & Nam (2025) | Tích hợp ChatGPT có chiến lược vào viết luận VFL | Can thiệp hành động 15 tuần tại Việt Nam; “vùng không AI” ở viết nháp; cải thiện p<0,001 | Thiếu nhóm đối chứng; đối tượng là học viên quân sự Lào; chưa có khung critical AI literacy hệ thống ▸ [EV-01] |
| Mô hình đề xuất | Bốn bước + ba biến đo + ba giả thuyết | Kế thừa “vùng không AI” của Lam & Nam; bổ sung nhóm đối chứng, đối tượng sinh viên VN, khung critical AI literacy, đo chuyển giao kỹ năng | Cần kiểm định thực nghiệm |
4.4. Ba Giả thuyết Nghiên cứu
H1: Nhóm thực nghiệm đạt điểm chất lượng lập luận cao hơn có ý nghĩa thống kê so với nhóm đối chứng (cùng rubric). Cơ sở: Oppenheimer et al. (2025); Lam & Nam (2025). ▸ [IC-06, EV-01]
H2: Sinh viên nhóm thực nghiệm có khả năng huy động thao tác phản biện khi AI vắng mặt cao hơn nhóm đối chứng. Cơ sở: mô hình Bước 3 phát triển critical AI literacy; Lam & Nam (2025) ghi nhận chuyển biến từ lệ thuộc sang có chọn lọc. ▸ [EV-01]
H3: Hiệu quả can thiệp mạnh hơn ở sinh viên có năng lực AI thấp hơn. Cơ sở: Guo et al. (2025); OECD (2026). ▸ [IC-03]
5. PHƯƠNG PHÁP NGHIÊN CỨU (RESEARCH METHODOLOGY)
▸ [IC-08] Lưu ý định vị: Phần này mô tả thiết kế thực nghiệm được đề xuất cho kiểm định tương lai.
5.1. Thiết kế
Thiết kế thực nghiệm đối chứng với hai nhóm: nhóm đối chứng (phản hồi từ giảng viên theo cùng rubric 4 chiều) và nhóm thực nghiệm (phản hồi từ ChatGPT + giảng viên theo cùng rubric 4 chiều). Can thiệp 10 tuần, ba bài luận. Nhóm thực nghiệm tuân theo quy trình bốn bước; nhóm đối chứng theo quy trình hai bước (viết nháp → phản hồi giảng viên → sửa). Đối xứng hóa rubric đảm bảo biến độc lập là nguồn phản hồi, không phải chất lượng rubric. ▸ [IC-06]
Đạo đức: Phê duyệt bởi hội đồng đạo đức; informed consent; mã hóa dữ liệu; kiểm soát Hawthorne.
5.2. Mẫu
100 sinh viên năm hai tại một trường đại học Việt Nam, phân bổ ngẫu nhiên vào hai nhóm (50 mỗi nhóm). Tiêu chí: đã hoàn thành ít nhất một khóa học viết học thuật; có kinh nghiệm ChatGPT cơ bản. Loại trừ sinh viên đã dùng ChatGPT như critique partner.
Đo năng lực AI đầu vào: Thang tự đánh giá 10 mục (Likert 5) + bài kiểm tra prompt ngắn (02 tình huống, 0–4). Điểm tổng hợp dùng phân nhóm thấp/cao (phân vị 50) cho H3. ▸ [IC-03]
Xử lý dữ liệu thiếu: ITT (intention-to-treat); multiple imputation (5 lần lặp); per-protocol như phân tích độ nhạy. ▸ [RB-2]
5.3. Can thiệp
10 tuần, ba bài luận lập luận (tuần 1–3, 4–6, 7–10). Chủ đề liên ngành không có câu trả lời duy nhất. Prompt mẫu tại Phụ lục A. Nhóm đối chứng nhận phản hồi từ giảng viên theo cùng rubric (Phụ lục B) và cùng lịch trình. ▸ [IC-06]
5.4. Đo lường
Trước và sau: Bài luận đánh giá bởi hai giảng viên theo rubric 4 chiều. Inter-rater reliability: Cohen’s kappa, ngưỡng κ ≥ 0,70; nếu thấp hơn, thảo luận và chấm lại 20% bài. ▸ [RB-2]
Quá trình: Thinking trail; change rationale.
Năng lực AI đầu vào: Như Mục 5.2. ▸ [IC-03]
Định tính: Phỏng vấn bán cấu trúc 20 sinh viên (10 mỗi nhóm).
5.5. Phân tích
Định lượng: ANCOVA (covariate: điểm bài luận đầu tiên) cho H1; phân tích đa nhóm theo năng lực AI cho H3; so sánh bài cuối kỳ không AI cho H2. Tất cả theo ITT. ▸ [IC-03, RB-2]
Định tính: Thematic analysis thinking trail, change rationale, phỏng vấn.
6. KẾT QUẢ DỰ KIẾN (ANTICIPATED RESULTS)
▸ [IC-01] Lưu ý: Toàn bộ Mục 6 trình bày kết quả dự kiến suy luận từ khung lý thuyết và bằng chứng y văn, không phải kết quả thực nghiệm đã quan sát.
6.1. Hiệu quả lên Chất lượng Lập luận
Dựa trên bằng chứng sơ bộ từ Oppenheimer et al. (2025) và can thiệp hành động của Lam & Nam (2025) với cải thiện p<0,001 về cấu trúc lập luận, dự kiến nhóm thực nghiệm đạt điểm cao hơn nhóm đối chứng ở các chiều “lập luận” và “phản biện”, với effect size ước tính suy luận 0,3–0,5 – thấp hơn mức cải thiện pre-post do kỳ vọng giảm khi có nhóm đối chứng. ▸ [EE-04, EV-01]
6.2. Phát triển Kỹ năng Độc lập
Dự kiến sinh viên nhóm thực nghiệm có khả năng huy động thao tác phản biện khi AI vắng mặt cao hơn nhóm đối chứng. Cơ sở: Bước 3 phát triển critical AI literacy; Lam & Nam (2025) ghi nhận chuyển biến từ lệ thuộc sang có chọn lọc. ▸ [IC-01, EV-01]
6.3. Nguy cơ Phụ thuộc AI
Dự kiến 20–30% sinh viên nhóm thực nghiệm (ước tính suy luận, cần kiểm chứng) có thể phát triển phụ thuộc, đặc biệt ở chiều “luận điểm” và “bằng chứng”. Cơ sở: Guo et al. (2025); OECD (2026). ▸ [IC-07]
6.4. Mô hình Human–AI Co-creation
Dự kiến mô hình khả thi và hiệu quả, phù hợp với phát hiện của Oppenheimer et al. (2025) về critical consumer (87,8% phản bác) và Lam & Nam (2025) về chuyển biến sang sử dụng có chọn lọc. ▸ [IC-01, EV-01]
7. THẢO LUẬN (DISCUSSION)
7.1. So sánh với Nghiên cứu Quốc tế và Trong nước
Mô hình đề xuất kế thừa và mở rộng Oppenheimer et al. (2025) bằng cách bổ sung nhóm đối chứng và bước “viết nháp không AI”. So với Meniado et al. (2024), mô hình không chỉ khảo sát perceptions mà còn thiết kế can thiệp có cấu trúc. ▸ [IC-06]
▸ [EV-01] So với Lam và Nam (2025): Đây là nghiên cứu tiên phong tại Việt Nam về tích hợp ChatGPT có chiến lược vào viết luận nghị luận, với “vùng không AI” ở viết nháp – nguyên lý mà mô hình đề xuất kế thừa ở Bước 1. Tuy nhiên, Lam và Nam thiếu nhóm đối chứng, đối tượng là học viên quân sự Lào học VFL, và chưa xác lập khung critical AI literacy hệ thống. Nghiên cứu hiện tại bổ sung ba yếu tố này. Đây là đóng góp chính của bài viết: không phải “nghiên cứu đầu tiên tại Việt Nam”, mà là “nghiên cứu đầu tiên tại Việt Nam có thiết kế đối chứng và khung năng lực cho sinh viên đại học không chuyên ngoại ngữ”.
▸ [EE-03] Khác biệt bối cảnh: Oppenheimer (Hoa Kỳ, bản ngữ) và Lam & Nam (học viên quân sự Lào, VFL) khác với mô hình đề xuất (sinh viên Việt Nam, EFL/tiếng Việt học thuật). Hiệu quả can thiệp không thể giả định chuyển giao tuyến tính; cần kiểm định độc lập.
▸ [RB-CR03] Rào cản văn hóa học tập thụ động: Văn hóa học tập thụ động tại Việt Nam có thể là yếu tố điều tiết bổ sung cho H3: sinh viên quen tiếp nhận một chiều có thể ít phản bác AI hơn, làm giảm hiệu quả Bước 3. Nếu H3 được xác nhận, một phần cơ chế có thể là nhóm năng lực AI thấp ít thói quen phản biện hơn – và do đó hưởng lợi nhiều hơn từ giàn giáo cấu trúc.
7.2. Vai trò của Prompt Engineering
Prompt được thiết kế để ChatGPT đóng vai critic – không viết lại bài, chỉ ra lỗ hổng lập luận. Oppenheimer et al. (2025) xác định prompt engineering là một trong ba chiều đo lường chính (2,34→2,89, *t*(109)=8,80, *p*<,001). Lam & Nam (2025) cũng ghi nhận học viên dần hình thành “prompt literacy” . Can thiệp cần bao gồm đào tạo prompt engineering.
7.3. Hàm ý: Hiểu biết AI Phản biện (Critical AI Literacy)
Kết quả dự kiến có hàm ý: cần dạy sinh viên “hiểu biết AI phản biện” – năng lực đánh giá, chọn lọc, và tích hợp phản hồi AI có phán đoán. Năng lực này gồm: (1) hiểu điểm mạnh/hạn chế của phản hồi AI; (2) đánh giá theo tiêu chí học thuật; (3) chọn lọc phù hợp mục tiêu; (4) giải thích lý do chấp nhận/từ chối. OECD (2026) nhấn mạnh tầm quan trọng của tư duy phản biện trong kỷ nguyên AI. Lam & Nam (2025) đã chạm đến “prompt literacy” và “metacognitive coaching” nhưng chưa hệ thống hóa thành khung 4 năng lực. ▸ [EV-01, IC-04]
8. KẾT LUẬN (CONCLUSION)
Nghiên cứu này đề xuất mô hình can thiệp bốn bước sử dụng ChatGPT như critique partner trong viết lập luận học thuật, dựa trên ZPD, Cognitive Apprenticeship, và Formative Feedback. Mô hình nhấn mạnh ChatGPT chỉ có giá trị sư phạm khi hoạt động như công cụ kích thích phán đoán phản biện.
Đóng góp lý thuyết là tích hợp ZPD và Cognitive Apprenticeship với bằng chứng từ Oppenheimer et al. (2025), Meniado et al. (2024), Guo et al. (2025), và Lam và Nam (2025) – nghiên cứu tiên phong tại Việt Nam với “vùng không AI” ở viết nháp. ▸ [EV-01] Đóng góp lý thuyết thứ hai là xác lập khung critical AI literacy (4 năng lực) như mục tiêu sư phạm độc lập. ▸ [IC-05] Đóng góp thực tiễn là cung cấp quy trình bốn bước có thể được giảng viên sử dụng, bổ sung thiết kế đối chứng mà Lam và Nam (2025) chưa có.
Ba giả thuyết được đề xuất để kiểm định: (H1) nhóm thực nghiệm đạt điểm cao hơn; (H2) kỹ năng độc lập cao hơn; (H3) hiệu quả mạnh hơn ở sinh viên năng lực AI thấp. Các giả thuyết cần được kiểm chứng qua thực nghiệm tại một trường đại học Việt Nam.
Hướng nghiên cứu tương lai: mở rộng cho các kỹ năng viết khác; phát triển chỉ số đo critical AI literacy độc lập với tự đánh giá; nghiên cứu sự phát triển chuyên môn của giảng viên. Câu hỏi xuyên suốt: làm thế nào để AI trở thành công cụ kích thích phán đoán, không phải vật thay thế phán đoán của con người.
TUYÊN BỐ ĐÓNG GÓP CỦA TÁC GIẢ (CRediT AUTHORSHIP STATEMENT)
Nguyễn Văn Hùng: Ý tưởng nghiên cứu (Conceptualization); Phương pháp luận và cơ sở lý thuyết (Methodology & Theoretical Development); Xây dựng mô hình và giả thuyết (Framework Architecture & Propositions); Tích hợp bằng chứng (Evidence Integration); Thiết kế thực nghiệm (Experimental Design); Soạn thảo (Writing – Original Draft); Rà soát và chuẩn hóa APA 7 (Writing – Review & Editing); Quản trị dự án (Project Administration).
TUYÊN BỐ XUNG ĐỘT LỢI ÍCH (CONFLICTS OF INTEREST)
Tác giả tuyên bố không có xung đột lợi ích về tài chính hoặc phi tài chính. Nghiên cứu không nhận tài trợ từ tổ chức có lợi ích thương mại trong các sản phẩm AI được thảo luận. ▸ [APA-13]
TUYÊN BỐ SỬ DỤNG AI (AI USAGE STATEMENT)
Trong quá trình chuẩn bị bản thảo, tác giả đã sử dụng ChatGPT cho: (1) rà soát tính nhất quán nội tại; (2) đối chiếu chéo thông tin thư mục; (3) hỗ trợ hiệu đính ngôn ngữ và chuẩn hóa APA 7. Không có nội dung học thuật cốt lõi nào – ý tưởng, khung lý thuyết, mô hình, giả thuyết, thiết kế – được tạo bởi AI. Tác giả chịu trách nhiệm hoàn toàn về nội dung. ▸ [APA-14]
DANH MỤC TÀI LIỆU THAM KHẢO (REFERENCES – APA 7TH EDITION)
Ambrose, S. A., Bridges, M. W., DiPietro, M., Lovett, M. C., & Norman, M. K. (2010). How learning works: Seven research-based principles for smart teaching. Jossey-Bass.
Biggs, J. (1996). Enhancing teaching through constructive alignment. Higher Education, 32(3), 347–364. https://doi.org/10.1007/BF00138871
Boud, D., & Falchikov, N. (Eds.). (2007). Rethinking assessment in higher education. Routledge.
Bransford, J. D., Brown, A. L., & Cocking, R. R. (Eds.). (2000). How people learn. National Academies Press.
Cambridge University Press. (2025). Artificial intelligence in schools. Cambridge University Press.
CAST. (2024). Universal design for learning guidelines version 3.0. CAST.
Chi, M. T. H., & Wylie, R. (2014). The ICAP framework. Educational Psychologist, 49(4), 219–243. https://doi.org/10.1080/00461520.2014.965823
Dunlosky, J., Rawson, K. A., Marsh, E. J., Nathan, M. J., & Willingham, D. T. (2013). Improving students’ learning with effective learning techniques. Psychological Science in the Public Interest, 14(1), 4–58. https://doi.org/10.1177/1529100612453266
Facione, P. A. (1990). Critical thinking: A statement of expert consensus (The Delphi Report). The California Academic Press.
Guo, Y., Huang, L., Zhang, C., Li, Q., & Chen, M. (2025). ChatGPT in education: A systematic review. Thinking Skills and Creativity, 60, Article 102106. https://doi.org/10.1016/j.tsc.2025.102106 ▸ [EE-01]
Harvard Bok Center. (2024). Generative AI in teaching and learning guidance. Harvard University. ▸ [APA-11]
Kirschner, P. A., Sweller, J., & Clark, R. E. (2006). Why minimal guidance during instruction does not work. Educational Psychologist, 41(2), 75–86. https://doi.org/10.1207/s15326985ep4102_1
Kuhn, D. (1999). A developmental model of critical thinking. Educational Researcher, 28(2), 16–46. https://doi.org/10.3102/0013189X028002016
Lam, T. H., & Nam, N. P. (2025). Tích hợp chiến lược ChatGPT trong giảng dạy viết luận nghị luận tiếng Việt cho học viên nước ngoài tại Học viện Phòng không – Không quân Việt Nam [Strategic integration of ChatGPT in teaching Vietnamese argumentative writing to foreign cadets]. Tạp chí Khoa học Trường Đại học Tân Trào, 11(2). https://doi.org/10.51453/3093-3706/2025/1340 ▸ [EV-01]
Mayer, R. E. (2021). Multimedia learning (3rd ed.). Cambridge University Press.
Meniado, J. C., Huyen, D. T. T., Panyadilokpong, N., & Lertkomolwit, P. (2024). Using ChatGPT for second language writing. Computers and Education: Artificial Intelligence, 7, Article 100313. https://doi.org/10.1016/j.caeai.2024.100313
Mishra, P., & Koehler, M. J. (2006). Technological pedagogical content knowledge. Teachers College Record, 108(6), 1017–1054. https://doi.org/10.1111/j.1467-9620.2006.00684.x
Nicol, D. J., & Macfarlane-Dick, D. (2006). Formative assessment and self-regulated learning. Studies in Higher Education, 31(2), 199–218. https://doi.org/10.1080/03075070600572090
OECD. (2026). OECD digital education outlook 2026. OECD Publishing. https://doi.org/10.1787/062a7394-en
Oppenheimer, D. M., Cash, T. N., & Connell Pensky, A. E. (2025). You’ve got AI friend in me: LLMs as collaborative learning partners. International Journal of Artificial Intelligence in Education, 35(6), 3896–3921. https://doi.org/10.1007/s40593-025-00521-6
Papert, S. (1980). Mindstorms. Basic Books.
Pintrich, P. R. (2000). The role of goal orientation in self-regulated learning. In M. Boekaerts et al. (Eds.), Handbook of self-regulation (pp. 451–502). Academic Press. https://doi.org/10.1016/B978-012109890-2/50043-3
Risko, E. F., & Gilbert, S. J. (2016). Cognitive offloading. Trends in Cognitive Sciences, 20(9), 676–688. https://doi.org/10.1016/j.tics.2016.07.002
Stanford HAI. (2025). AI Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence.
Sweller, J., Ayres, P., & Kalyuga, S. (2011). Cognitive load theory. Springer. https://doi.org/10.1007/978-1-4419-8126-4
UNESCO. (2023). Guidance for generative AI in education and research. UNESCO.
University of Oxford. (2024). Policy and guidance on the use of AI in education. Oxford University. ▸ [APA-11]
Vygotsky, L. S. (1978). Mind in society. Harvard University Press.
Wiggins, G., & McTighe, J. (2005). Understanding by design (2nd ed.). ASCD.
Zimmerman, B. J. (2002). Becoming a self-regulated learner. Theory Into Practice, 41(2), 64–70. https://doi.org/10.1207/s15430421tip4102_2
PHỤ LỤC (APPENDIX)
Phụ lục A: Prompt Mẫu cho ChatGPT như Critique Partner
Prompt cơ bản: “Hãy đóng vai một người phản biện học thuật khó tính. Đọc bài luận sau và chỉ ra: (1) luận điểm chính có rõ ràng không; (2) bằng chứng nào còn thiếu hoặc yếu; (3) lập luận nào có lỗ hổng logic; (4) quan điểm đối lập nào chưa được xem xét. Không viết lại bài cho tôi.”
Prompt nâng cao: “Hãy đánh giá cấu trúc lập luận theo ba tiêu chí: (1) tính nhất quán giữa luận điểm và bằng chứng; (2) độ sâu của lập luận; (3) tính thuyết phục của kết luận. Đưa ra nhận xét cụ thể, không viết lại bài.”
Phụ lục B: Rubric Đánh giá Bài luận Lập luận
| Tiêu chí | Mức 1 | Mức 2 | Mức 3 | Mức 4 |
| Luận điểm | Không có | Mơ hồ | Rõ nhưng chưa cụ thể | Rõ, cụ thể, tranh luận được |
| Bằng chứng | Không có/không liên quan | Yếu, thiếu trích dẫn | Phù hợp, có trích dẫn | Đa dạng, đáng tin, trích dẫn đúng |
| Lập luận | Chỉ liệt kê | Đơn giản, thiếu kết nối | Logic, có kết nối | Sâu sắc, đa chiều |
| Phản biện | Không đề cập | Đề cập nhưng không phản bác | Phản bác cơ bản | Phản bác và tích hợp thuyết phục |
Phụ lục C: Mẫu Thinking Trail
| Thời gian | Hành động | Nội dung tóm tắt | Ghi chú |
| [timestamp] | Prompt | [nội dung prompt] | |
| [timestamp] | Phản hồi AI | [tóm tắt] | |
| [timestamp] | Đánh giá | [đồng ý/không, lý do] | |
| [timestamp] | Sửa đổi | [mô tả] | |
| [timestamp] | Từ chối | [lý do] |
Phụ lục D: Công cụ Đo Năng lực AI Đầu vào
D.1. Thang tự đánh giá (10 mục, Likert 5): (1) hiểu giới hạn ChatGPT; (2) biết viết prompt hữu ích; (3) đánh giá phản hồi AI; (4) phân biệt “viết thay” vs “phản biện”; (5) biết từ chối phản hồi; (6) dùng AI kiểm tra lập luận; (7) hiểu cognitive offloading; (8) giải thích lý do chấp nhận/từ chối; (9) kiểm chứng thông tin AI; (10) nhận thức trách nhiệm.
D.2. Bài kiểm tra prompt (0–4): Tình huống 1: viết prompt yêu cầu phản biện (chấm: vai trò, nhiệm vụ, ràng buộc, tiêu chí). Tình huống 2: đánh giá phản hồi AI có lỗi (chấm: nhận diện, giải thích, kiểm chứng, quyết định).
D.3. Tổng hợp: Điểm chuẩn hóa trung bình D.1 (chia 5) và D.2 (chia 4); phân nhóm theo phân vị 50.
D.4. Rubric chấm Prompt (Tình huống 1): 0 = không có; 1 = mơ hồ; 2 = rõ nhưng thiếu bối cảnh; 3 = rõ và có bối cảnh; 4 = rõ, cụ thể, định hướng phản biện.
