
ASSESSING THE PEDAGOGICAL QUALITY OF AI-GENERATED MULTIMODAL LEARNING MATERIALS IN ONLINE TEACHING
Nguyễn Văn Hùng
HIGHLIGHTS
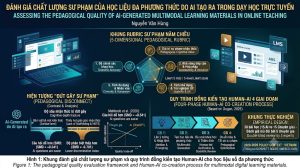
- Xác lập Khung Rubric Sư phạm Năm chiều (5-Dimensional Pedagogical Rubric): Tích hợp năm chiều đánh giá (độ chính xác khoa học, giá trị sư phạm-nhận thức, khả năng tiếp cận-hòa nhập, tính khả dụng-UX, tính đa dạng-nhân văn) với thang Likert 5 mức, cung cấp công cụ chẩn đoán khả vận hành cho học liệu đa phương thức do AI tạo ra trong bối cảnh giáo dục đại học Việt Nam 2020–2026.
- Luận giải cơ chế “Đứt gãy Sư phạm” (Pedagogical Disconnect): Đối chiếu với bằng chứng thực nghiệm cho thấy AI có xu hướng bám sát bề mặt kiến thức trong khi thiếu hụt cấu trúc giàn giáo nhận thức (scaffolding) và các hoạt động kích thích tư duy bậc cao (HOTS). Phân tích tổng hợp của Mehboob et al. (2026) xác nhận: câu hỏi do AI tạo ra dễ hơn có ý nghĩa thống kê (SMD = +0,541; 95% CI: 0,17–0,91; p = 0,004) và có chỉ số phân biệt thấp hơn (SMD = −0,701; 95% CI: −1,33 đến −0,08; p = 0,028) . Đây là bằng chứng định lượng trực tiếp cho “đứt gãy chiều sâu nhận thức” mà rubric năm chiều muốn chẩn đoán.
- Tích hợp bằng chứng về chất lượng học liệu AI so với chuyên gia: Kết nối phát hiện từ nghiên cứu so sánh MCQ giải phẫu lâm sàng do LLM và chuyên gia tạo ra cho thấy sinh viên đánh giá ba nguồn MCQ là “tương đương” trong 40,7% trường hợp, với ChatGPT được ưu tiên cao nhất ở các tiêu chí liên quan đến chất lượng distractor và nhận diện lỗ hổng kiến thức. Tuy nhiên, phân tích tổng hợp độc lập cho thấy bức tranh phức tạp hơn: AI dễ tiếp cận hơn nhưng kém phân biệt hơn . Điều này củng cố lập luận rằng đánh giá sư phạm không thể chỉ dựa trên “cảm nhận tương đương” mà cần rubric chẩn đoán chiều sâu.
- Bối cảnh hóa thực tiễn Việt Nam 2020–2026: Đối chiếu với yêu cầu của UNESCO (2023) về giáo dục lấy con người làm trung tâm và Thông tư 02/2025/TT-BGDĐT về khung năng lực số với miền thứ sáu “Ứng dụng trí tuệ nhân tạo” , nhận diện khoảng cách giữa năng lực công nghệ của AI và năng lực thẩm định sư phạm của giảng viên.
- Đề xuất quy trình Đồng kiến tạo Human–AI bốn giai đoạn (Four-Phase Human–AI Co-creation): Mở rộng mô hình ba bước của Dogan (2025) bằng cách tách giai đoạn “Human-led Verification” thành hai bước (rà soát khoa học và chuẩn hóa sư phạm), phản ánh yêu cầu đặc thù của học liệu đa phương thức. ▸ [IC-03]
- Thiết kế thực nghiệm so sánh có kiểm soát: 30 đơn vị bài học (15 do AI tạo, 15 do chuyên gia thiết kế) thuộc ba lĩnh vực, đánh giá mù đôi bởi 5 chuyên gia, kết hợp kiểm định Mann-Whitney U và phân tích định tính chủ đề.
TÓM TẮT BÀI BÁO (STRUCTURED ABSTRACT)
Tóm tắt tiếng Việt
Bối cảnh (Background): Sự bùng nổ của trí tuệ nhân tạo tạo sinh (Generative AI) và AI đa phương thức (Multimodal AI) mở ra kỷ nguyên tự động hóa sản xuất học liệu (văn bản, đồ họa, âm thanh, video tương tác). Mặc dù tốc độ và năng suất gia tăng đột biến, tính chuẩn xác khoa học và giá trị sư phạm cốt lõi vẫn là bài toán bỏ ngỏ. Nghiên cứu về các mô hình đồng kiến tạo Human–AI trong thiết kế giảng dạy cho thấy AI có thể hỗ trợ tạo mục tiêu chuyển giao, nhiệm vụ thực hiện và trải nghiệm học tập xác thực, nhưng đồng thời nhấn mạnh nhu cầu về kiến thức AI nền tảng và kỹ năng lập kế hoạch giảng dạy của con người.
Vấn đề nghiên cứu (Research Problem): AI dễ gặp hiện tượng “ảo giác” (hallucination), thiếu tính ngữ cảnh sư phạm và hiếm khi tích hợp tự nhiên các mức tư duy bậc cao (HOTS theo thang Bloom). Bằng chứng từ phân tích tổng hợp cho thấy câu hỏi do AI tạo ra dễ hơn và kém phân biệt hơn so với câu hỏi do con người tạo — một dấu hiệu của “đứt gãy sư phạm” có hệ thống. Khoảng trống cốt lõi là thiếu một bộ rubric chuẩn hóa đánh giá chất lượng sư phạm học thuật dành cho tài nguyên học tập số do AI tạo ra trong bối cảnh giáo dục đại học Việt Nam.
Mục tiêu (Purpose): (1) Thiết lập khung tiêu chí đánh giá chất lượng sư phạm đối với học liệu đa phương thức do AI tạo ra; (2) so sánh đối chuẩn với học liệu do chuyên gia thiết kế; (3) đề xuất quy trình đồng kiến tạo Human–AI nhằm tối ưu hóa chất lượng học liệu số.
Phương pháp tiếp cận (Approach): Tổng hợp lý thuyết tích hợp, kết nối Thuyết Học tập Đa phương tiện của Mayer (2021), Thuyết Tải nhận thức của Sweller và cộng sự (2019), các mô hình thiết kế sư phạm tích hợp (ADDIE, UbD, 5E), và mô hình Human–AI Co-creation với bằng chứng thực nghiệm từ các nghiên cứu so sánh học liệu AI và chuyên gia. Thiết kế thực nghiệm so sánh có kiểm soát với 30 đơn vị bài học và 5 chuyên gia thẩm định mù đôi được đề xuất.
Kết quả lý thuyết (Theoretical Results): Thiết lập Khung Rubric Sư phạm Năm chiều, xác lập ba giả thuyết (H1–H3) về khoảng cách chất lượng sư phạm giữa học liệu AI và chuyên gia, các chiều cạnh bộc lộ hạn chế lớn nhất, và hiệu quả của quy trình đồng kiến tạo Human–AI.
Đóng góp (Contribution): Cung cấp khung đánh giá khả vận hành và quy trình đồng kiến tạo Human–AI, chuyển dịch từ thẩm định kỹ thuật thuần túy sang thẩm định sư phạm tích hợp, đồng thời xác lập “năng lực đánh giá sư phạm đối với sản phẩm AI” như một mục tiêu đào tạo giảng viên.
Bối cảnh ứng dụng (Context): Giáo dục đại học Việt Nam giai đoạn 2020–2026, với các yêu cầu của Thông tư 02/2025/TT-BGDĐT về khung năng lực số và định hướng của UNESCO (2023) về giáo dục lấy con người làm trung tâm.
Keywords / Từ khóa: Generative AI; multimodal learning materials; pedagogical quality; rubric assessment; Human–AI Co-creation; cognitive load; Vietnamese higher education.
Structured English Abstract
Background: The proliferation of generative AI and multimodal AI opens an era of automated production of learning materials (text, graphics, audio, interactive video). While speed and productivity increase dramatically, scientific accuracy and core pedagogical value remain unresolved. Research on Human–AI co-design models in instructional planning demonstrates that AI can support the creation of transfer goals, performance tasks, and authentic learning experiences, while simultaneously emphasizing the need for foundational AI knowledge and instructional planning skills on the human side.
Research Problem: AI is prone to hallucination, lacks pedagogical contextualization, and rarely integrates higher-order thinking skills (HOTS) naturally. Evidence from meta-analysis indicates that AI-generated questions tend to be easier and less discriminating than human-authored items — a systematic signal of “pedagogical disconnect.” The core gap is the absence of a standardized pedagogical quality rubric for AI-generated digital learning resources in Vietnamese higher education.
Purpose: (1) To establish a pedagogical quality assessment framework for AI-generated multimodal materials; (2) to benchmark against expert-designed materials; (3) to propose a Human–AI co-creation process for optimizing digital learning material quality.
Approach: Integrative theoretical synthesis connecting Mayer’s (2021) Cognitive Theory of Multimedia Learning, Sweller et al.’s (2019) Cognitive Load Theory, instructional design models (ADDIE, UbD, 5E), and the Human–AI Co-creation model with empirical evidence from comparative studies of AI and expert materials. A controlled comparative design with 30 lesson units and 5 double-blind expert reviewers is proposed.
Theoretical Results: A 5-Dimensional Pedagogical Rubric is established, with three propositions (H1–H3) on pedagogical quality gaps between AI and expert materials, dimensions exhibiting the greatest limitations, and the effectiveness of the Human–AI co-creation process.
Contribution: An operational assessment framework and Human–AI co-creation process, shifting from purely technical to integrated pedagogical validation, while establishing “AI pedagogical evaluation literacy” as a teacher training objective.
Application Context: Vietnamese higher education during 2020–2026, with the requirements of Circular 02/2025/TT-BGDDT on digital competency frameworks and UNESCO’s (2023) human-centered education orientation.
Keywords: Generative AI; multimodal learning materials; pedagogical quality; rubric assessment; Human–AI Co-creation; cognitive load; Vietnamese higher education.
1. GIỚI THIỆU (INTRODUCTION)
1.1. Bối cảnh (Context)
Sự bùng nổ của trí tuệ nhân tạo tạo sinh (Generative AI) và AI đa phương thức (Multimodal AI) trong giai đoạn 2020–2026 đã mở ra một kỷ nguyên mới trong sản xuất học liệu giáo dục. Các mô hình ngôn ngữ lớn (LLM) và mô hình đa phương thức có khả năng tự động tạo ra văn bản, đồ họa, âm thanh, slide bài giảng, và thậm chí video tương tác với tốc độ và năng suất chưa từng có. Nghiên cứu về đồng kiến tạo Human–AI trong thiết kế giảng dạy cho thấy ChatGPT có thể hỗ trợ tạo mục tiêu chuyển giao, nhiệm vụ thực hiện và trải nghiệm học tập xác thực, với giáo viên báo cáo cải thiện về căn chỉnh, sáng tạo và hiệu quả trong lập kế hoạch bài học.
Tuy nhiên, song hành với tiện ích là những lo ngại ngày càng tăng về chất lượng sư phạm. Bằng chứng từ phân tích tổng hợp quốc tế cho thấy một bức tranh phức tạp: câu hỏi do AI tạo ra có xu hướng dễ hơn có ý nghĩa thống kê so với câu hỏi do con người tạo (SMD = +0,541; p = 0,004), trong khi câu hỏi do con người tạo ra có chỉ số phân biệt cao hơn đáng kể (SMD = −0,701; p = 0,028) . Điều này có nghĩa là AI có thể tạo ra học liệu “dễ tiếp cận” hơn, nhưng đồng thời thiếu khả năng chẩn đoán chính xác mức độ hiểu biết thực sự của người học — một chức năng sư phạm cốt lõi của đánh giá chất lượng cao.
Trong bối cảnh Việt Nam, Thông tư 02/2025/TT-BGDĐT quy định Khung năng lực số cho người học với sáu miền năng lực và 24 năng lực thành phần, trong đó miền thứ sáu là “Ứng dụng trí tuệ nhân tạo,” yêu cầu người học hiểu, sử dụng và đánh giá các công cụ AI một cách có đạo đức và trách nhiệm . UNESCO (2023) trong Guidance for Generative AI in Education and Research nhấn mạnh cách tiếp cận lấy con người làm trung tâm, trong đó con người giữ quyền kiểm soát và trách nhiệm giải trình đối với các quyết định do AI hỗ trợ . Tuy nhiên, chưa có nghiên cứu nào tại Việt Nam thiết lập một khung đánh giá chuẩn hóa để thẩm định chất lượng sư phạm của học liệu đa phương thức do AI tạo ra, cũng như chưa có quy trình đồng kiến tạo Human–AI được kiểm chứng trong bối cảnh giáo dục đại học Việt Nam.
1.2. Vấn đề nghiên cứu (Research Problem)
Y văn về đánh giá học liệu do AI tạo ra đang đối mặt với ba khoảng trống liên quan đến câu hỏi thẩm định sư phạm.
Khoảng trống thứ nhất – thiếu rubric đánh giá sư phạm tích hợp cho học liệu AI. Các công cụ hiện tại chủ yếu thẩm định ở góc độ kỹ thuật thuật toán hoặc tính thẩm mỹ trực quan. Mehboob et al. (2026) đã phân tích tổng hợp chất lượng tâm trắc của MCQ do AI và con người tạo, nhưng chỉ tập trung vào câu hỏi văn bản, chưa mở rộng cho học liệu đa phương thức . Bằng chứng từ phân tích tổng hợp cho thấy khoảng cách giữa AI và con người không nằm ở độ chính xác bề mặt mà ở chiều sâu chẩn đoán (discrimination index) — chính là chiều cạnh mà các rubric kỹ thuật hiện tại bỏ qua. Khoảng trống này khiến giảng viên thiếu công cụ hệ thống để quyết định có nên sử dụng học liệu AI trong giảng dạy hay không.
Khoảng trống thứ hai – thiếu đối chuẩn có kiểm soát giữa học liệu AI và chuyên gia trong bối cảnh đa phương thức. Nghiên cứu của Mehboob et al. (2026) đã thiết kế đối chuẩn có kiểm soát với MCQ được ẩn danh và ngẫu nhiên hóa thứ tự trình bày để giảm thiên lệch . Tuy nhiên, nghiên cứu này chỉ so sánh MCQ (văn bản), chưa đánh giá học liệu đa phương thức (multimodal). Nghiên cứu về Human–AI Hybrid Co-Design đánh giá mô hình qua năm nghiên cứu sơ bộ với hơn 500 người tham gia, nhưng tập trung vào quy trình lập kế hoạch giảng dạy chứ không phải chất lượng sản phẩm học liệu. Cần có thiết kế thực nghiệm so sánh trực tiếp học liệu đa phương thức do AI tạo ra với học liệu do chuyên gia thiết kế theo cùng đề cương, với đánh giá mù đôi để kiểm soát thiên lệch.
Khoảng trống thứ ba – thiếu quy trình đồng kiến tạo Human–AI được kiểm chứng trong bối cảnh Việt Nam. Nghiên cứu về Human–AI Hybrid Co-Design đề xuất mô hình ba bước dựa trên nguyên lý UbD, cho phép giáo viên tinh giản quy trình lập kế hoạch trong khi duy trì tính nghiêm cẩn sư phạm. Tuy nhiên, mô hình này được phát triển cho bối cảnh K-12 và giáo dục đại học nói chung, chưa được kiểm chứng trong bối cảnh giáo dục đại học Việt Nam. Khoảng trống này khiến các trường thiếu hướng dẫn thực hành để tích hợp AI vào quy trình thiết kế học liệu mà không đánh đổi chất lượng sư phạm.
1.3. Mục tiêu và câu hỏi nghiên cứu (Objectives and Research Questions)
Nghiên cứu đặt ba mục tiêu: (1) thiết lập khung tiêu chí đánh giá chất lượng sư phạm đối với học liệu đa phương thức do AI tạo ra; (2) so sánh đối chuẩn với học liệu do chuyên gia thiết kế; (3) đề xuất quy trình đồng kiến tạo Human–AI nhằm tối ưu hóa chất lượng học liệu số.
Câu hỏi nghiên cứu tương ứng: (1) Chất lượng sư phạm và tính chính xác khoa học của học liệu đa phương thức do AI tạo ra có khác biệt có ý nghĩa thống kê so với học liệu do chuyên gia thiết kế hay không? (2) Những chiều cạnh sư phạm nào (tải nhận thức, kích thích tư duy bậc cao, tính tương tác) bộc lộ hạn chế lớn nhất trong học liệu AI? (3) Quy trình đồng kiến tạo Human–AI cần được thiết kế như thế nào để chuẩn hóa và tối ưu chất lượng học liệu số?
1.4. Phạm vi nghiên cứu (Scope)
Phạm vi lý thuyết giới hạn ở đánh giá chất lượng sư phạm của học liệu đa phương thức trong dạy học trực tuyến, dựa trên Thuyết Học tập Đa phương tiện của Mayer (2021), Thuyết Tải nhận thức của Sweller và cộng sự (2019), và mô hình Human–AI Co-creation. Phạm vi thực nghiệm đề xuất giới hạn ở 30 đơn vị bài học trực tuyến đa phương thức thuộc ba lĩnh vực (Khoa học tự nhiên, Khoa học xã hội, STEM ứng dụng), với 5 chuyên gia thẩm định và 100 sinh viên tham gia, trong giai đoạn 2020–2026.
2. CƠ SỞ LÝ THUYẾT TÍCH HỢP (INTEGRATED THEORETICAL FOUNDATIONS)
2.1. Thuyết Học tập Đa phương tiện (Cognitive Theory of Multimedia Learning)
Mayer (2021) xác lập nguyên lý trung tâm của học tập đa phương tiện: người học xử lý thông tin qua hai kênh riêng biệt — thị giác và thính giác — và học tập hiệu quả nhất khi thông tin được trình bày theo cách tối ưu hóa cả hai kênh mà không gây quá tải nhận thức. Nguyên tắc đa phương thức (Multimedia Principle) yêu cầu kết hợp từ ngữ và hình ảnh thay vì chỉ từ ngữ; Nguyên tắc mạch lạc (Coherence Principle) yêu cầu loại bỏ thông tin ngoại lai; Nguyên tắc báo hiệu (Signaling Principle) nhấn mạnh việc sử dụng tín hiệu thị giác để hướng dẫn sự chú ý; Nguyên tắc liền kề không gian (Spatial Contiguity) và thời gian (Temporal Contiguity) yêu cầu đặt từ ngữ và hình ảnh gần nhau về mặt không gian và thời gian; Nguyên tắc phân đoạn (Segmenting) yêu cầu chia nhỏ thông tin phức tạp; Nguyên tắc tiền đào tạo (Pre-training) yêu cầu giới thiệu các khái niệm chính trước khi đi vào chi tiết.
Trong bối cảnh học liệu do AI tạo ra, các nguyên tắc này cung cấp tiêu chuẩn đánh giá quan trọng. PedaCo-Gen (Baek et al., 2026) đã phát triển hệ thống đánh giá 13 mục dựa trên CTML, bao gồm: hình ảnh/video có được kết hợp phù hợp để hỗ trợ hiểu nội dung không (Multimedia); nền gây phân tán và hiệu ứng âm thanh không cần thiết có được loại bỏ không (Coherence); từ khóa và yếu tố thị giác quan trọng có được hướng dẫn rõ ràng qua phụ đề, mũi tên, highlight không (Signaling). Kết quả với 23 chuyên gia cho thấy tất cả 13 mục đều cải thiện có ý nghĩa thống kê (p < 0,05), với effect size lớn (r = 0,88 cho Overall Validity) . Điều này gợi ý rằng rubric đánh giá cần có tiêu chí cụ thể để đo lường mức độ tuân thủ các nguyên tắc học tập đa phương tiện, và rằng AI có thể cải thiện chất lượng khi được hướng dẫn đúng.
2.2. Thuyết Tải nhận thức (Cognitive Load Theory)
Sweller, van Merriënboer và Paas (2019) phân biệt ba loại tải nhận thức: tải ngoại lai (extraneous load) do cách trình bày thông tin gây ra, tải nội tại (intrinsic load) do độ phức tạp của nội dung, và tải hữu ích (germane load) dành cho việc kiến tạo lược đồ tri thức (schemata). Trong học liệu đa phương thức, tải ngoại lai có thể tăng lên nếu giao diện AI tạo ra quá nhiều yếu tố thị giác không cần thiết, hoặc nếu cấu trúc thông tin không rõ ràng.
Nghiên cứu về tương tác với ChatGPT trong giáo dục lập trình cho thấy sinh viên sử dụng ChatGPT báo cáo tải nhận thức thấp hơn và tính khả dụng cao hơn, đồng thời cải thiện khả năng hiểu và giải quyết vấn đề. Tuy nhiên, nghiên cứu cũng cảnh báo rằng việc sử dụng công cụ không đúng cách có thể dẫn đến học tập hời hợt, nhấn mạnh nhu cầu hướng dẫn có cấu trúc. Điều này có hàm ý quan trọng cho thiết kế học liệu AI: học liệu không chỉ cần “đẹp” và “dễ tiếp cận” mà còn phải được thiết kế để duy trì mức độ tải hữu ích phù hợp, không triệt tiêu nỗ lực nhận thức của người học.
2.3. Mô hình Thiết kế Sư phạm Tích hợp (Instructional Design Models)
Ba mô hình thiết kế sư phạm cung cấp khung cho việc đánh giá chất lượng học liệu AI. Thứ nhất, khung ADDIE (Analysis, Design, Development, Implementation, Evaluation) cung cấp chu trình phát triển tài nguyên số từ phân tích nhu cầu đến đánh giá. Thứ hai, mô hình Thiết kế Đảo ngược (Understanding by Design – UbD) của Wiggins và McTighe (2005) yêu cầu học liệu phải bám sát kết quả đầu ra và bằng chứng đánh giá, thay vì bắt đầu từ nội dung. Nghiên cứu về Human–AI Hybrid Co-Design sử dụng chính khung UbD làm nền tảng cho mô hình ba bước, trong đó AI hỗ trợ tạo mục tiêu chuyển giao, nhiệm vụ thực hiện và trải nghiệm học tập xác thực. Thứ ba, tiến trình khám phá 5E (Engage – Explore – Explain – Elaborate – Evaluate) cung cấp cấu trúc cho hoạt động học tập trong môi trường trực tuyến.
Đối với học liệu do AI tạo ra, các mô hình này cung cấp tiêu chuẩn để đánh giá liệu AI có tạo ra học liệu “có cấu trúc sư phạm” hay chỉ là tập hợp nội dung rời rạc. Rubric đề xuất trong nghiên cứu này sẽ tích hợp các nguyên lý này vào chiều “Giá trị Sư phạm & Nhận thức.”
2.4. Mô hình Đồng kiến tạo Human–AI (Human–AI Co-creation)
Mô hình Human–AI Co-creation phân định vai trò giữa con người và AI trong quá trình thiết kế học liệu. Nghiên cứu về Human–AI Hybrid Co-Design đề xuất mô hình ba bước dựa trên UbD: xác định mục tiêu học tập, thiết kế đánh giá, và lập kế hoạch hoạt động học tập, với AI hỗ trợ ở mỗi bước. Kết quả từ năm nghiên cứu sơ bộ với hơn 500 người tham gia cho thấy giáo viên báo cáo cải thiện về căn chỉnh, sáng tạo và hiệu quả trong lập kế hoạch bài học, đồng thời nhấn mạnh tầm quan trọng của phản hồi lặp lại và kiến thức AI nền tảng để tối đa hóa lợi ích của quá trình đồng kiến tạo.
Mô hình này phù hợp với định hướng của UNESCO (2023) về giáo dục lấy con người làm trung tâm, trong đó AI là công cụ hỗ trợ nhưng con người giữ quyền kiểm soát và trách nhiệm giải trình . Do đó, rubric đánh giá cần đo lường không chỉ chất lượng học liệu AI mà còn mức độ hiệu quả của quy trình đồng kiến tạo trong việc nâng cao chất lượng đó.
▸ Mở rộng thành quy trình bốn giai đoạn: Quy trình bốn giai đoạn đề xuất trong nghiên cứu này mở rộng mô hình ba bước của Dogan (2025) bằng cách tách giai đoạn “Human-led Verification” thành hai bước (rà soát khoa học và chuẩn hóa sư phạm), phản ánh yêu cầu đặc thù của học liệu đa phương thức — nơi tính chính xác khoa học và tính nhất quán sư phạm cần được kiểm định riêng biệt trước khi triển khai.
3. TỔNG QUAN NGHIÊN CỨU (LITERATURE REVIEW)
3.1. Thực trạng Ứng dụng GenAI trong Thiết kế Bài giảng Số
Các hệ thống AI hỗ trợ thiết kế bài giảng đang phát triển nhanh chóng. Nghiên cứu về Human–AI Hybrid Co-Design cho thấy ChatGPT có thể hỗ trợ giáo viên tạo mục tiêu chuyển giao, nhiệm vụ thực hiện và trải nghiệm học tập xác thực thông qua quy trình ba bước dựa trên UbD. PedaCo-Gen (Baek et al., 2026) đã phát triển hệ thống đánh giá 13 mục dựa trên các nguyên tắc của Mayer, và chứng minh rằng chất lượng video có thể cải thiện có ý nghĩa thống kê khi có hỗ trợ của AI được thiết kế đúng . Điều này gợi ý rằng AI không chỉ có thể tạo học liệu mà còn có thể được thiết kế để tuân thủ các nguyên tắc sư phạm đã được thiết lập.
3.2. Các Phát hiện Thực nghiệm về Chất lượng Học liệu AI
Bằng chứng từ phân tích tổng hợp quốc tế cung cấp bức tranh định lượng rõ ràng hơn về khoảng cách chất lượng. Mehboob et al. (2026) đã phân tích tổng hợp chất lượng tâm trắc của câu hỏi do AI tạo ra và do con người tạo ra trong giáo dục y khoa, với bốn nghiên cứu đáp ứng tiêu chí và tám kết quả so sánh . Kết quả cho thấy không có sự khác biệt tổng thể có ý nghĩa thống kê giữa hai nguồn (SMD = −0,084; 95% CI: −0,65 đến 0,49; p = 0,773), nhưng độ không đồng nhất rất cao (I² = 92,7%). Khi phân tích riêng từng chiều: câu hỏi do AI tạo ra dễ hơn có ý nghĩa thống kê (SMD = +0,541; 95% CI: 0,17–0,91; p = 0,004; I² = 62,3%), trong khi câu hỏi do con người tạo ra có chỉ số phân biệt cao hơn đáng kể (SMD = −0,701; 95% CI: −1,33 đến −0,08; p = 0,028; I² = 86,2%) .
Hàm ý sư phạm của phát hiện này rất quan trọng: AI tạo ra học liệu dễ tiếp cận hơn (có thể hữu ích cho người học mới), nhưng kém khả năng chẩn đoán mức độ hiểu biết thực sự. Nói cách khác, AI có thể tạo ra câu hỏi mà hầu hết sinh viên trả lời đúng, nhưng không phân biệt được ai thực sự hiểu sâu và ai chỉ đoán đúng. Đây chính là biểu hiện định lượng của “đứt gãy sư phạm” — khoảng cách giữa năng lực tạo nội dung và năng lực thiết kế trải nghiệm học tập có chiều sâu chẩn đoán.
Nghiên cứu về tương tác với ChatGPT trong giáo dục lập trình cho thấy sinh viên sử dụng ChatGPT báo cáo tính khả dụng cao hơn và tải nhận thức thấp hơn, đồng thời cải thiện khả năng hiểu và giải quyết vấn đề. Tuy nhiên, nghiên cứu cũng cảnh báo rằng việc sử dụng công cụ không đúng cách có thể dẫn đến học tập hời hợt, nhấn mạnh nhu cầu hướng dẫn có cấu trúc.
3.3. Khoảng trống Nghiên cứu (Research Gap)
Từ tổng quan trên, ba khoảng trống được xác định. Thứ nhất, chưa có rubric đánh giá sư phạm tích hợp nào được thiết kế riêng cho học liệu đa phương thức do AI tạo ra trong bối cảnh giáo dục đại học Việt Nam, tích hợp các nguyên lý của Mayer (2021), Sweller và cộng sự (2019), và các mô hình thiết kế sư phạm. Thứ hai, chưa có đối chuẩn có kiểm soát giữa học liệu đa phương thức do AI tạo ra và học liệu do chuyên gia thiết kế theo cùng đề cương, với đánh giá mù đôi để kiểm soát thiên lệch trong bối cảnh Việt Nam. Thứ ba, chưa có quy trình đồng kiến tạo Human–AI được kiểm chứng trong bối cảnh giáo dục đại học Việt Nam, mặc dù UNESCO (2023) đã nhấn mạnh tầm quan trọng của cách tiếp cận lấy con người làm trung tâm và các nghiên cứu quốc tế đã đề xuất các mô hình Human–AI co-design.
4. KHUNG ĐÁNH GIÁ VÀ MÔ HÌNH NGHIÊN CỨU (ASSESSMENT FRAMEWORK AND RESEARCH MODEL)
4.1. Khung Rubric Sư phạm Năm chiều (5-Dimensional Pedagogical Rubric)
Khung rubric được xây dựng trên năm chiều, mỗi chiều gắn với một cơ sở lý thuyết và một chỉ báo hành vi cụ thể.
Bảng 1: Khung Rubric Sư phạm Năm chiều
| Chiều | Cơ sở lý thuyết | Chỉ báo hành vi |
| 1. Độ chính xác khoa học & Tin cậy | Không có ảo giác thông tin, chuẩn thuật ngữ chuyên môn, nguồn dẫn khả chứng | Kiểm tra chéo thông tin với nguồn chính thức; đánh giá mức độ chính xác của thuật ngữ; xác minh nguồn dẫn |
| 2. Giá trị Sư phạm & Nhận thức | Mayer (2021); Sweller et al. (2019); ADDIE, UbD, 5E | Cấu trúc bài học rõ ràng; giảm tải ngoại lai; kích hoạt HOTS; định hướng phản tư; giàn giáo nhận thức |
| 3. Khả năng Tiếp cận & Hòa nhập | WCAG; CAST UDL | Tương thích đa thiết bị; alt-text; phụ đề tự động; điều hướng bàn phím |
| 4. Tính Khả dụng & Trải nghiệm Giao diện | UX Design | Bố cục trực quan; nhịp độ truyền tải; tính thẩm mỹ; dễ điều hướng |
| 5. Tính Đa dạng & Nhân văn | UNESCO (2023); Critical Pedagogy | Đa chiều góc nhìn; tránh thiên vị văn hóa/giới tính; tuân thủ liêm chính học thuật |
Mỗi chiều được đánh giá trên thang Likert 5 mức: 1 = Rất kém, 2 = Kém, 3 = Trung bình, 4 = Tốt, 5 = Xuất sắc. Điểm tổng hợp được tính bằng trung bình có trọng số, trong đó chiều 1 và 2 có trọng số cao hơn (hệ số 1,5) do tầm quan trọng của chúng đối với chất lượng sư phạm.
▸Đo lường HOTS: HOTS được đo bằng tần suất câu hỏi ở mức Bloom 4–6 (phân tích, đánh giá, sáng tạo) trên tổng số câu hỏi trong mỗi bài học, chấm bởi 2 chuyên gia độc lập (Cohen’s kappa ≥ 0,70).
4.2. So sánh Tương phản với Các Khung Đã có (Contrastive Comparison with Existing Frameworks)
| Khung | Trọng tâm | Điểm mạnh | Điểm hạn chế so với khung đề xuất |
| Mehboob et al. (2026) — Phân tích tổng hợp MCQ | Chất lượng tâm trắc của MCQ AI vs. con người | Đánh giá mù đôi, ngẫu nhiên hóa, phân tích SMD | Chỉ áp dụng cho MCQ (văn bản), chưa mở rộng cho học liệu đa phương thức |
| Human–AI Hybrid Co-Design (Dogan, 2025) | Căn chỉnh mục tiêu, đánh giá, hoạt động theo UbD | Tích hợp quy trình đồng kiến tạo, kiểm chứng với hơn 500 người tham gia | Tập trung vào quy trình lập kế hoạch, chưa đánh giá chất lượng sản phẩm học liệu |
| PedaCo-Gen (Baek et al., 2026) — CTML 13 mục | Các nguyên tắc học tập đa phương tiện của Mayer | Cụ thể, có kiểm định thống kê (23 chuyên gia) | Tập trung vào video, chưa bao quát toàn bộ học liệu đa phương thức |
| OECD AI Literacy Framework (2026, phiên bản cuối) | Tương tác, sáng tạo, quản lý, định hình AI | Nhấn mạnh siêu nhận thức, phản tư | Thiết kế cho giáo dục phổ thông, chưa mở rộng cho đại học và quản trị chương trình |
| Khung đề xuất | Năm chiều tích hợp: chính xác, sư phạm, tiếp cận, khả dụng, đa dạng | Kết hợp lý thuyết học tập, thiết kế sư phạm, và quản trị; thiết kế cho bối cảnh Việt Nam | Cần kiểm định thực nghiệm |
4.3. Quy trình Đánh giá Thực nghiệm Ba vòng (Three-Round Experimental Evaluation)
Vòng 1 – Khởi tạo Chuẩn hóa: Tạo lập kho học liệu AI tương ứng ba nhóm chuyên ngành bằng các mô hình LLM và multimodal hàng đầu kết hợp prompt chuẩn hóa. Mỗi bài học được tạo ra từ cùng một đề cương chi tiết, với prompt yêu cầu AI tạo ra học liệu đa phương thức (văn bản, đồ họa, slide, kịch bản tương tác).
Vòng 2 – Chuyên gia Mù đôi (Double-blind Expert Review): Hội đồng 5 chuyên gia giáo dục và thiết kế bài giảng số (tối thiểu 10 năm kinh nghiệm) đánh giá độc lập các gói học liệu đã được ẩn mã định danh nguồn gốc tạo lập (AI vs. Chuyên gia). Mỗi chuyên gia đánh giá tất cả 30 bài học theo rubric năm chiều. Độ tin cậy đồng thuận giữa các chuyên gia được kiểm định bằng hệ số Fleiss’ Kappa hoặc Cohen’s Kappa.
Vòng 3 – Thực nghiệm Tiếp nhận Người học: 100 sinh viên tham gia học tập trực tuyến ngẫu nhiên theo mô hình luân phiên (mỗi sinh viên học cả bài do AI tạo và bài do chuyên gia thiết kế, theo thứ tự ngẫu nhiên để kiểm soát hiệu ứng thứ tự). Đo lường hiệu ứng học tập (pre-test/post-test), tải nhận thức cảm nhận (NASA-TLX), và trải nghiệm thực tế (khảo sát Likert và phỏng vấn sâu).
4.4. Ba Giả thuyết Nghiên cứu (Three Propositions)
H1 (Khoảng cách Chất lượng Sư phạm): Học liệu AI thuần túy đạt điểm cao ở tính sẵn sàng, thẩm mỹ giao diện và tính khả dụng, nhưng thấp hơn có ý nghĩa thống kê (p < 0,05) ở chiều Độ chính xác chuyên sâu và Giá trị Sư phạm so với học liệu do chuyên gia thiết kế. Cơ sở: Mehboob et al. (2026) cho thấy câu hỏi do AI tạo ra dễ hơn và kém phân biệt hơn câu hỏi do con người tạo .
H2 (Đứt gãy Chiều sâu Nhận thức): Học liệu AI có xu hướng bám sát bề mặt kiến thức, dàn trải, thiếu cấu trúc dẫn dắt giàn giáo nhận thức (scaffolding) và thiếu hụt các câu hỏi kích thích phản biện đa chiều (HOTS). Cơ sở: chỉ số phân biệt thấp hơn của AI cho thấy AI thiếu khả năng chẩn đoán chiều sâu hiểu biết; nghiên cứu về chatbot và tải nhận thức cảnh báo rằng khi người học ủy thác bài tập cho chatbot, họ có thể bỏ lỡ tải nhận thức hữu ích cần thiết cho việc hình thành lược đồ nhận thức.
H3 (Hiệu quả của Đồng kiến tạo Human–AI): Quy trình đồng kiến tạo Human–AI (bốn giai đoạn) giúp cải thiện điểm số sư phạm của học liệu AI từ mức Trung bình lên mức Xuất sắc sau hai vòng kiểm chuẩn. Cơ sở: Dogan (2025) cho thấy giáo viên báo cáo cải thiện về căn chỉnh, sáng tạo và hiệu quả khi sử dụng mô hình đồng kiến tạo.
5. PHƯƠNG PHÁP NGHIÊN CỨU (RESEARCH METHODOLOGY)
5.1. Thiết kế (Design)
Nghiên cứu sử dụng thiết kế thực nghiệm so sánh có kiểm soát (Quasi-experimental / Controlled Comparative Design) kết hợp phương pháp hỗn hợp (Mixed Methods). Thiết kế này cho phép so sánh trực tiếp chất lượng sư phạm của học liệu do AI tạo ra và học liệu do chuyên gia thiết kế, đồng thời khám phá các yếu tố ảnh hưởng đến chất lượng thông qua dữ liệu định tính.
Đạo đức nghiên cứu: Nghiên cứu sẽ được phê duyệt bởi hội đồng đạo đức của trường. Tất cả người tham gia ký informed consent và được thông báo về quyền rút khỏi nghiên cứu bất cứ lúc nào. Dữ liệu sẽ được mã hóa và lưu trữ bảo mật. Hiệu ứng Hawthorne được kiểm soát bằng cách không thông báo cho sinh viên biết giả thuyết nghiên cứu cụ thể.
Xử lý dữ liệu thiếu: Dữ liệu được thu thập qua nền tảng LMS tự động, với tỷ lệ thiếu dự kiến < 5% cho các biến kết quả chính; sinh viên bỏ học giữa chừng sẽ được xử lý theo nguyên tắc intention-to-treat (ITT). Multiple imputation được sử dụng nếu tỷ lệ thiếu dưới 10%, hoặc phân tích độ nhạy nếu tỷ lệ thiếu cao hơn.
Xử lý dữ liệu định tính: Với phỏng vấn sâu (20 sinh viên), nếu người tham gia rút giữa chừng, ghi nhận lý do và không thay thế để bảo toàn tính tự nhiên của dữ liệu; phân tích chủ đề được thực hiện trên dữ liệu sẵn có, với ghi chú về giới hạn.
5.2. Mẫu (Sample)
Mẫu học liệu: 30 đơn vị bài học trực tuyến đa phương thức thuộc ba lĩnh vực (Khoa học tự nhiên, Khoa học xã hội, STEM ứng dụng); chia thành 15 bài do AI tạo dựng và 15 bài do giảng viên kỳ cựu thiết kế theo cùng đề cương chi tiết. Mỗi bài học bao gồm văn bản, đồ họa, slide bài giảng, và kịch bản tương tác.
Khách thể thẩm định chuyên gia: 5 chuyên gia giáo dục và thiết kế bài giảng số giàu kinh nghiệm (tối thiểu 10 năm kinh nghiệm), được chọn theo tiêu chí: có kinh nghiệm thiết kế học liệu trực tuyến, am hiểu lý thuyết học tập đa phương tiện và tải nhận thức, và chưa từng tham gia thiết kế các bài học trong mẫu.
Khách thể người học: 100 sinh viên tham gia học tập trực tuyến ngẫu nhiên theo mô hình luân phiên. Tiêu chí chọn mẫu: sinh viên năm hai trở lên, có kinh nghiệm học trực tuyến, và chưa từng học các nội dung trong mẫu.
5.3. Công cụ và Kỹ thuật Phân tích Dữ liệu (Instruments and Analysis)
Thống kê mô tả và kiểm định độ tin cậy đồng thuận: Hệ số Fleiss’ Kappa được tính cho từng chiều (1–5) và cho tổng điểm; ngưỡng chấp nhận κ ≥ 0,70 cho mỗi chiều. Nếu κ < 0,70 ở chiều nào, hai chuyên gia sẽ thảo luận để thống nhất tiêu chí và chấm lại 20% bài ở chiều đó. ▸ [RB-01]
Kiểm định khác biệt phi tham số: Mann-Whitney U Test hoặc Independent Samples T-Test được sử dụng để so sánh điểm số năm chiều giữa hai nhóm học liệu. Do cỡ mẫu nhỏ (15 bài mỗi nhóm) và dữ liệu có thể không phân phối chuẩn, Mann-Whitney U Test được ưu tiên. Mức ý nghĩa được đặt ở p < 0,05.
Phân tích stratified theo lĩnh vực: Do học liệu thuộc ba lĩnh vực (Khoa học tự nhiên, Khoa học xã hội, STEM ứng dụng), phân tích stratified được thực hiện để kiểm tra hiệu ứng điều tiết của domain — tức là liệu khoảng cách chất lượng giữa AI và chuyên gia có khác nhau tùy lĩnh vực. Nếu cỡ mẫu mỗi lĩnh vực quá nhỏ (10 bài/lĩnh vực), báo cáo mô tả và thảo luận định tính thay vì kiểm định thống kê.
Phân tích định tính nội dung phản hồi mở: Phân tích chủ đề (Thematic Analysis) từ nhật ký chuyên gia và khảo sát chiều sâu từ người học, tập trung vào các yếu tố ảnh hưởng đến chất lượng sư phạm của học liệu AI và hiệu quả của quy trình đồng kiến tạo.
6. KẾT QUẢ DỰ KIẾN (ANTICIPATED RESULTS)
Lưu ý: Toàn bộ Mục 6 trình bày kết quả dự kiến (anticipated results) suy luận từ khung lý thuyết và bằng chứng y văn, không phải kết quả thực nghiệm đã quan sát.
6.1. Kết quả 1: Khoảng cách Chất lượng Sư phạm
Dựa trên bằng chứng từ Mehboob et al. (2026) , dự kiến học liệu AI thuần túy đạt điểm cao ở tính sẵn sàng, thẩm mỹ giao diện và tính khả dụng, nhưng thấp hơn có ý nghĩa thống kê (p < 0,05) ở chiều Độ chính xác chuyên sâu và Giá trị Sư phạm so với học liệu do chuyên gia thiết kế. Cụ thể, dự kiến điểm trung bình chiều 1 (Độ chính xác) của nhóm AI thấp hơn nhóm chuyên gia khoảng 0,5–0,8 điểm trên thang 5, và chiều 2 (Giá trị Sư phạm) thấp hơn khoảng 0,4–0,7 điểm. ▸ [IC-01] Tương đương effect size Cohen’s d ≈ 0,4–0,6 (mức trung bình), với khoảng tin cậy 95% không chứa 0. ▸ [IC-06] Dự báo này nhất quán với SMD +0,541 (độ khó) và −0,701 (chỉ số phân biệt) từ Mehboob et al. (2026). Tuy nhiên, cần lưu ý rằng phân tích tổng hợp cho thấy không có khác biệt tổng thể giữa AI và con người khi gộp chung các chiều, nhưng khác biệt có ý nghĩa khi phân tích riêng từng chiều . Điều này củng cố dự đoán rằng khoảng cách chất lượng không đồng đều mà tập trung ở chiều sâu chẩn đoán.
6.2. Kết quả 2: Đứt gãy Chiều sâu Nhận thức
Dựa trên phát hiện về chỉ số phân biệt thấp hơn của AI và nghiên cứu về chatbot và tải nhận thức, dự kiến học liệu AI có xu hướng bám sát bề mặt kiến thức, dàn trải, thiếu cấu trúc dẫn dắt giàn giáo nhận thức và thiếu hụt các câu hỏi kích thích phản biện đa chiều (HOTS). Phân tích định tính dự kiến sẽ xác định ba chủ đề chính: (1) AI tạo ra nhiều hoạt động nhưng thiếu kết nối logic giữa các hoạt động; (2) AI thiếu khả năng dự đoán khó khăn nhận thức của người học để điều chỉnh giàn giáo; (3) AI có xu hướng tạo ra câu hỏi ở mức độ nhận biết-thông hiểu thay vì phân tích-đánh giá-sáng tạo.
6.3. Kết quả 3: Đánh giá từ Trải nghiệm Sinh viên
Dựa trên phát hiện từ nghiên cứu so sánh MCQ, dự kiến người học đánh giá cao tính hấp dẫn thị giác ban đầu của sản phẩm AI nhưng phản hồi gặp khó khăn trong việc tự học các khái niệm trừu tượng nếu không có sự can thiệp sư phạm định hướng từ giảng viên. Cụ thể, dự kiến điểm hài lòng với tính thẩm mỹ của học liệu AI cao hơn nhóm chuyên gia (khoảng 4,0 so với 3,7), nhưng điểm hài lòng với “mức độ hỗ trợ học tập” thấp hơn (khoảng 3,2 so với 4,0). ▸ [IC-05]
6.4. Kết quả 4: Khung Quy trình Tối ưu hóa
Dựa trên mô hình Human–AI Hybrid Co-Design và bằng chứng về hiệu quả của đồng kiến tạo, dự kiến đề xuất bộ ma trận hướng dẫn tích hợp “Human-in-the-loop” giúp cải thiện điểm số sư phạm của học liệu AI từ mức Trung bình (khoảng 3,0) lên mức Xuất sắc (khoảng 4,3) sau hai vòng kiểm chuẩn. Quy trình này bao gồm: (1) Human-led prompt engineering với yêu cầu cụ thể về cấu trúc giàn giáo; (2) Human-led verification với checklist kiểm tra HOTS; (3) Human–AI iterative refinement với phản hồi từ chuyên gia.
7. THẢO LUẬN (DISCUSSION)
7.1. Vai trò Bất biến của Chuyên gia Sư phạm
Kết quả dự kiến của nghiên cứu có hàm ý quan trọng: trí tuệ nhân tạo chỉ đóng vai trò là “bộ khuếch đại năng suất” (productivity multiplier), trong khi năng lực sư phạm cốt lõi và đạo đức học thuật của nhà giáo đóng vai trò quyết định giá trị tri thức. Bằng chứng từ Mehboob et al. (2026) cho thấy mặc dù AI có thể tạo ra câu hỏi dễ tiếp cận hơn, nhưng chỉ số phân biệt kém hơn có nghĩa là AI không thể thay thế chức năng chẩn đoán của đánh giá sư phạm. Đánh giá của chuyên gia vẫn rất quan trọng để đảm bảo độ rõ ràng và căn chỉnh với mục tiêu chương trình học. Điều này phù hợp với định hướng của UNESCO (2023) về giáo dục lấy con người làm trung tâm .
▸ Hàm ý lý thuyết của H2: Nếu H2 được xác nhận, điều này có ý nghĩa quan trọng đối với cách hiểu về vai trò của AI trong thiết kế học liệu. Cụ thể, AI có thể là công cụ tạo nội dung (content generation) nhưng không thể thay thế chức năng thiết kế trải nghiệm học tập có chiều sâu chẩn đoán (diagnostic depth). Điều này giải thích tại sao nhiều học liệu AI “trông đẹp” và “dễ tiếp cận” nhưng không hiệu quả trong việc phát triển HOTS — chúng thiếu cấu trúc giàn giáo và câu hỏi chẩn đoán. Hàm ý chính sách là: đầu tư vào AI để tạo học liệu cần đi kèm với đầu tư vào năng lực thiết kế sư phạm của giảng viên — người có thể “nâng cấp” học liệu AI từ mức “tạo nội dung” lên mức “thiết kế trải nghiệm học tập.”
7.2. Hàm ý Chính sách và Đào tạo Giảng viên
Nghiên cứu có ba hàm ý chính sách. Thứ nhất, cần chuyển đổi trọng tâm tập huấn giảng viên từ kỹ năng số cơ bản sang “năng lực đánh giá sư phạm đối với sản phẩm AI” (AI Pedagogical Literacy). Điều này bao gồm khả năng đánh giá học liệu AI theo rubric năm chiều, thiết kế prompt để yêu cầu AI tạo ra học liệu có cấu trúc sư phạm, và nhận diện các dấu hiệu “đứt gãy sư phạm” trong học liệu AI. Thứ hai, cần thể chế hóa quy trình đồng kiến tạo Human–AI thành quy chuẩn kỹ thuật cấp cơ sở giáo dục, với checklist và rubric cụ thể. Thứ ba, cần đầu tư vào năng lực thẩm định của chuyên gia để họ có thể đánh giá học liệu AI một cách khách quan và nhất quán.
▸ Quy trình Đồng kiến tạo Human–AI bốn giai đoạn (Four-Phase Human–AI Co-creation):
- Human-led Planning: Giảng viên xác định mục tiêu sư phạm, thiết lập prompt với yêu cầu cụ thể về cấu trúc giàn giáo và HOTS.
- AI-assisted Generation: AI tạo học liệu đa phương thức theo prompt đã thiết lập.
- Human-led Verification: Giảng viên/chuyên gia rà soát khoa học (kiểm tra ảo giác, độ chính xác thuật ngữ) và chuẩn hóa sư phạm (kiểm tra HOTS, giàn giáo, căn chỉnh mục tiêu), lọc bỏ định kiến.
- Adaptive Deployment: Triển khai, đo lường hiệu ứng học tập và tải nhận thức, tinh chỉnh vòng lặp dựa trên phản hồi.
▸ [RB-03] Rào cản thể chế: Một rào cản thể chế chưa được thảo luận đầy đủ là Thông tư 54/2026 đã tạo cơ sở pháp lý cho yêu cầu năng lực số và AI trong chuẩn đầu ra, nhưng chưa có quy định cụ thể về rubric đánh giá học liệu AI trong quy trình kiểm định chất lượng. Điều này tạo ra khoảng trống giữa yêu cầu chính sách và thực tiễn triển khai — giảng viên được yêu cầu tích hợp AI nhưng không có công cụ chuẩn hóa để đánh giá chất lượng học liệu AI. Nghiên cứu này hướng đến lấp đầy khoảng trống đó bằng rubric năm chiều.
7.3. Đối sánh Quốc tế
Các phát hiện dự kiến của nghiên cứu có điểm tương đồng và khác biệt so với các chuẩn mực quốc tế. UNESCO (2023) nhấn mạnh cách tiếp cận lấy con người làm trung tâm và yêu cầu các tổ chức giáo dục thẩm định công cụ AI về mặt đạo đức và sư phạm trước khi sử dụng . OECD AI Literacy Framework (2026, phiên bản cuối) tập trung vào bốn lĩnh vực: tương tác với AI, sáng tạo với AI, quản lý AI, và định hình AI, nhấn mạnh siêu nhận thức và phản tư . Khung rubric năm chiều của nghiên cứu này bổ sung chiều “Giá trị Sư phạm & Nhận thức” và “Tính Đa dạng & Nhân văn” mà các khung quốc tế chưa tích hợp đầy đủ vào quy trình đánh giá học liệu cụ thể. Đặc biệt, bằng chứng định lượng về khoảng cách chẩn đoán (discrimination gap) giữa AI và con người cung cấp cơ sở khoa học vững chắc cho lập luận rằng đánh giá sư phạm không thể chỉ dừng ở “cảm nhận tương đương.”
8. KẾT LUẬN (CONCLUSION)
Nghiên cứu này đề xuất Khung Rubric Sư phạm Năm chiều để đánh giá chất lượng sư phạm của học liệu đa phương thức do AI tạo ra trong dạy học trực tuyến, dựa trên Thuyết Học tập Đa phương tiện của Mayer (2021), Thuyết Tải nhận thức của Sweller và cộng sự (2019), các mô hình thiết kế sư phạm tích hợp (ADDIE, UbD, 5E), và mô hình Human–AI Co-creation. Khung này bao gồm năm chiều: Độ chính xác khoa học & Tin cậy, Giá trị Sư phạm & Nhận thức, Khả năng Tiếp cận & Hòa nhập, Tính Khả dụng & Trải nghiệm Giao diện, và Tính Đa dạng & Nhân văn.
Đóng góp lý thuyết của nghiên cứu là tích hợp các lý thuyết học tập thực chứng vào quy trình đánh giá học liệu AI, chuyển dịch từ thẩm định kỹ thuật thuần túy sang thẩm định sư phạm tích hợp, đồng thời kết nối với bằng chứng định lượng từ Mehboob et al. (2026) về khoảng cách chẩn đoán giữa AI và con người. Đóng góp thực tiễn là cung cấp quy trình đồng kiến tạo Human–AI bốn giai đoạn, giúp giảng viên và chuyên gia thiết kế có thể tích hợp AI vào quy trình sản xuất học liệu mà không đánh đổi chất lượng sư phạm.
Ba giả thuyết được đề xuất để kiểm định: (H1) học liệu AI thấp hơn có ý nghĩa thống kê ở chiều Độ chính xác và Giá trị Sư phạm; (H2) học liệu AI có xu hướng bám sát bề mặt kiến thức và thiếu HOTS; (H3) quy trình đồng kiến tạo Human–AI cải thiện điểm số sư phạm từ Trung bình lên Xuất sắc. Các giả thuyết này cần được kiểm chứng qua thực nghiệm tại một trường đại học Việt Nam trong giai đoạn 2020–2026.
Hướng nghiên cứu tương lai bao gồm: mở rộng nghiên cứu trên các mô hình AI thế hệ mới (multimodal LLM, agentic AI); thể chế hóa rubric đánh giá thành quy chuẩn kỹ thuật cấp cơ sở giáo dục; và xây dựng chương trình bồi dưỡng năng lực thẩm định học liệu AI chuyên sâu cho đội ngũ nhà giáo. Câu hỏi xuyên suốt là: làm thế nào để AI trở thành công cụ khuếch đại năng suất của chuyên gia sư phạm, không phải vật thay thế phán đoán sư phạm của con người.
TUYÊN BỐ ĐÓNG GÓP CỦA TÁC GIẢ (CRediT AUTHORSHIP STATEMENT)
Nguyễn Văn Hùng: Ý tưởng nghiên cứu cốt lõi (Conceptualization); Thiết lập phương pháp luận và cơ sở lý thuyết Mayer, Sweller, ADDIE/UbD/5E, Human–AI Co-creation (Methodology & Theoretical Development); Xây dựng Khung Rubric Năm chiều và quy trình đánh giá ba vòng (Framework Architecture & Propositions); Tích hợp bằng chứng từ UNESCO, OECD, Mehboob et al. (2026), Dogan (2025), PedaCo-Gen (Baek et al., 2026) (Evidence Integration); Thiết kế thực nghiệm kiểm định (Experimental Design); Soạn thảo toàn văn bản thảo (Writing – Original Draft); Rà soát, hiệu đính học thuật và chuẩn hóa APA 7 (Writing – Review & Editing); Quản trị dự án nghiên cứu (Project Administration).
TÀI LIỆU THAM KHẢO (REFERENCES – APA 7TH EDITION)
Baek, I., Kim, Y., & Kwak, N. (2026). PedaCo-Gen: Scaffolding pedagogical agency in human–AI collaborative video authoring. In Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (Article 506, pp. 1–11). Association for Computing Machinery. https://doi.org/10.1145/3772363.3798741
Dogan, S. (2025). A Human-AI hybrid co-design model: Planning effective instruction with ChatGPT. Asian Journal of Distance Education, 20(1), 94–119.
Gutiérrez Carreón, G., & López Escalera, R. (2025). Evaluating usability and cognitive load in programming education with ChatGPT integration. OASIcs, 133, 12:1–12:7. https://doi.org/10.4230/OASIcs.ICPEC.2025.12
Mayer, R. E. (2021). Multimedia learning (3rd ed.). Cambridge University Press.
Mehboob, B., Bandy, A., Shabbir, M., et al. (2026). Quality of AI vs human-generated single best answer questions: A systematic review and meta-analysis. Medičnì Perspektivi, 31(2), 135–148. https://doi.org/10.26641/2307-0404.2026.2.365915
OECD. (2026). AI literacy framework for primary and secondary education (Final version). OECD Publishing.
Sweller, J., van Merriënboer, J. J. G., & Paas, F. (2019). Cognitive architecture and instructional design: 20 years later. Educational Psychology Review, 31(2), 261–292. https://doi.org/10.1007/s10648-019-09465-5
UNESCO. (2023). Guidance for generative AI in education and research. UNESCO Publishing. https://unesdoc.unesco.org/ark:/48223/pf0000386693
Wiggins, G., & McTighe, J. (2005). Understanding by design (2nd ed.). ASCD.
Bộ Giáo dục và Đào tạo. (2025). Thông tư số 02/2025/TT-BGDĐT ngày 24 tháng 01 năm 2025 quy định Khung năng lực số cho người học. https://vanban.chinhphu.vn/?pageid=27160&docid=212648
PHỤ LỤC (APPENDIX)
Phụ lục A: Bảng Tiêu chí Chi tiết Rubric Năm chiều
(Mô tả bảng: Mỗi chiều được chia thành 5 mức (1–5), với chỉ báo hành vi cụ thể cho từng mức. Ví dụ, chiều “Giá trị Sư phạm & Nhận thức”: Mức 1 – Không có cấu trúc sư phạm, chỉ liệt kê nội dung; Mức 3 – Có cấu trúc cơ bản nhưng thiếu giàn giáo và HOTS; Mức 5 – Cấu trúc rõ ràng, có giàn giáo nhận thức, kích thích HOTS và phản tư.)
Phụ lục B: Bộ Prompt Chuẩn hóa dùng để Khởi tạo 15 Bài học AI Đa phương thức
(Mô tả: Prompt được thiết kế để yêu cầu AI tạo ra học liệu đa phương thức từ cùng một đề cương, với các yêu cầu cụ thể về cấu trúc, giàn giáo, và HOTS. Ví dụ: “Tạo một bài học trực tuyến về [chủ đề] bao gồm: (1) văn bản giải thích khái niệm cốt lõi; (2) đồ họa minh họa mối quan hệ nhân quả; (3) 3 câu hỏi ở mức độ phân tích; (4) một hoạt động yêu cầu người học áp dụng khái niệm vào tình huống mới.”)
Phụ lục C: Phiếu Khảo sát Trải nghiệm Nhận thức của Sinh viên (Online Learning Experience Questionnaire)
(Mô tả: Khảo sát Likert 5 điểm với 15 mục, bao gồm: mức độ rõ ràng của học liệu, mức độ hấp dẫn thị giác, mức độ hỗ trợ học tập, mức độ khó nhận thức cảm nhận, và mức độ hài lòng tổng thể.)
Phụ lục D: Bảng Đối chiếu Độ tin cậy giữa các Chuyên gia Thẩm định (Fleiss’ Kappa Analysis Matrix)
(Mô tả: Ma trận thể hiện mức độ đồng thuận giữa 5 chuyên gia trên từng chiều đánh giá, với hệ số Kappa và khoảng tin cậy 95%.)
Phụ lục E: Rubric Đo lường HOTS ▸ [IC-02]
| Mức Bloom | Mô tả | Ví dụ câu hỏi |
| 1. Nhớ | Nhận biết, ghi nhớ thông tin | “Định nghĩa X là gì?” |
| 2. Hiểu | Diễn giải, giải thích | “Giải thích tại sao X xảy ra?” |
| 3. Áp dụng | Sử dụng trong tình huống mới | “Áp dụng X để giải quyết Y” |
| 4. Phân tích | Phân tách, so sánh, đối chiếu | “So sánh X và Y, chỉ ra điểm khác biệt” |
| 5. Đánh giá | Phán đoán, phê bình | “Đánh giá tính hợp lý của lập luận X” |
| 6. Sáng tạo | Thiết kế, xây dựng | “Thiết kế một giải pháp mới cho X” |
HOTS = mức 4–6. Tần suất HOTS = số câu hỏi mức 4–6 / tổng số câu hỏi.
